Visual Multi-Agent System: Mitigating Hallucination Snowballing via Visual Flow
(ICLR 2026)
motivation
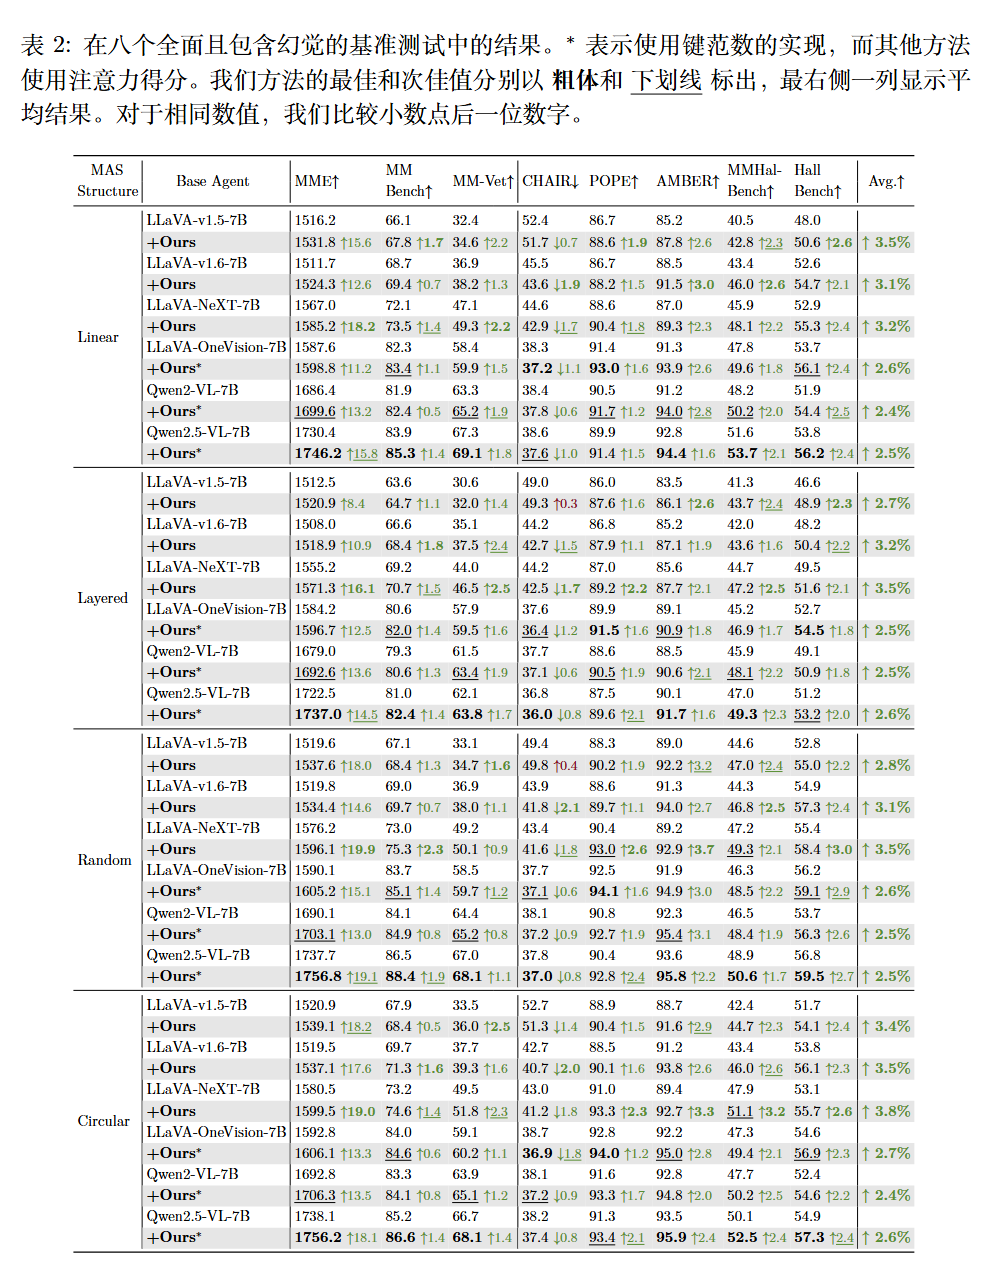
这篇论文探讨了基于视觉语言模型(VLMs)的多智能体系统(MAS)中存在的一个新挑战,即“多智能体视觉幻觉雪球效应”(multi-agent visual hallucination snowballing)。 该效应的产生机制如下:
- 在单个智能体中产生的幻觉,会因为后续智能体过度依赖“文本流”(textual flow)来传递视觉信息而被不断放大。
- 现有的文本传递方式会压缩并选择性地强调视觉特征,导致后续智能体将前序智能体产生的错误文本断言视为权威,从而产生滚雪球般的幻觉放大效应。
- 仅仅减少单个智能体的内部幻觉(以往大部分研究的重点)无法完全解决这种在多智能体交互间传播的幻觉问题。
分析
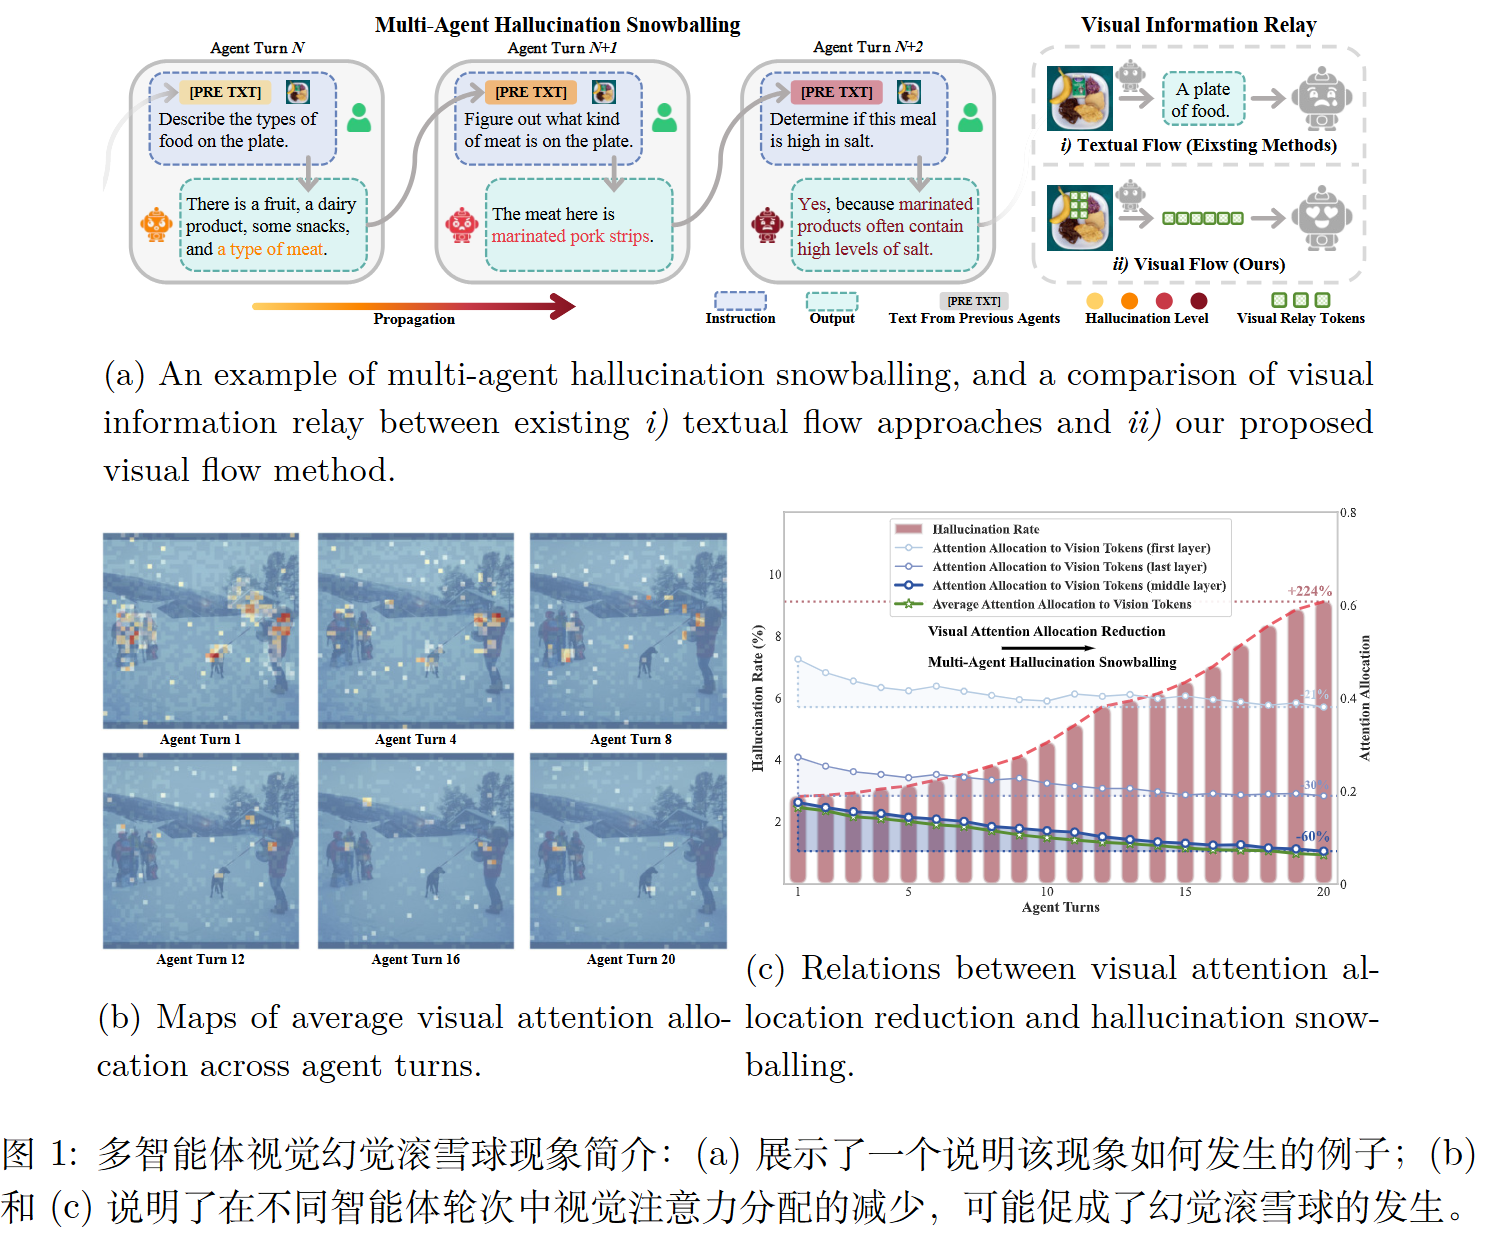
为了探究视觉失真在多智能体间是如何发生的,作者对注意力机制(涵盖轮次、层级和词元层面)进行了详细诊断:
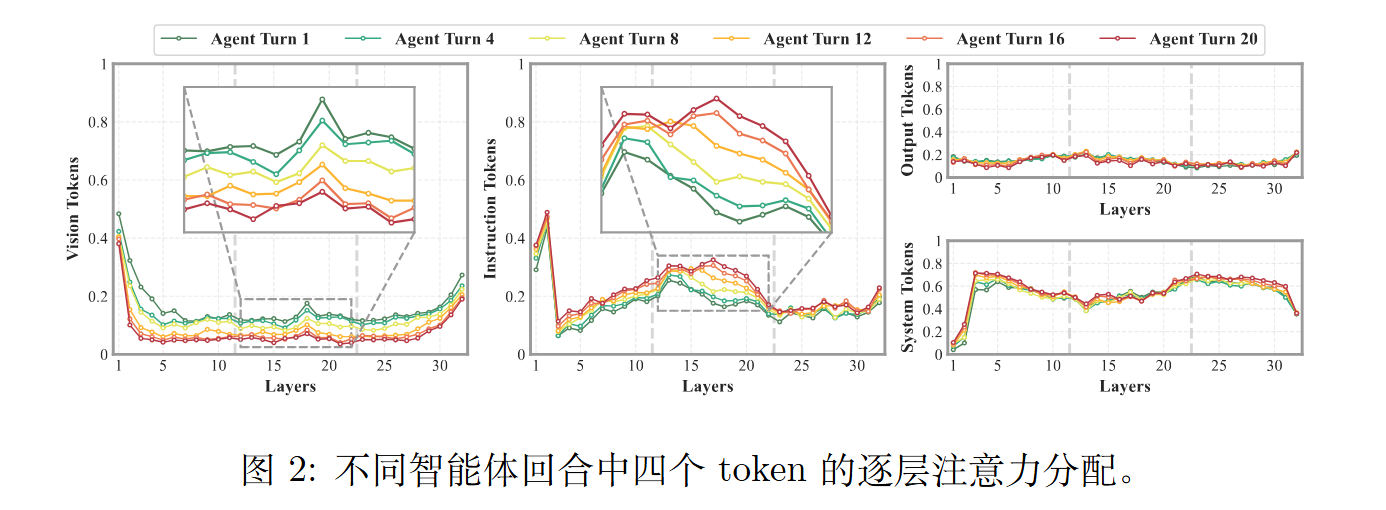
- 随着智能体作轮次的增加,模型分配给视觉词元(vision tokens)的平均注意力会逐渐减少,而分配给指令词元(instruction tokens)的注意力则相应增加。
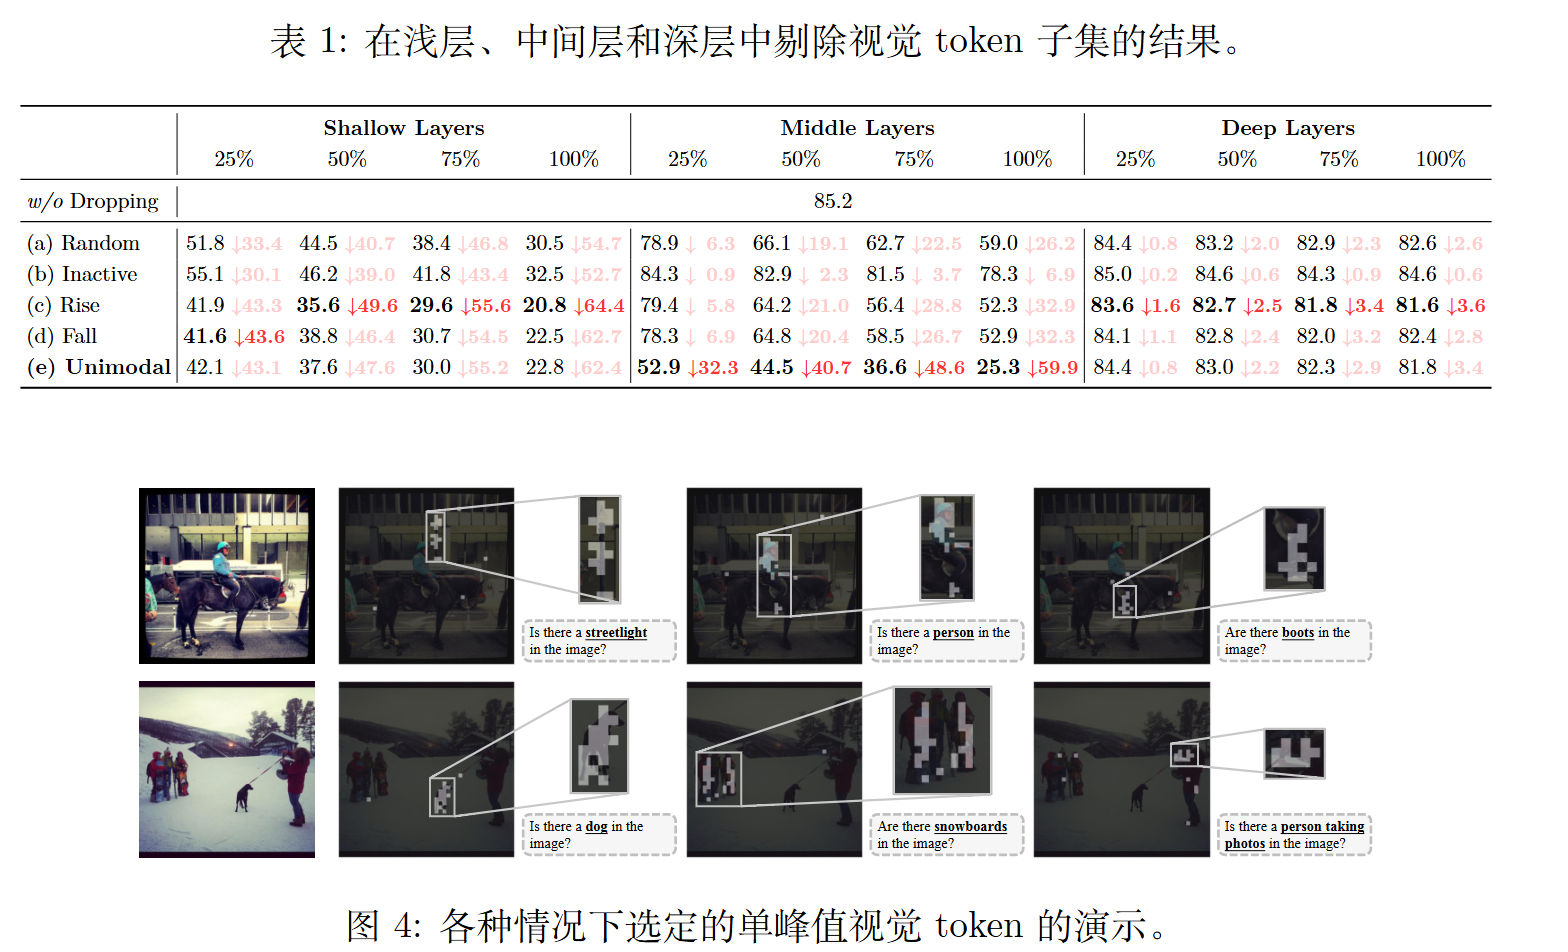
- 在模型的中间层(middle layers)中,存在一小部分具有“单峰注意力特征”(unimodal attention peak)的视觉词元,这些词元能够最好地保留视觉特定信息。
- 在浅层和深层网络中,所有的视觉词元几乎同样重要或同样不重要,但在中间层,具有单峰特征的视觉词元在视觉与文本的信息交互中起着至关重要的作用。
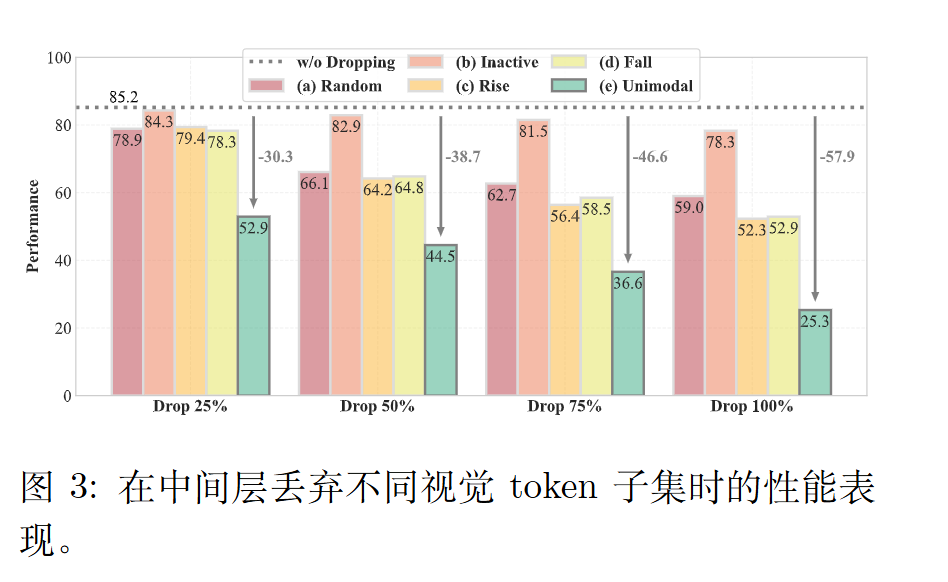
- 然而,这种极其重要的单峰特征在更深轮次的智能体中会逐渐消失,这表明文本信息流逐渐占据主导地位,视觉信号被忽略,进而导致了幻觉雪球效应。
方法
视觉信息中继
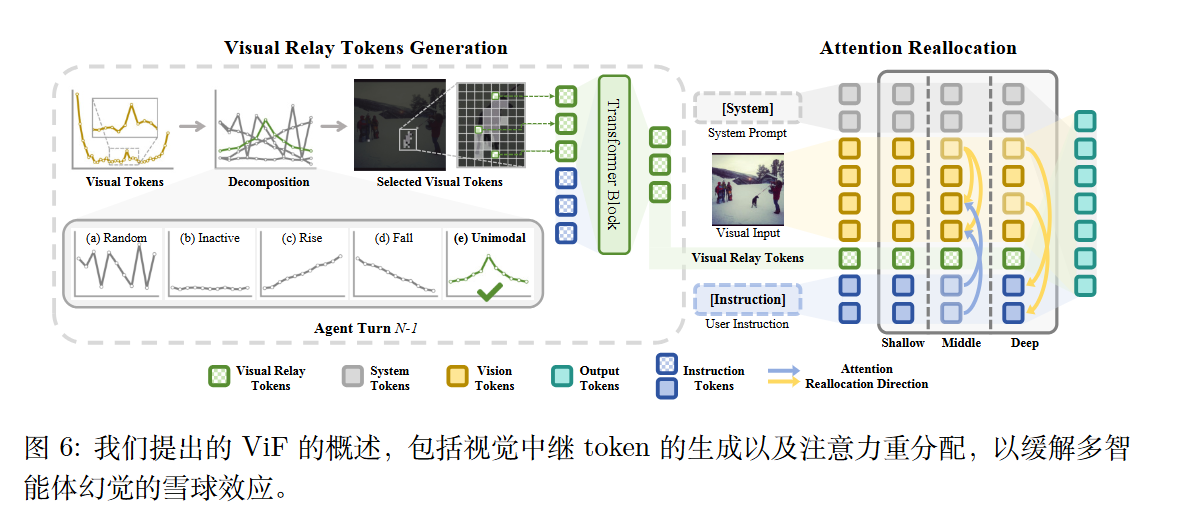
现有的多智能体系统在传递上一轮视觉信息时,通常只依赖生成的文本流,这会丢失大量视觉特征。为了解决这个问题,ViF 引入了额外的“视觉流”(Visual Flow)。
提取中继词元: 首先,将所有的视觉词元(vision tokens)表示为 $\mathcal{V}={v_{1},…,v_{m}}$。作者根据中间层的注意力分配趋势,从中挑选出具有“单峰形态”(unimodal morphology)的视觉词元,作为初始的视觉中继词元,记为 $\mathcal{R}={r_{1},…,r_{n}}\subset\mathcal{V}$,其中 $n\ll m$。
上下文融合与特征对齐: 因为原始选出的视觉词元缺乏特定的语义,所以作者利用指令词元(instruction tokens,记为 $\mathcal{I}$)对这些初始中继词元进行上下文融合。具体公式为:
$$\hat{\mathcal{R}}=f(\mathcal{R}\oplus\mathcal{I})[:n]$$
其中 $f(\cdot)$ 是一个轻量级的 Transformer 块,$\oplus$ 表示拼接(concatenation)操作。这里提取了前 $n$ 个组件,以保持视觉中继词元初始的长度不变。
传递与整合: 为了保留视觉中继词元的空间信息,该方法采用了与前序智能体相同的位置编码策略。随后,这些处理好的视觉中继词元 $\hat{\mathcal{R}}$ 会被传递给后续的智能体,并插入在原始视觉词元和指令词元之间输入给最终的大型语言模型(LLM)。
注意力重新分配
由于不同类型的词元在模型的浅层、中层和深层起着不同的作用,ViF 引入了注意力重新分配机制,以激活视觉中继词元并优化注意力分布。
放大单峰注意力趋势: 在模型的中间层,为了促使具备单峰形态的视觉词元更好地显现,作者在 Softmax 操作中加入了温度缩放(temperature scaling),以放大注意力的动态(上升和下降)趋势。公式如下:
$$\mathcal{A}=Softmax_{\tau}(\mathcal{S})=\frac{exp(\frac{s}{\tau})}{\sum_{i=1}^{m}exp(\frac{s_{i}}{\tau})}$$
其中 $\tau$ 是温度参数,$\mathcal{S}$ 和 $s$ 分别代表注意力分数矩阵和注意力分数,$\mathcal{A}$ 是缩放后的注意力矩阵。
中间层的注意力收集与再分配: 在中间层,系统会收集“非活跃视觉词元”和“指令词元”的注意力,然后将其重新分配给其他有用的视觉词元。具体分为收集(Collection)和重分配(Reallocation)两步公式:
$$\mathcal{C}=\alpha\sum_{i=1}^{m}s_{i}\circ M_{c},\quad M_{c}(i,j)=\mathbb{I}((i\in\mathcal{T},j\in\mathcal{V}_{\emptyset})\vee(i\in\mathcal{T},j\in\mathcal{I}))$$
$$\hat{s}=s+\frac{s}{\sum_{i=1}^{l}s_{i}}\mathcal{C}\circ M_{r},\quad M_{r}(i,j)=\mathbb{I}(i\in\mathcal{T},j\in\mathcal{V}_{\emptyset})$$
这里的 $\mathcal{T}$ 代表所有词元集合,$\mathcal{V}{\emptyset}$ 是非活跃视觉词元集合,$\mathcal{V}{\emptyset}$(即 $\mathcal{V}-\mathcal{V}{\emptyset}$,共 $l$ 个词元)是接收重新分配注意力的活跃视觉词元集合。$M{c}$ 和 $M_{r}$ 分别是收集和重分配掩码矩阵,$\alpha$ 是重分配系数。
深层的注意力重分配: 在深层网络中,因为视觉词元的作用变小,重新分配的方向反转为从“视觉词元”流向“指令词元”,并且使用相同的处理流程。在这个过程中,始终保证总注意力之和为 1。
基于注意力分数的替代方案
- 适用场景: 目前一些新发布的模型(如采用 Flash-Attention 2/3 机制的模型)为了加速计算并减少内存消耗,其注意力分数(attention scores)是不可直接获取的。
- Key-Norm 策略: 针对此问题,作者设计了一种基于 Key-Norm(键矩阵的 $L_2$ 范数)的替代方法。$L_2$ 范数能够反映词元的特征强度,值越高说明词元的语义越显著。选择 $L_2$ 范数而不是 $L_1$ 范数,是为了更好地放大词元之间的差异。
- 引入缓冲词元: 考虑到纯粹基于 Key-Norm 选择的词元覆盖较为稀疏、可能会丢失部分重要视觉语义,作者在初始选定的词元周围引入了额外的“缓冲词元”(buffer tokens),即在 $3\times3$ 的空间范围内补充周围的词元(实验中默认添加 3 个缓冲词元)。这在保证运算效率的同时,维持了极其相近的性能和准确度。
实验