多个问题的Token 成本对比与决策公式
经常有一些零散的问题,但是总是迟疑是多开会话还是在会话中继续,做了一些实验来进行测试了一下。在eva.py上进行测试。
一、一句话结论
没有绝对答案,关键取决于“每个问题有多长”。
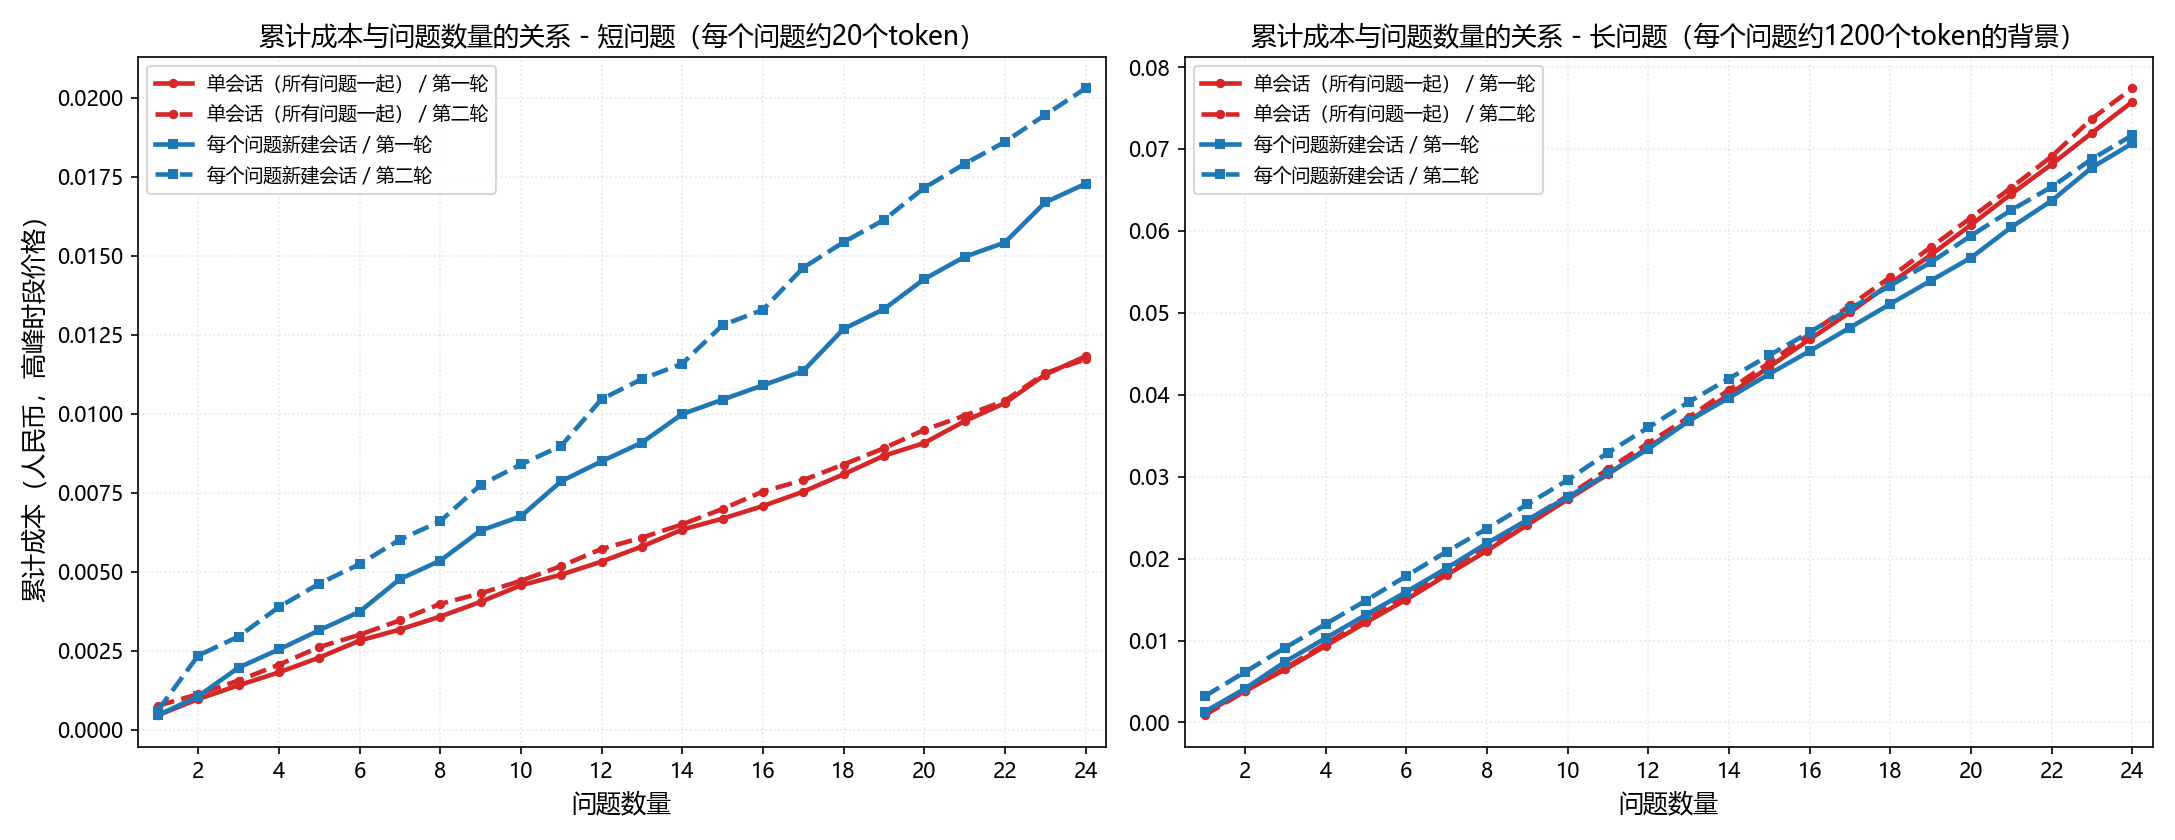
- 短问题:放在同一个会话里更省,成本约为独立会话的 0.6 倍。
- 长问题:全部放在一个会话里反而更贵,成本约为独立会话的 1.08 倍。
- 两种方案的成本曲线大约在 $N \approx 12\sim17$ 问附近交叉。
二、实测对比
测试条件:
- $N=24$
- 高峰价格
- 每个场景进行了两轮实验,并互换执行顺序
| 场景 | 一个会话问完 | 每问一个新会话 | 更省 |
|---|---|---|---|
| 短问题(约 20 tokens/问) | 0.01182 / 0.01172 元 | 0.01728 / 0.02030 元 | 一个会话省约 32%~42% |
| 长问题(约 2173 tokens/问) | 0.07576 / 0.07740 元 | 0.07069 / 0.07167 元 | 独立会话省约 7%~8% |
每格中的两个数字分别对应两轮互换顺序后的结果。
高峰价格:
- 缓存命中:0.04 元 / M tokens
- 缓存未命中:2 元 / M tokens
- 输出:8 元 / M tokens
三、机制:钱到底花在哪里
总成本近似为:
$$
C=\frac{
T_{\text{hit}}\times0.04
+
T_{\text{miss}}\times2
+
T_{\text{out}}\times8
}{10^6}
$$
其中:
- $T_{\text{hit}}$:缓存命中的输入 tokens
- $T_{\text{miss}}$:缓存未命中的输入 tokens
- $T_{\text{out}}$:输出 tokens
有四个关键事实。
1. 系统提示词不是主要问题
系统提示词约为 956 tokens。
虽然每次请求都会重新发送,但它始终命中缓存,因此成本非常低:
$$
956\times \frac{0.04}{10^6}
$$
几乎可以忽略。
所以,真正的问题并不是“每次都要重新发送系统提示词”。
2. 单会话会不断重发历史,因此成本呈二次增长
在同一个会话中,第 $i$ 轮请求需要重新携带此前全部上下文。
虽然这些历史 tokens 通常都按缓存命中价计算:
$$
0.04\text{ 元/M}
$$
非常便宜,但历史长度会随着问题数 $N$ 线性增长。
因此累计重发量约为:
$$
1+2+\cdots+(N-1)
$$
也就是:
$$
O(N^2)
$$
准确地说,大约按:
$$
\frac{N^2}{2}
$$
增长。
而独立会话中,每次只重新发送系统提示,因此总成本基本是:
$$
O(N)
$$
3. 未命中 tokens 两种方案几乎一样
例如长问题实验中:
- 一个会话:约 30013 miss tokens
- 独立会话:约 29674 miss tokens
两边非常接近。
原因很简单:
每个新问题本身第一次出现时,都必须支付一次 cache miss。
无论是否新建会话,这部分都无法避免。
因此:
$$
\Delta T_{\text{miss}}\approx0
$$
可以近似认为在比较中抵消。
4. 单会话最大的收益来自“输出变短”
这是最重要的结构性差异之外的行为性收益。
在同一个会话中,模型会逐渐模仿自己之前的回答风格。
例如长问题实验:
- 一个会话总输出:146 tokens
- 独立会话总输出:1305 tokens
短问题实验:
- 一个会话总输出:168 tokens
- 独立会话总输出:837 tokens
也就是说:
同一个会话中,模型看到前面一直在用“极简回答”,后面的回答往往也会越来越短。
但需要注意:
- 输出节省量大约随 $N$ 线性增长
- 历史重发成本大约随 $N^2$ 增长
因此,当问题足够多时,二次增长最终会超过输出节省。
四、决策公式
定义:
- $N$:问题数量
- $Q$:每轮会话新增的 tokens,即“问题 + 回答”
- $D$:使用单会话后,平均每问节省的输出 tokens
- $p_h$:缓存命中价格
- $p_o$:输出价格
单会话额外产生的历史重发成本
近似为:
$$
C_{\text{history}}\approx\frac{N^2}{2}\cdot Q\cdot\frac{p_h}{10^6}
$$
单会话节省的输出成本
近似为:
$$
C_{\text{save}}\approx N\cdot D\cdot\frac{p_o}{10^6}
$$
令两者相等:
$$
\frac{N^2}{2}Qp_h=NDp_o
$$
得到交叉点:
$$
N^\ast=\frac{2p_o}{p_h}\cdot\frac{D}{Q}
$$
高峰价格下:
$$
p_o=8,\qquad p_h=0.04
$$
因此:
$$
\frac{2p_o}{p_h}=\frac{2\times8}{0.04}=400
$$
最终得到非常简单的决策公式:
$$
\boxed{N^\ast=400\frac{D}{Q}}
$$
五、实际判据
如果:
$$
\boxed{N<400\frac{D}{Q}}
$$
那么使用同一个会话通常更省。
如果:
$$
\boxed{N>400\frac{D}{Q}}
$$
那么每个问题开新会话通常更省。
实验结果:
| 场景 | $D$ | $Q$ | 理论 $N^\ast$ | 实测交叉 |
|---|---|---|---|---|
| 短问题 | $\sim28$ | $\sim34$ | $\sim330$ | 24 问内没有交叉 ✓ |
| 长问题 | $\sim48$ | $\sim1223$ | $\sim16$ | 约 12~17 问 ✓ |
这说明理论公式与实测结果基本一致。
公式推导
第 1 步:成本差只需要看三项
一次请求的成本为:
$$
C=\frac{T_{\text{hit}}p_h+T_{\text{miss}}p_m+T_{\text{out}}p_o}{10^6}$$
高峰价格:
$$
p_h=0.04,\qquadp_m=2,\qquad p_o=8
$$
比较“一个会话”和“独立会话”时,只需要关注三项差异:
| 项目 | 一个会话 | 独立会话 | 差值 |
|---|---|---|---|
| 未命中 | 每个新问题本身都要支付 | 基本一样 | $\approx0$,抵消 |
| 输出 | 较短,会模仿前文风格 | 较长,每问重新开始 | $-ND$ |
| 缓存命中 | 每轮重发全部历史 | 基本只重发系统提示 | $+\frac{QN^2}{2}$ |
其中:
$$
Q=\text{每轮新增 tokens}
$$
$$
D=\text{每问平均节省的输出 tokens}
$$
$$
N=\text{问题数}
$$
第 2 步:为什么历史重发是 $N^2/2$
在一个连续会话中:
- 第 1 轮前面没有历史
- 第 2 轮重发约 $Q$
- 第 3 轮重发约 $2Q$
- 第 4 轮重发约 $3Q$
- ……
第 $i$ 轮需要重新发送大约:
$$
iQ
$$
个历史 tokens。
因此累计历史重发量为:
$$
Q(0+1+2+\cdots+(N-1))
$$
根据等差数列求和:
$$
Q\frac{N(N-1)}{2}
$$
当 $N$ 较大时:
$$
\approx
\frac{QN^2}{2}
$$
因此单会话历史重发成本具有明显的二次增长特征。
第 3 步:令成本差为零
单会话相对于独立会话的额外成本近似为:
$$
\Delta C=\underbrace{\frac{QN^2}{2}\frac{p_h}{10^6}}{\text{历史重发多付}}-\underbrace{ND\frac{p_o}{10^6}}{\text{输出减少所省}}
$$
令:
$$
\Delta C=0
$$
得到:
$$
\frac{QN^2}{2}p_h=NDp_o
$$
约去 $N$:
$$
\frac{QN}{2}p_h=Dp_o
$$
因此:
$$
N^\ast=\frac{2p_o}{p_h}\frac{D}{Q}
$$
代入高峰价格:
$$
p_o=8
$$
$$
p_h=0.04
$$
得到:
$$
\frac{2p_o}{p_h}=\frac{16}{0.04}=400
$$
所以:
$$
\boxed{N^\ast=400\frac{D}{Q}}
$$
为什么空闲时段仍然是 400?
空闲价格:
$$
p_o=4,\qquad p_h=0.02
$$
则:
$$
\frac{2p_o}{p_h}=\frac{2\times4}{0.02}=400
$$
所以虽然价格整体减半,但:
$$
\frac{p_o}{p_h}
$$
保持不变,因此交叉点也不变。
如果未来官方调整价格,那么只需把常数 400 替换为:
$$
\boxed{\frac{2p_o}{p_h}}
$$
即可。
第 4 步:用实测数据回代验证
| 场景 | $Q$ | $D$ | 理论 $N^\ast$ | 实测交叉点 | 多付命中 tokens:理论 / 实测 | 总成本差:理论 / 实测 |
|---|---|---|---|---|---|---|
| 短问题 R1 | 35.3 | 27.9 | 315 | 24 问内未交叉 | 9756 / 9088 | −0.00543 / −0.00546 |
| 短问题 R2 | 37.2 | 34.6 | 372 | 未交叉($N=1$ 为噪声) | 10272 / 11264 | −0.00862 / −0.00858 |
| 长问题 R1 | 1236 | 48.3 | 15.6 | 12 | 341256 / 341504 | +0.00506 / +0.00507 |
| 长问题 R2 | 1245 | 34.8 | 11.2 | 17 | 343572 / 343936 | +0.00571 / +0.00572 |
可以看到:
- 历史重发 tokens 的理论估计与实测非常接近;
- 最终总成本差也与理论预测高度吻合。
这说明:
$$
\boxed{
N^\ast=400\frac{D}{Q}
}
$$
可以作为一个相当实用的经验决策公式。
$D$ 的含义
$D$ 表示:
使用“一个连续会话”相比“每问一个独立会话”,平均每个问题节省了多少输出 tokens。
定义为:
$$
\boxed{
D=
\frac{
T_{\text{out, independent}}
T_{\text{out, single}}
}{N}
}
$$
其中:
- $T_{\text{out, independent}}$:独立会话总输出 tokens
- $T_{\text{out, single}}$:单会话总输出 tokens
实测结果:
| 场景 | 独立会话总输出 | 单会话总输出 | 每问 $D$ |
|---|---|---|---|
| 短问题 R1 | 837 | 168 | 27.9 |
| 短问题 R2 | 971 | 141 | 34.6 |
| 长问题 R1 | 1305 | 146 | 48.3 |
| 长问题 R2 | 1177 | 341 | 34.8 |
为什么D会存在?
因为:
$$
\text{输出 tokens}
\text{reasoning tokens}
+
\text{回答 tokens}
$$
独立会话
每个问题都是一个全新的上下文。
模型需要重新判断:
- 要不要调用工具?
- 用户希望什么样的回答?
- 应该回答多详细?
- 应该采用什么格式?
实测中,每个问题可能产生约:
$$
12\sim120
$$
个 reasoning tokens。
连续会话
模型能够看到自己之前的回答风格。
如果前几轮都是:
1 | |
这种极简回答,那么后续模型往往会直接延续这种模式:
- reasoning 接近 0
- 最终回答只有 2~3 tokens
因此输出量会显著下降。
为什么 $D$ 特别重要?
因为输出 token 是三类 token 中最贵的。
高峰价格:
$$
p_o=8\text{ 元/M}
$$
相比之下:
$$
p_m=2\text{ 元/M}
$$
$$
p_h=0.04\text{ 元/M}
$$
因此:
$$
\frac{p_o}{p_m}=4
$$
而:
$$
\frac{p_o}{p_h}=200
$$
也就是说:
一个输出 token,相当于 200 个缓存命中 token 的价格。
例如:
$$
D=48
$$
意味着每个问题可以节省:
$$
48\times\frac{8}{10^6}
$$
即:
$$
0.000384\text{ 元}
$$
左右。
$D$ 的三个重要性质
1. $D$ 是行为性的,不是结构性的
这是最重要的一点。
$D$ 来自模型行为:
模型是否会因为已有对话历史而自动缩短 reasoning 和回答。
因此它并不稳定。
例如同一批长问题:
- R1:$D=48.3$
- R2:$D=34.8$
差异已经相当明显。
如果模型完全不会因为上下文而“变懒”,那么:
$$
D\rightarrow0
$$
于是:
$$
N^\ast=400\frac{D}{Q}\rightarrow0
$$
此时单会话几乎从一开始就是亏的。
2. $D$ 会随问题类型发生明显变化
对于简单问答型任务:
$$
D\approx30\sim50
$$
是可能出现的。
但如果任务本身要求:
- 长回答
- 长推理
- 详细解释
- 代码生成
- 深度分析
那么 $D$ 可能明显减小。
甚至可能出现:
$$
D<0
$$
也就是说:
连续会话反而让模型回答得更长。
这是因为随着上下文越来越长,模型可能引用更多历史信息、补充更多解释,从而增加输出。
3. 可以主动放大 $D$
如果目标是降低成本,可以在连续会话开始时明确要求:
后面每个问题只回答一行。
这样可以主动压缩输出,使:
$$
D\uparrow
$$
进而:
$$
N^\ast=400\frac{D}{Q}\uparrow
$$
也就是说:
同一个会话可以容纳更多问题,仍然保持成本优势。
从成本优化角度看,这通常比单纯想办法减少缓存命中的上下文更有效。
最终结论
核心公式是:
$$
\boxed{
N^\ast
\frac{2p_o}{p_h}\frac{D}{Q}
}
$$
在当前高峰价和空闲价下,都可以简化为:
$$
\boxed{
N^\ast=400\frac{D}{Q}
}
$$
因此可以直接使用下面这个经验规则:
当 $N<400D/Q$ 时,优先使用同一个会话;当 $N>400D/Q$ 时,优先考虑每个问题开启独立会话。
真正决定结果的并不是系统提示词,也不是新问题产生的 cache miss,而是两股力量之间的竞争:
$$
\boxed{
\text{输出变短带来的线性收益}
\quad\text{vs.}\quad
\text{历史重发带来的二次成本}
}
$$
短问题中,$Q$ 很小,因此二次重发成本增长很慢,连续会话通常更划算。
长问题中,$Q$ 很大,因此历史上下文迅速膨胀,超过一定问题数后,独立会话反而更便宜。