利用生成式人工智能辅助编程在Kaggle竞赛中获胜
2026 年 3 月,三个大型语言模型生成了超过 60 万行代码,完成了 850 次实验,并帮助团队在 Kaggle 竞赛中获得了第一名。
在现代机器学习竞赛中,能否取得成功越来越取决于能够多快地提出想法、进行测试并不断改进这些想法。大型语言模型与 GPU 加速技术的结合,极大地缩短了这一流程所需的时间。
从历史上看,有两个因素限制了这类实验的开展:
- 你能多快地为新的实验编写代码啊。
- 你执行那些实验的速度真快。
GPU 以及 NVIDIA cuDF、NVIDIA cuML、XGBoost 和 PyTorch 等工具库,已经在很大程度上解决了第二个问题。而大语言模型则有助于解决第一个问题——从而实现更快速、更高效的迭代式实验。
这篇博文介绍了我如何利用大语言模型来加速寻找最有效的表格数据预测方法。
案例研究:Kaggle Playground 上的用户流失预测项目
在 2026 年 3 月的 Kaggle 竞赛中,参赛者需要预测电信客户的流失情况。评估标准是曲线下面积 AUC 值——得分最高的解决方案即为获胜者。
排名第一的解决方案是:从 850 个模型中挑选出 150 个模型,将其堆叠成四层结构。
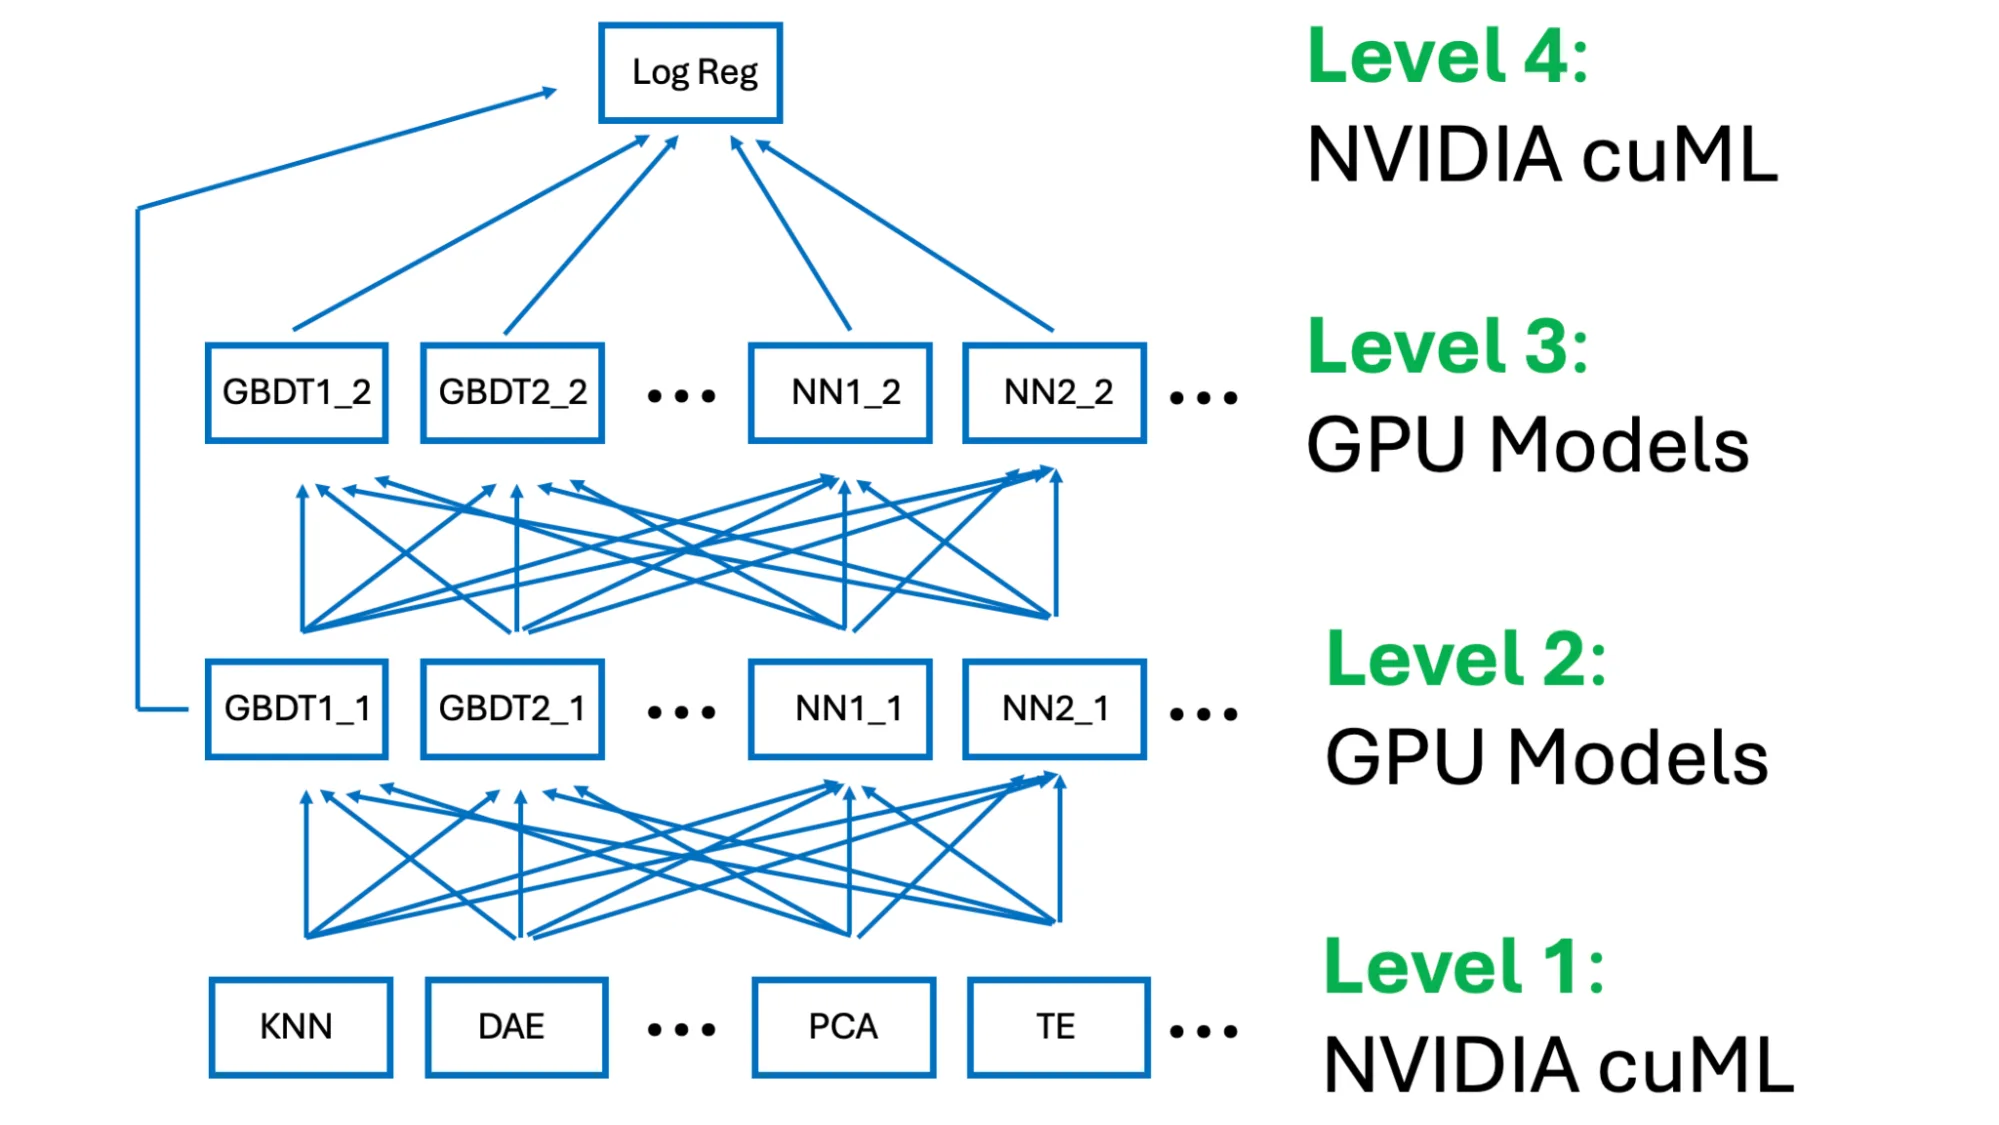
图 1. 该图展示了如何将 150 个模型组合成一个四层结构的解决方案。
引导式大语言模型代理工作流程
具体而言,大型语言模型遵循以下工作流程:首先进行探索性数据分析,接着构建基准模型,再进行特征工程处理,最后通过“爬山法”和“堆叠法”将各个模型组合起来。
该解决方案在“人机协同”的工作流程中,同时运用了多个大型语言模型——GPT-5.4 Pro、Gemini 3.1 Pro 和 Claude Opus 4.6。
步骤 1:大型语言模型代理执行探索性数据分析
在构建完整的处理流程之前,大型语言模型必须先理解数据的结构。
关键问题包括:
- 训练集和测试集分别有多少行和多少列?
- 目标列是什么?其格式又是怎样的?
- 这是任务分类还是回归分析呢?
- 有哪些可用功能,它们的呈现方式又是怎样的?
- 哪些特征是分类型的,哪些是数值型的呢?
- 是否有缺失的数据?
这些信息可以事先提供,也可以通过数据探索分析自动获取。
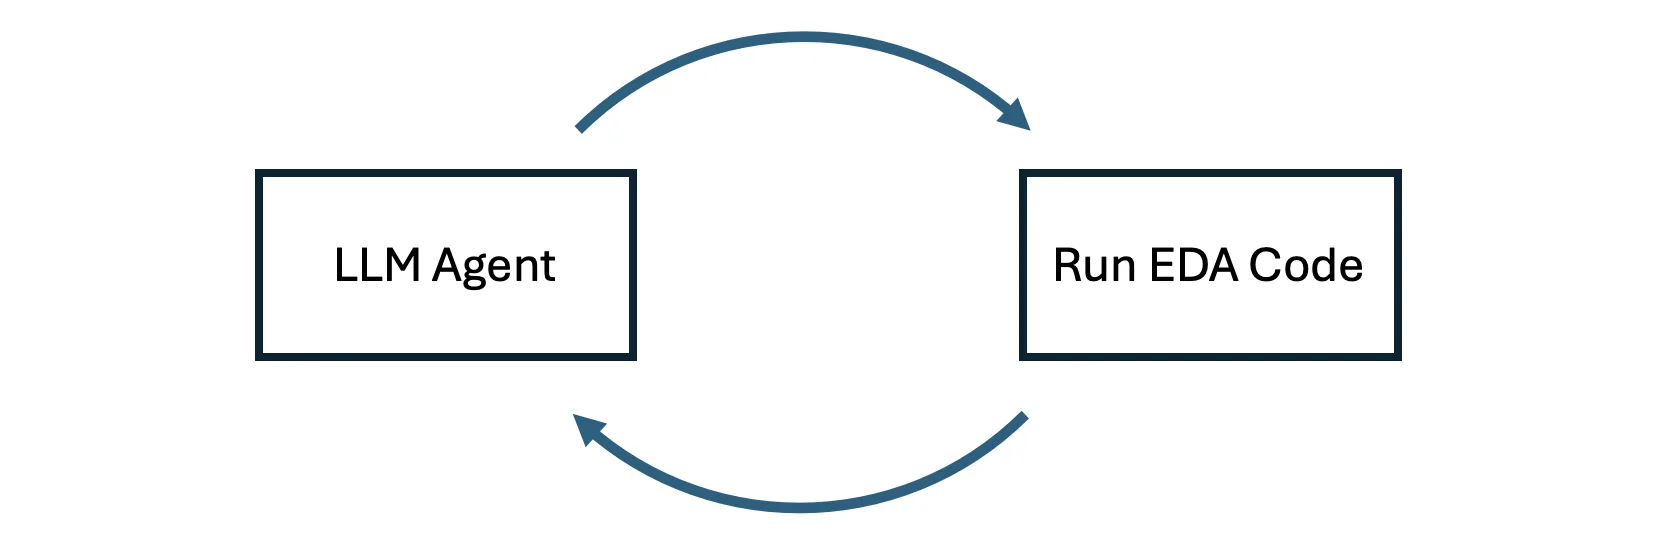
图 2. 大语言模型通过反复编写和运行 EDA 代码来分析数据。
如果在聊天窗口中使用大语言模型,请输入以下提示语:
1 | |
如果使用像 Claude Code 这样的具备代码执行功能的大型语言模型,那么就可以让该模型自行编写和运行代码,从而更深入地理解数据。
1 | |
步骤 2:大型语言模型构建基准模型
一旦大语言模型理解了数据,也就是理解了各个特征列和目标列的含义,接下来就可以编写完整的训练流程了。具体来说,就是向大语言模型请求构建一个 k 折交叉验证模型。
1 | |
将生成的代码复制并粘贴到你的代码库中。如果使用命令行或 IDE 工具,可以让它们直接创建 Python 或 Jupyter Notebook 文件。
运行该代码,即可获得你的第一个 CV 指标得分、OOF 值以及测试结果文件。
你可以让大语言模型构建各种基准模型,包括 GBDT、神经网络和机器学习模型。每个实验都会生成相应的 CV 分数,并将预测结果保存到磁盘上,文件名为“ train_oof_[MODEL]_[VERSION].npy ”和“ test_preds_[MODEL]_[VERSION].npy ”。
这些文件很重要,我们稍后会用到它们。
步骤 3:大型语言模型代理负责特征工程工作
我们现在拥有了一系列不同的模型,并且知道了它们的基准性能指标。我们可以通过特征工程和/或模型调优来提升每个模型的性能。特征工程旨在对数据进行加工处理,以便模型能够提取出更多有用的信息。而模型调优则着眼于对模型本身进行改进,从而提升其信息提取能力。大语言模型在处理这两项任务时都表现得非常出色。
通过反复进行实验,并保留所有能够提升模型性能的改进方案,就能逐步得到越来越好的模型。无论实验结果如何,都应将模型在训练集之外的预测结果保存到磁盘上。
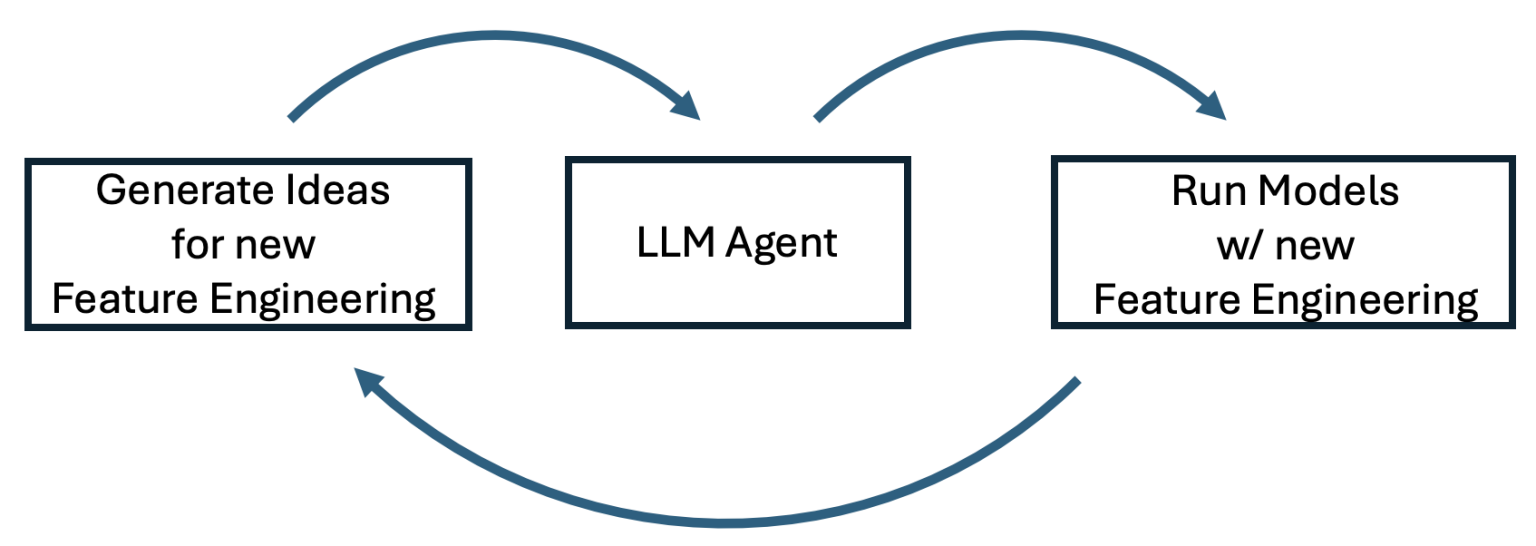
图 3. 大语言模型通过反复进行特征工程并评估新模型来不断提升模型性能。
大语言模型能够以我们希望的速率来编写代码。为了加快这一过程,我们始终使用 GPU 以及诸如 cuDF、cuML、用于梯度提升决策树的 GPU 工具、PyTorch GPU 等 GPU 相关库,从而尽可能快速地完成各项实验。
为了产生新想法,我们可以自己提出来,也可以让大型语言模型来生成。有很多有效的方法可以促使大型语言模型产生新想法,比如:
- 让大型语言模型帮忙查找并阅读与该主题相关的研究论文。
- 让大型语言模型阅读与该主题相关的论坛帖子和公开分享的代码。
- 让大语言模型执行探索性数据分析,以确定各特征与目标变量之间的关系,从而为特征工程提供依据。
- 让大型语言模型根据现有的知识库来提出各种想法。
- 人类可以与大型语言模型一起进行头脑风暴,共同创造出新的想法。
利用我们的某个想法,我们可以让大型语言模型根据现有的代码来生成新的代码:
1 | |
我们现在有一个新的实验要进行了!
第 4 步:大语言模型将各个模型进行整合
目前,我们拥有大量的实验结果。这些结果分别对应着不同的模型和特征工程方法,这些信息都被保存在 Python 脚本或 Jupyter Notebook 中。大语言模型擅长将所有这些模型和思路结合起来,从而帮助我们以各种方式来使用和管理这些模型。
- 总结所有模型类型及特征工程的相关内容。
- 将不同模型中的理念与特征工程技术相结合,从而构建出更强大、更有效的单一模型。
- 从不同的模型中构建集成模型。
- 将堆叠模型置于其他模型之上。
- 利用某些模型来对数据进行伪标记处理,或从中提取有用的知识,进而将这些知识融入到新的、更强大的单一模型中。
我觉得最实用的做法之一,就是让大语言模型来总结我们所有的实验结果。我们可以将文件拖放到聊天窗口中,或者使用大语言模型的命令行接口(比如 Claude Code)来读取并整合多个文件中的数据。这样有助于我们更深入地理解数据和问题所在,从而明确哪些方法是有效的。
一种有效的技巧是让大语言模型将多个想法/模型合并为一个整体模型。
1 | |
另一种方法是将我们部分或所有模型中的知识整合到一个模型中。我们利用模型在训练集之外的预测结果(这些结果本质上可以视为“伪标签”),将这些知识转移到一个新的、更强大的模型中。
1 | |
上述两种方法都会生成新的实验结果,以及相应的“外部验证集”和“测试集”预测文件。每一个基线模型,以及经过特征工程改进或模型优化后的模型,都会对应相应的“外部验证集”和“测试集”预测文件。通常情况下,这样的文件数量会达到数百个。现在,我们可以利用“爬山算法”或“堆叠算法”来整合这些文件。
1 | |
结果
按照上述四个步骤,我们可以构建出多种不同的模型。接着,我们会提升每个模型的性能。最后,将这些模型整合起来,形成一个高效的解决方案。其优势在于:借助 GPU 加速的模型运行机制以及 LLM 智能体来加速代码编写,我们可以快速尝试各种方案。在寻求解决表格数据预测问题的最佳方案时,任何人都可以运用这些技术。