2026年多模态大模型幻觉(Multimodal LLM Hallucination)论文精读
收录论文:正文 44 篇(研究对象即多模态大模型幻觉) | 附录 8 篇(边界文献)
会议构成(正文):AAAI2026 5 篇、ACL2026 10 篇、CVPR2026 16 篇、ICLR2026 4 篇、ICML2026 9 篇
每章结构:中文摘要 → 方法图(原文截取,经逐张目视核对)→ 研究动机 → 研究方法 → 实验结果(含基座模型、数据集与基准、关键数字)→ 论文结论
正文:多模态大模型幻觉论文精读(44 篇)
[1] AAAI2026 — Causally-Grounded Dual-Path Attention Intervention for Object Hallucination Mitigation in LVLMs
- 会议:AAAI 2026(arXiv 录用说明:9 pages, published to AAAI 2026)
- arXiv:2511.09018 — https://arxiv.org/abs/2511.09018
- 本地 PDF:
AAAI2026-Causally-Grounded Dual-Path Attention Intervention for Object Hallucination Mitigation in LVLMs.pdf - 一句话定位:把视觉/文本注意力当作因果中介,用新指标 VTACR 引导逐层双路对比解码来压物体幻觉。
1. 中文摘要
本文针对大视觉语言模型(LVLM)的物体幻觉问题,指出现有基于语言解码器的缓解方法各自只调控视觉注意力或文本注意力,忽略了二者作为两个关键因果因子的交互。为此作者提出 Owl(Bi-mOdal attention reWeighting for Layer-wise hallucination mitigation):先用结构因果模型(SCM)把幻觉过程形式化,将分解出的视觉注意力 AV 与文本注意力 AT 建模为输入与输出之间的中介变量,视觉先验 PV 与语言先验 PT 作为混杂因子只经由中介起作用,因此可以对注意力做软干预 do(AV = AV)、do(AT = AT)。作者提出 VTACR(Visual-to-Textual Attention Contribution Ratio),用当前 token 对视觉前缀与文本前缀的平均注意力之比衡量模态贡献失衡,并发现幻觉 token 普遍落在低 VTACR 区间,即过度依赖文本先验、视觉接地被削弱。方法上,作者在 2000 条 MSCOCO 幻觉样本上统计逐层 VTACR 密度分布、取 τ 分位数作为基准 Vb,推理时若当前层 V(ℓ) < Vb 就按公式自适应放大视觉/文本注意力系数 α、β;随后沿”视觉偏好路径”与”文本偏好路径”分别构造两套注意力与 logit,用双路对比解码(DCD)的融合公式放大忠实 token、压低幻觉 token。POPE 与 CHAIR 上显著降低幻觉,同时五个 VQA 基准显示视觉语言理解能力基本保持甚至提升。
2. 方法图
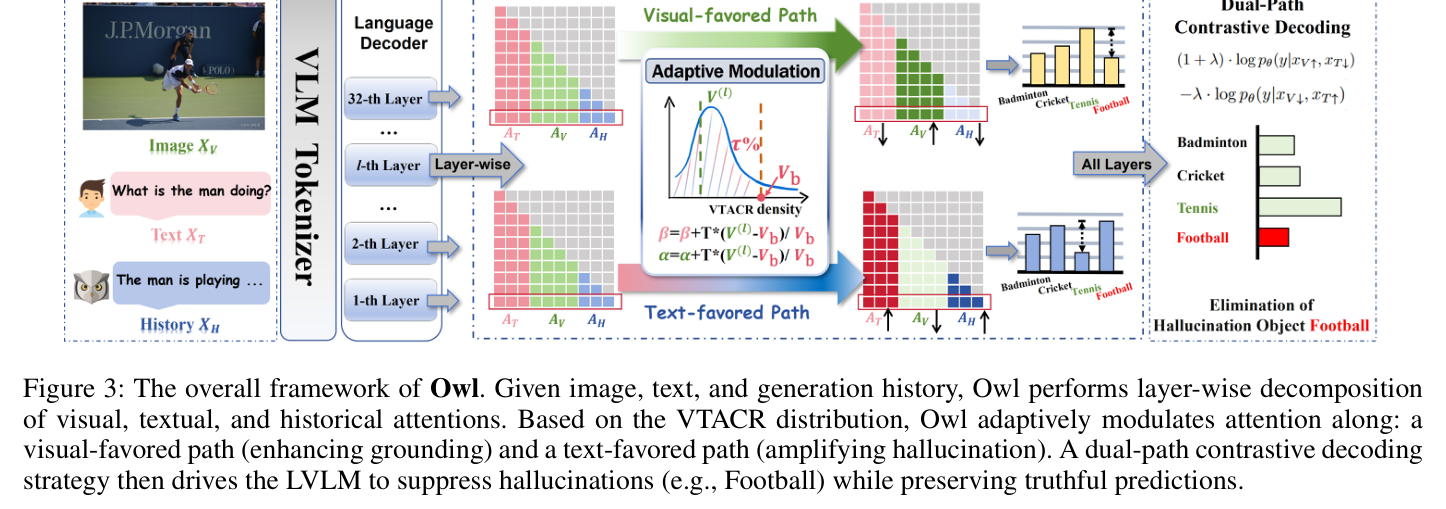
说明:图注未变,仅重新裁剪了图片区域。首次裁剪的图片底部夹带了下一节”Mediator Analysis”的正文字与因果干预热图,现已重裁为完整的框架图 + 完整 Figure 3 图注。
3. 研究动机
- 现有做法的缺陷:作者指出语言解码器注意力类方法”tend to act on either the visual path – by enhancing attention to image tokens – or the textual path – by diminishing influence from autoregressive history”,即单模态设计(uni-modal design)忽略了视觉与文本模态之间的注意力失衡,而这往往正是幻觉的核心;文中还点名 PAI 使用固定缩放系数(”Rather than applying fixed scaling factors (as in previous work like PAI)”)。
- 本文的关键观察/假设:对模态注意力做因果干预后发现一个此消彼长的规律——(1) 单纯增强视觉注意力会持续降低幻觉(TCE 上升)但输出变短;(2) 单纯增大文本注意力(含 query 与 history)会让输出变长却加重幻觉。这一 trade-off 说明必须平衡二者而非各自独立处理。
- 指标层面的洞见:作者用自提的 VTACR 量化”当前 token 对视觉/文本模态的相对依赖”,发现幻觉 token 在 LLaVA-1.5 上呈现偏斜的 VTACR 值,且该现象跨层、跨基座一致(”consistent across layers/backbones”)。
- 因果建模动机:与在输入或潜在状态上做干预的传统做法不同,把注意力当中介可以在保持输入一致的前提下直接操纵注意力权重,更可解释也更细粒度。
4. 研究方法
- 总体流程:SCM 建模(XV→AV→YT, PV→AV→YT, XT→AT→YT, PT→AT→YT,因先验不可观测故只对中介 AV、AT 施加软干预)→ 用 VTACR 在线测量模态贡献 → 逐 token、逐层调制注意力 → 双路注意力干预生成两套 logit → 对比解码融合输出。
- VTACR 指标:视觉贡献 ν(ℓ) 为当前 token 在 ℓ 层各头对视觉前缀 token 的平均注意力,文本贡献 τ(ℓ) 为对 query+history 文本前缀的平均注意力,VTACR(ℓ) = ν(ℓ)/τ(ℓ)。
- Adaptive Attention Modulation:从 MSCOCO 随机采 2,000 条幻觉样本,统计每层幻觉 token 的 VTACR 密度分布,取第 τ 百分位作为基准 V(ℓ)b;推理时若 V(ℓ) < V(ℓ)b 则按 T̃(ℓ) = I(V(ℓ)<V(ℓ)b)·min(T·(V(ℓ)−Vb)/Vb, T) 增量更新 α̃(ℓ)=α+T̃(ℓ)、β̃(ℓ)=β+T̃(ℓ),否则不干预——只对高风险 token 动手,避免过度纠正(对比 PAI 在注意力层做统一干预)。
- 双路注意力干预 + DCD:视觉偏好路径放大视觉 token 注意力、衰减文本注意力(Ã = A + α̃|A| / Ã = A − β̃|A|),文本偏好路径符号相反;两路 logit 按 PDCD = Softmax[(1+λ)·log pθ(y|XV↑, XT↓) − λ·log pθ(y|XV↓, XT↑)] 融合,λ 控制对比强度。
- 训练/推理策略:完全免训练(training-free)的解码期干预,插在语言解码器的每层注意力与最终 logit 融合处;超参 α=0.4、β=0.5(LLaVA-1.5),(0.2, 0.3)(MiniGPT-4),(0.5, 0.3)(Shikra),λ 固定 0.2,T=0.2,τ 默认 80,实验在 4×NVIDIA 3090 上完成。
5. 实验结果
- 基座模型:LLaVA-1.5、MiniGPT-4、Shikra
- 数据集与基准:POPE(Random / Popular / Adversarial 三个划分)、CHAIR(CHAIRS 与 CHAIRI)、GPT-4V Assisted Evaluation(评 Correctness 与 Detailedness);图像来自 MSCOCO val2014 随机采样的 500 张;另有五个 VQA 基准 VQAv2、GQA、VizWiz、ScienceQA-IMG、TextVQA 检验通用理解能力
- 关键结果:
- CHAIR 上相对最强前作 PAI,CS 分别降低 17.6%、14.5%、22.1%,CI 分别降低 21.4%、36.7%、24.8%(LLaVA-1.5 / MiniGPT-4 / Shikra);绝对值为 LLaVA-1.5 CS 31.8→26.2、CI 10.3→8.1,且生成长度从 85.2 升到 98.4(未牺牲信息量)
- POPE(Shikra)三设置全部最优:Random 85.2 / Popular 82.3 / Adversarial 83.4,对比 PAI 的 81.5 / 79.2 / 80.5;LLaVA-1.5 上 Owl 也拿到 Adv 90.5
- GPT-4V 评测:LLaVA-1.5 的 Correctness 从 5.58 升到 6.70(+20.1%),Detailedness 5.30→5.90(+11.3%)
- 通用能力:LLaVA-1.5 上 TextVQA +3.7、VizWiz 从 48.8 升到 52.5(+7.6%),VQAv2 仅从 80.0 降到 78.2(−2.3%)
- 消融(Figure 6):增大 α 增强视觉接地但过大压低 F1;增大 β 稳定降幻觉且 F1 几乎不掉;λ 在 0.1–0.4 区间稳定,过大同时损伤 CHAIR 与 F1
- 对比方法:Beam Search、Greedy Decoding、Nucleus Sampling、VCD、PAI、OPERA、CausalMM
6. 论文结论
- 作者自述贡献:(1) 提出 VTACR 量化生成过程中的跨模态依赖,并据此做细粒度 token/层级的注意力调制;(2) 构建以视觉与文本注意力为中介的 SCM,实现可解释的双模态干预分析幻觉成因;(3) 提出 VTACR 引导的双路对比解码,放大忠实生成、暴露幻觉生成;(4) 在 POPE/CHAIR 上大幅降幻觉(CHAIR 提升 22.9%),同时在五个 VQA 基准上验证理解能力保持。
- 局限与未来工作:论文未设 Limitation 章节,未明确说明局限;结论仅泛泛表示本工作”provides both theoretical insights and practical tools for enhancing LVLM faithfulness, and opens new avenues for causal control in multimodal generation”。可注意:α、β 需按基座逐个人工调参,(τ, T, λ) 亦为经验值,且主实验仅覆盖 500 张 MSCOCO 图像。
批注:有点像clearsight
[2] AAAI2026 — Ground What You See: Hallucination-Resistant MLLMs via Caption Feedback, Diversity-Aware Sampling, and Conflict Regularization
- 会议:AAAI 2026(arXiv 录用说明:AAAI-2026 Poster)
- arXiv:2601.06224 — https://arxiv.org/abs/2601.06224
- 本地 PDF:
AAAI2026-Ground What You See Hallucination-Resistant MLLMs via Caption Feedback, Diversity-Aware Sampling, and Conflict Regularization.pdf - 一句话定位:诊断 RL 训练中 MLLM 幻觉的三个成因,用 caption 奖励、高方差采样与 NTK 对比正则逐个治。
1. 中文摘要
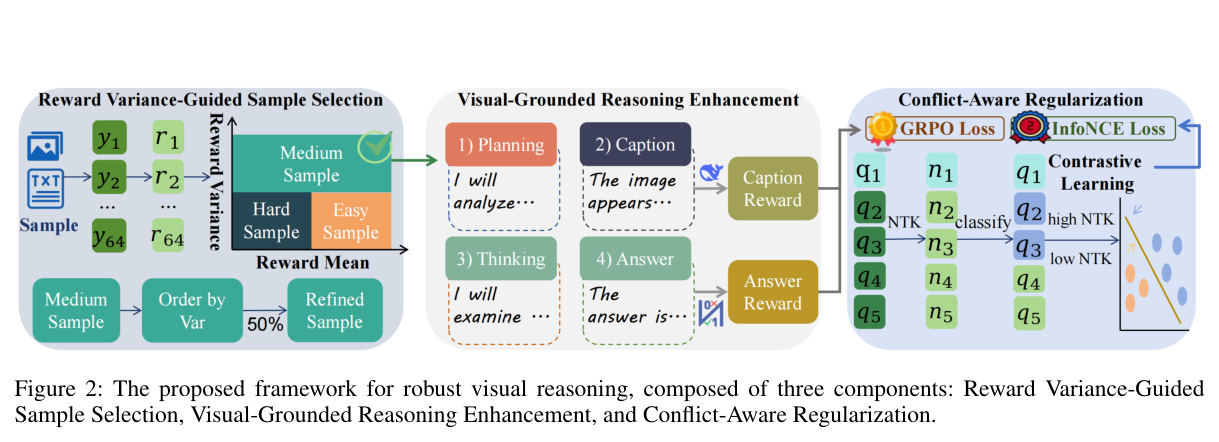
本文系统分析了大模型在强化学习(RL)优化过程中幻觉的成因,指出三个关键因素:(1) 模型在 RL 训练中高度依赖链式视觉推理来指导决策,视觉推理中的错误或不相关信息极易引发幻觉——包括初始视觉描述不准确从而把后续推理锚定在错误信息上,以及冗余宽泛的推理信息;(2) 策略优化阶段探索多样性不足,使模型输出过度自信的结果;(3) 不同样本在优化过程中的破坏性冲突,是导致虚假关联与参数更新不稳定的关键因素。针对这三点,作者提出含三个模块的框架:一是在 thinking/answer 阶段之前增加 planning 与 caption 阶段以提升视觉定位准确性,并引入 Caption Reward——只让模型依据 caption 与问题作答,再由另一 LLM 仅凭该 caption 能否答对来判断 caption 质量并给奖励;二是按奖励分布的均值与方差对样本分类,只保留高奖励方差的样本训练以提升探索能力;三是以神经正切核(NTK)相似度作为冲突关键量,不统一最小化而是按相似度阈值把样本对分为正/负对,用 InfoNCE 损失把不相似的对拉近、把过于相似的对推远,使 NTK 相似度落入平衡区间。实验显示该方法显著降低幻觉率并提升推理准确率。
2. 方法图
3. 研究动机
- 现有做法的缺陷:作者认为以往 RL for MLLM 的研究”largely ignored the illusions caused by visual extraction errors and how to design reward signals to guide the model to generate accurate and vision-based captions”,即忽视了视觉抽取错误导致的幻觉,也没设计奖励去引导模型产生准确、基于视觉的 caption;同时指出 GRPO 会通过强化”语义上合理但视觉上无依据”的回答而加剧幻觉,尤其在监督稀疏或模糊时。样本冲突背后的关键因素在既有研究中仍未被充分探索(”the key factors underlying such conflicts remain underexplored”)。
- 本文的关键观察/假设:作者先诊断出 RL 训练中三类幻觉(Figure 1):Visual Misinterpretation(初始视觉描述错→错误沿推理链传播;或宽泛不精确地关注输入,产出被误当关键证据的冗余推理)、Limited Exploration(低奖励方差样本被反复强化,输出分布变窄)、Sample Conflict(对样本 xu 的更新会意外改变无关样本 xo 的预测,制造虚假关联)。随后由 GRPO 损失对 logits 求导得到 ∂Li/∂zv 的表达式,说明 Ai,t > 0 会尖化(sharpen)输出分布、Ai,t < 0 会平坦化(flatten)分布,并据此推断”高奖励方差样本(时而做对时而做错的中等样本)才是最有价值的训练信号”。
- 数据/现象证据:Figure 1(b) 显示奖励方差更高的样本泛化更好;Figure 1(c) 展示样本间更新会互相干扰;NTK 相似度与真实语义相似度并不一致,因此模型可能产出”NTK 上相近、语义上无关”的自信错误输出。
4. 研究方法
- 总体流程:在 GRPO 框架(Eq.1,含 KL 惩罚 β 与 clip 阈值 ε 的组相对优势优化)之上叠加三个模块,分别对应改善视觉定位、提升探索多样性与抑制样本冲突,共同作用于 RL 更新。
- Visual-Grounded Reasoning Enhancement(含 Caption Reward):把推理范式从 thinking→answer 扩展为 planning→caption→thinking→answer;planning 阶段早期定位问题相关视觉区域,caption 阶段为这些区域生成简洁文本描述作为聚焦中间引导。Caption Reward 抽取模型生成的 caption,与问题一起喂给独立的 LLM 作答:仅凭 caption 能答对则给正奖励,否则为零奖励——以此定量度量 caption 与视觉输入的一致性。
- Reward Variance-Guided Sample Selection:对每个输入查询生成 64 条回答并计算奖励均值与方差,把样本分为 easy(高均值低方差)、hard(低均值低方差)、medium(高方差)三类;以奖励方差为选择分数,只保留方差最高的前 50% 样本参与 RL 训练。理论依据是 Eq.(2) 揭示的优势符号决定分布是尖化还是平坦化,中等样本能从不确定性平滑过渡到自信预测。
- Conflict-Aware Regularization(InfoNCE):由 Eq.(3) Δlog πt(yu|xo) = η·At(xo)·Kt(xo,xu)·∇z log πt(yu|xu)·Au,t + O(η²‖∇θz(xu)‖²op) 说明冲突效应主要由 NTK 项 Kt(xo,xu) 支配。由于 NTK 难以直接计算,用两样本末层 log-prob 梯度的余弦相似度近似;对同批次样本按阈值 τ 分对:相似度低者视为正对(鼓励对齐),相似度过高者视为负对(鼓励分化),再用 InfoNCE 损失(Eq.4)把 NTK 相似度引导到平衡区间,而非统一最小化。
- 训练/推理策略:基于 Qwen-VL-2.5-7B 做 SFT 与 GRPO 强化训练;训练信号为答案奖励(Answer Reward)加 caption 奖励,样本筛选与对比正则都作用在 RL 更新环节,推理阶段不额外加模块。
5. 实验结果
- 基座模型:Qwen-VL-2.5-7B(含 Qwen-VL-2.5-7B-SFT、Qwen-VL-2.5-7B-GRPO 与 Qwen-VL-2.5-7B-Ours)
- 数据集与基准:MMVU、VideoMMMU、VideoHallucer、MathVista、POPE、MMBench(en)(另用 ChartQA 的 100 条测试样本分析策略熵)
- 关键结果:
- VideoHallucer 上 Ours 达 50.8%,高于同基座 GRPO 变体的 42.3% 与基座 46.5%,也比 InternVL2.5-8B 的 50.5% 略高;说明标准 GRPO 反而降低幻觉基准表现,RL 会引入幻觉
- MMVU 达 65.6%,超过所有开源模型(Video-R1-7B 62.5%、R1-VL-7B 59.7%),仅次于 GPT-4o 的 75.4%;MMBench(en) 88.6%、POPE 88.7%(超过 GPT-4o 的 86.9 与 83.4)
- 消融(Table 2,MMVU/VideoHallucer/POPE):w/o Caption 为 62.6/47.6/85.2,w/o Caption Reward 为 63.3/48.6/86.6,两者都用才达 65.6/50.8/88.7
- 消融(Table 3):仅用 Medium Sample 达 65.6/50.8/88.7,优于 Full Sample 的 64.3/49.4/87.5、Easy 的 62.2/47.7/86.6 与 Hard 的 63.5/48.4/88.2
- 消融(Table 4):去掉 InfoNCE 为 63.8/48.3/86.8,加入后升至 65.6/50.8/88.7;NTK 阈值 τ=0.54 时准确率最高
- 对比方法:GPT-4o、Gemini-1.5-Pro、LLaVA-OneVision-7B、VILA-1.5-8B、MiniCPM-V2.6-8B、InternVL2.5-8B、LLaMA3.2-11B、R1-OneVision-7B、R1-VL-7B、Vision-R1-7B、Video-R1-7B
6. 论文结论
- 作者自述贡献:(1) 提出 Visual-Grounded Reasoning 机制,在 thinking/answer 前加入 planning 与 caption 阶段,并用 Caption Reward 通过”仅凭 caption 能否答对”量化视觉-文本对齐;(2) 通过按奖励均值与方差分类、只选高方差样本训练,缓解 RL 中探索多样性不足导致的幻觉;(3) 提出 Conflict-Aware Regularization,用样本间 NTK 相似度度量冲突并以 InfoNCE 把相似度引导到合适区间。
- 局限与未来工作:论文未设 Limitation/Future Work 章节,未明确说明局限;结论仅称该框架”enhances visual faithfulness, improves robustness, and stabilizes learning dynamics of MLLMs without compromising generalization”。可注意实现细节:每查询需生成 64 条回答以估计奖励方差,且 τ=0.54、前 50% 采样比例均为经验设定。
[3] AAAI2026 — InEx: Hallucination Mitigation via Introspection and Cross-Modal Multi-Agent Collaboration
- 会议:AAAI 2026(arXiv 录用说明:Published in AAAI 2026)
- arXiv:2512.02981 — https://arxiv.org/abs/2512.02981
- 本地 PDF:
AAAI2026-InEx Hallucination Mitigation via Introspection and Cross-Modal Multi-Agent Collaboration.pdf - 一句话定位:免训练的”内省+跨模态多智能体”框架:先按 TVER 不确定性触发内部自省,再靠编辑图像与双向反思反复核验。
1. 中文摘要
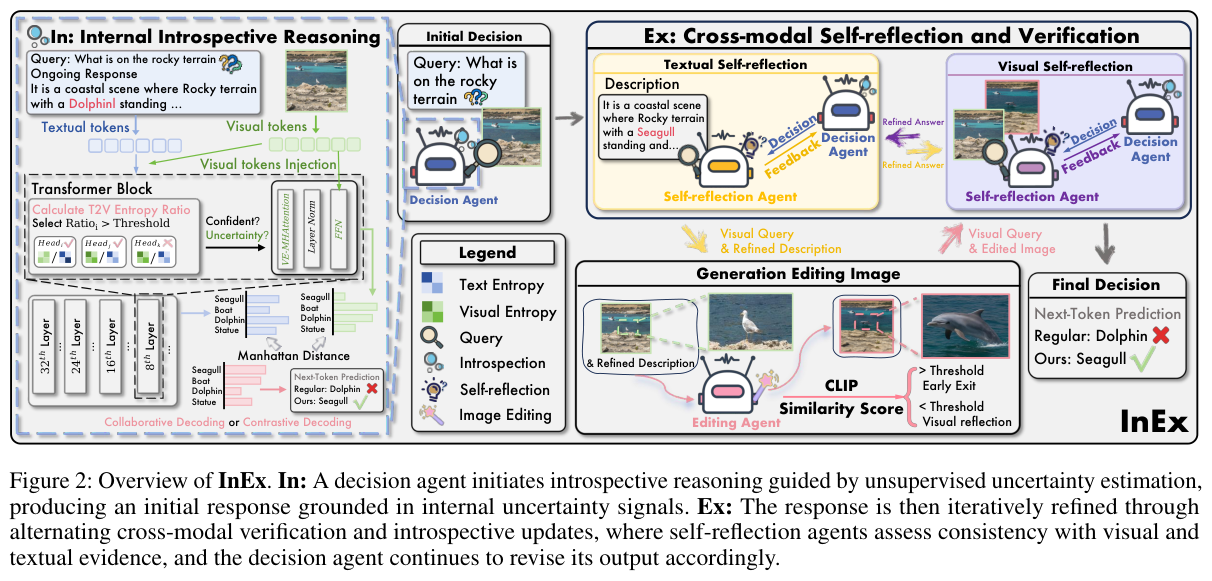
本文针对多模态大模型(MLLM)幻觉问题,指出现有方案要么依赖人工干预(微调、RLHF),要么没有用好智能体自主缓解幻觉的能力,并进一步批评内处理与后处理方法被割裂对待,忽视了”迭代推理与验证本是相互加强的”。作者从人类可靠决策的认知范式出发——先用内省推理降低不确定性形成初步判断,再依靠多视角外部验证得出最终结论——提出 InEx:一个免训练的多智能体框架。In 阶段,决策智能体在内省信号引导下做内部推理,作者系统比较了若干不确定性度量,实证发现 Text-to-Visual Entropy Ratio(TVER,文本注意力熵与视觉注意力熵之比)AUROC 最高、ECE 最低,于是以 TVER ≥ γTVER 作为不确定性触发条件,对高 TVER 的注意力头做掩码得到 Vision-Enhanced MHA(VE-MHA),并配合两个机制:Self-Introspective Visual Augmentation 用相似度加权检索把视觉 token 融进 FFN(FFN_introspect = α∆(z|H) + (1−α)FFN(H)),Self-Introspective Decoding 按原/增强 logits 的曼哈顿距离 dt 与阈值 γd 在”协同模式”和”对比模式”间切换。Ex 阶段,文本自反思智能体核对回答是否被 dense caption 支持,编辑智能体按回答编辑图像,视觉自反思智能体用 CLIP 相似度核对编辑图与原图,双向反馈回灌给决策智能体,循环至跨模态共识或达到迭代上限。作者另给出三条理论结果(互信息增加、条件熵下降、IB 目标改善)。实验在 POPE/CHAIR/HallusionBench 与通用基准上一致超越 OPERA、ICD、VCD,作者报告通用基准提升 3.8%–16.2%、幻觉基准提升 6.5%–26.7%。
2. 方法图
3. 研究动机
- 现有做法的缺陷:作者把先前工作分为三类并各自指出短板——(i) 预处理类(微调/RLHF)需要大量人工监督与任务特定标注,可扩展性与适应性受限;(ii) 内处理类依赖幻觉相关启发式或指标引导生成,但因与模型内部推理强耦合、缺少外部验证,容易陷入 meta-hallucination(对源自错误知识的claim持有元认知自信);(iii) 后处理类用外部验证器在生成后纠错,有些验证器还需重新训练,带来额外算力开销,且”reactive rather than preventive”。作者进而主张:把内处理与后处理孤立对待,”ultimately underutilizes the autonomous capabilities of agents for hallucination mitigation”。
- 本文的关键观察/假设:作者系统比较了多种内部不确定性度量方法,实证发现 TVER(Text-to-Visual Entropy Ratio)效果最好——AUROC 最高、ECE 最低(Figure 1),说明它的校准性最好、与幻觉相关性最强;TVER 越高越可能幻觉,对应文本熵升高而视觉熵降低,即文本侧的不确定性可能来自”误导性但自信的视觉线索”。
- 认知范式启发:人类做可靠决策时先内省降不确定、再靠不同视角的外部验证收敛,而现实中迭代推理与验证本就相互加强;因此设计上把 In 与 Ex 统一为一个互相增强的闭环。
- 自反思的模态缺口:已有 self-reflection 研究集中在纯文本(文本内自评、外部文本 critic、外部知识源),缺乏视觉接地,无法直接用于多模态场景。
4. 研究方法
- 总体流程:决策智能体 Ad 先生成初始回答 y0 → 文本自反思智能体 At 检查 y0 是否被 dense caption c 支持(支持则直接返回,否则给出文本反馈 ft)→ Ad 带反馈重写 yi → 编辑智能体 Ai 依 yi 编辑图像得 v′ → 视觉自反思智能体 Av 用 CLIP 比较 v′ 与原图 v(相似度超 γCLIP 则返回,否则给出视觉反馈 fv)→ Ad 依 fv 再改,再交给 At 复核;循环直到跨模态共识或达到迭代上限 I(伪代码见 Algorithm 1)。
- In: Internal Introspective Reasoning(含 TVER 与 VE-MHA):计算每层的原始注意力 aℓ = softmax(QℓKℓᵀ/√dk),按文本索引 T 与视觉索引 V 划分后分别求熵,TVERℓ = Entropy(T)/Entropy(V);对 TVERℓ ≥ γTVER 的注意力头做掩码 ãℓ,h = 0,得到 VE-MHA(con̄Hℓt) = Concat(ãℓ,1H̄ℓ1, …, ãℓ,HH̄ℓH)Wℓo,用于在最后一层替换原 MHA 输出以过滤不确定的隐表示。
- Self-Introspective Visual Augmentation:以相似度加权检索 ∆(z|H̄ℓ) = Σᵢ σ(⟨H̄ℓ, zi⟩)·zi 调制 FFN,改写为 FFN_introspect_ℓ(H̄ℓ) = α∆(z|H̄ℓ) + (1−α)FFNℓ(H̄ℓ),α∈[0,1] 表示内省强度,相当于让模型”回访”视觉接地。
- Self-Introspective Decoding:计算原始与增强 logits 的曼哈顿距离 dt = ‖ϕ(HL) − ϕ(ĤL)‖T(通常在 top-k,如 k=20 上算);dt < γd 表示两者一致,用协同模式 ϕ(HL) + α1ϕ(ĤL) 强化决策;dt ≥ γd 表示分歧,用对比模式 (1+α2)ϕ(HL) − α2ϕ(ĤL) 以原始 logits 为主、增强 logits 仅作校准。
- Ex: Cross-modal Multi-Agent Collaboration:文本自反思通过多视角(actions/objects/colors 等)反思 + 集成聚合(重复三次)产出更可靠的 ft;视觉侧以”按回答编辑图像后是否仍与原图一致”作为接地检验;四条设计原则分别对应:跨模态验证作为幻觉防线、决策须与 dense caption 一致、文本推断需经图像编辑验证、跨模态反馈回灌增强内省。
- 训练/推理策略:完全免训练、无人工监督;超参 γTVER=0.55、γd=0.2、γCLIP=0.9、α1=1、α2=1;自反思用温度 0.7 解码并结合三次输出的集成聚合,最多四个专门视角;编辑智能体用 IC-Edit 实现;全部实验在 NVIDIA H100 上以 FP16 完成。
5. 实验结果
- 基座模型:Qwen-VL(10B)、LLaVA-1.5(7B)、GLM-4V(9B)
- 数据集与基准:幻觉类 POPE(MSCOCO、A-OKVQA、GQA 三个子集,Random/Popular/Adversarial 设置)、CHAIR、HallusionBench;通用类 VizWiz-VQA、MME、MMBench、MM-Vet、LLaVA-Bench (in-the-wild)
- 关键结果:
- POPE 上 LLaVA-1.5-7B 在 MSCOCO 子集的平均准确率从 79.83 提升到 88.73(+8.9%),A-OKVQA 从 79.13 到 87.32,GQA 从 78.99 到 86.72;对比 OPERA 84.14 / ICD 82.97 / VCD 82.60
- HallusionBench 准确率 41.5 → 44.2(+2.7),而 OPERA/VCD 分别下降 0.3/0.4;LLaVA-Bench 63.4 → 66.5(+3.1);CHAIR 的 CHAIRS 50.0 → 45.1(↓4.9)、CHAIRI 15.4 → 13.3(↓4.1),Recall 77.1 → 83.2(+6.1)
- MME-Hall(LLaVA-1.5)643.3 → 673.3;MM-Vet 31.10 → 36.00;VizWiz 50.00 → 53.80;MMBench 62.80 → 67.17。Qwen-VL-10B 的 MME-Hall 达 677.3(+59),GLM-4V-9B 达 732.3(+35)
- 消融(Table 3):基座行 POPE 79.83,七个”In / Textual / Visual”非空组合的 POPE 分别为 86.43、83.20、85.20、86.39、87.77、86.93、88.73,全部高于基座且三者全开时最高(88.73),作者据此说明三个组件互补;图像编辑模型消融显示 In-Context Edit 总体最好(Table 3 原文用勾选标记组合,纯文本抽取后每个数字对应的具体组合无法逐一确认)
- 统计显著性:20 次独立运行,InEx 平均 88.73 ± 0.33,对比 OPERA 84.14 ± 0.62、ICD 82.97 ± 0.41、VCD 82.60 ± 0.54,配对单侧 t 检验 p = 8.72×10⁻²⁵(对 OPERA)
- 对比方法:OPERA、ICD、VCD(论文指出 OPERA 不支持 Qwen-VL 与 GLM-4V)
6. 论文结论
- 作者自述贡献:(1) 提出免训练多智能体框架 InEx,通过内部内省推理与外部跨模态协作缓解幻觉;(2) 证明在多模态多视角自反思智能体支持下,跨模态共识能有效缓解幻觉;(3) 实验显示 InEx 在通用基准上领先 3.8%–16.2%、在幻觉基准上领先 6.5%–26.7%;此外用互信息增加、条件熵下降、IB 目标改善三条定理为方法提供理论支撑。
- 局限与未来工作:论文明确写道 InEx 面向文本与视觉两个模态的 MLLM,”currently lacks effective support for the audio modality”;未来计划加入音频自反思智能体,使跨模态验证也能处理音频。可注意实现代价:每个样本需多轮图像编辑与多次自反思、集成聚合,推理开销显著高于单次解码。
[4] AAAI2026 — Multi-Agent Undercover Gaming: Hallucination Removal via Counterfactual Test for Multimodal Reasoning
- 会议:AAAI 2026(arXiv 录用说明:Accepted by AAAI 2026)
- arXiv:2511.11182 — https://arxiv.org/abs/2511.11182
- 本地 PDF:
AAAI2026-MUG Multi-agent Undercover Gaming — Hallucination Removal via Counterfactual Test for Multimodal Reasoning.pdf - 一句话定位:把多智能体辩论改造成”谁是卧底”游戏,用反事实改图当标准答案来揪出产生幻觉的智能体。
1. 中文摘要
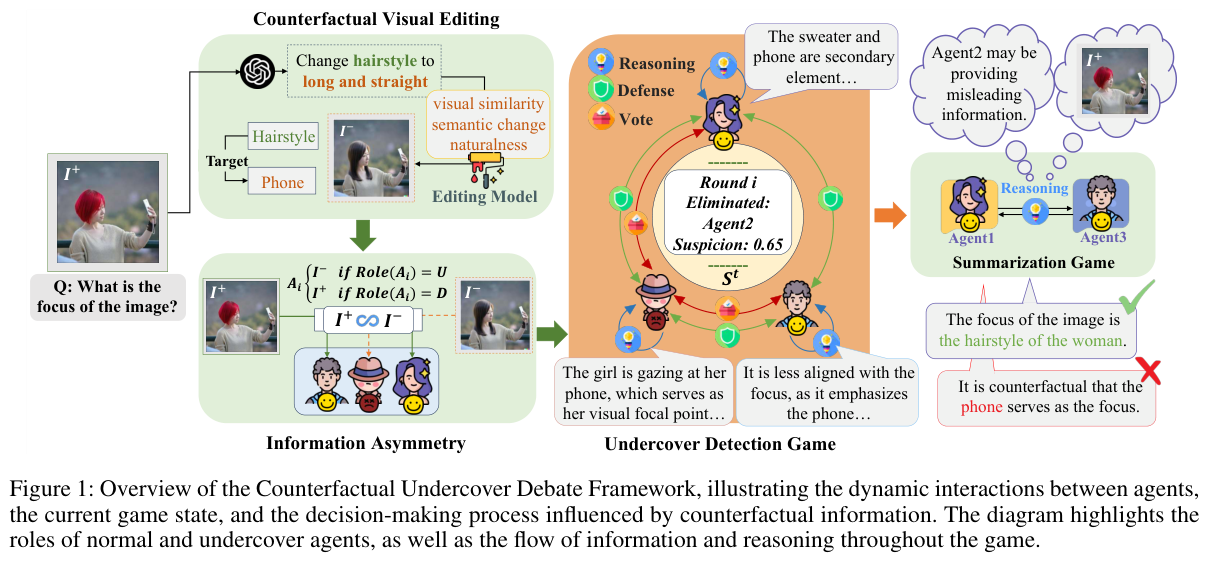
本文指出多智能体辩论(MAD)虽通过智能体共识提高可靠性,但依赖一个不现实的假设——所有辩论者都理性且善于反思;当智能体自身就容易幻觉时,这个前提不成立。作者受”谁是卧底”等社交推理游戏启发,提出 Multi-agent Undercover Gaming(MUG)协议:把 MAD 重新表述为”找出卧底智能体(即患幻觉者)”的过程,并用多模态反事实测试提供判定依据。具体做法是:先用 LLM 对问题分类映射到预定义编辑类型(如”How Many”对应 Quantity Editing、”What Object”对应 Object Editing),再对事实图像 I+ 建场景图定位目标对象,生成编辑提示;编辑需满足三条约束——最大视觉相似度(ViT 嵌入相似度 Cvs)、语义一致性(CLIP 嵌入相似度 Csc)与自然度(FID,Cna),只有 α·Cvs + β·Csc + γ·Cna ≥ c 才接受生成的反事实图 I−(生成器用 Step1X-Edit)。游戏开始时一名智能体被秘密分配 I− 成为卧底,其余拿到 I+,形成信息不对称。系统先进入 Undercover Detection Game:每轮各智能体在”忠实推理”与”战略隐藏/侦测”之间权衡产出陈述,再依据不一致性、偏离共识度、细节准确度、行为可疑度四类信号投票,多数票淘汰一人;一旦卧底被淘汰(或常规智能体≤1、或超时)便转入 Summarization Game,剩余智能体基于事实图协同综合出最终答案。MUG 在三个维度上推进 MAD:(1) 用反事实测试做事实核验而非纯统计共识;(2) 用动态修改的证据源做跨证据推理而非静态输入;(3) 让智能体主动追问讨论而非被动答题。实验在 MMMU、MMStar、HallusionBench、POPE 上覆盖多种开源与闭源基座,显示出稳定的推理准确率与幻觉检测提升。
2. 方法图
3. 研究动机
- 现有做法的缺陷:常见 MAD 协议照搬人类辩论结构(多数投票、超级裁判、blueprint debate),但作者指出 LLM 与人类辩论者有本质差异——人类能理性讨论、倾听、反思并更新观点,而”it is still uncertain whether LLM debaters can do the same”,因此重度依赖辩论者理性的协议对 MAD 未必最优;相关工作中还指出”existing MAD frameworks often converge prematurely, suppressing minority viewpoints and failing to simulate real-world adversarial reasoning conditions”。
- 本文的关键观察/假设:既然无法假设辩论者理性,就需要不假设理性、并能识别非理性(尤其易幻觉)辩论者的协议。社交推理游戏提供了范本:所有参与者都可能自己是卧底,必须通过事实或反事实质询来找出卧底。对应到多模态任务,只要人为修改参考图引入反事实证据,就能获得”ground-truth”,从而判定哪些智能体的推理没有跟随视觉事实。
- 三点范式对比:MUG 相对既有 MAD 的三个推进点分别是——(1) Factual Verification vs. Statistical Consensus:用反事实测试做直接事实核验,弥补 LLM 训练中缺乏显式事实核查机制的短板;(2) Cross-Evidence vs. Single-Source:通过改图产生动态的多源证据用以交叉参照,而非依赖单一静态输入;(3) Active vs. Passive Reasoning:反事实测试要求智能体主动提问讨论,而不是被动回答给定问题。
4. 研究方法
- 总体流程(游戏系统):系统 S 由四元组构成——问题 Q、N 个智能体 A={Ai}、辩论函数集合 F 与响应集合 R,t 时刻状态 St = (Q, A, F, Rt);问题本身写作 Q = (Q, I+, I−)。开局一名智能体被赋予反事实图 I− 扮演卧底(Role(Ai)=U),其余为常规辩论者(Role(Aj)=D)。游戏在 Undercover Detection Game(Game(St)=D)与 Summarization Game(Game(St)=M)两种模式间切换:检测到卧底前一直处于检测模式,卧底出局后转入总结模式产出最终答案。
- 反事实图 I− 的生成(Generation of Counterfactual Image):先做跨模态分析确定编辑类型与目标对象(LLM 分类问题 → 预定义编辑类型;对 I+ 建场景图定位目标),再提示图像生成器(Step1X-Edit)执行修改。生成须同时满足三条约束:Maximal Visual Similarity Cvs=SimV(I+,I−)(ViT 嵌入比较,让卧底不易被过早识破)、Semantic Consistency Csc=CLIPS(I+,I−)(CLIP 嵌入比较,保留整体语义)、Naturalness Cna=FID(I−)(避免人工痕迹);生成被接受的条件是 α·Cvs + β·Csc + γ·Cna ≥ c,否则重复生成。作者强调刻意讨论细微差异(而非 captioning 式的宽泛概念)能引导细粒度语义辨析。
- Undercover Detection Game:推理阶段每轮智能体产出 Rti = freason(Q, Ii, Role(Ai), Ht−1);常规智能体按 Rt i = argmax_r [Acc(r,Q,I+) + λ·Det(r,Ht−1)](准确推理+揭露卧底),卧底按 Rt u = argmax_r [Pla(r,Q,I−) − µ·Sus(r,Ht−1)](在反事实图上保持合理并压低被怀疑度)。投票阶段每票 Vt i = argmax _ {j≠i} Σ _ {k=1..4} wk·ϕij k(t),四类信号为不一致性分数 ϕ1、偏离共识分数 ϕ2、细节准确度 ϕ3、行为可疑度 ϕ4;淘汰由多数票决定 ĵ = argmax_j |{i : Vt i = j}|。
- 终止与轮次推进:Tt 为真的条件有三个——卧底被找到(Role(Aĵ)=U)、常规智能体剩余数 |A*| ≤ 1、或超时 t > tmax;否则继续。信息不对称制造的策略张力迫使常规智能体用具体细节自证看到 I+,卧底则必须在合理性与准确性间权衡,从而提升整体推理的细节精度。
- Summarization Game:卧底出局后,剩余智能体按 Rsum_i = fsum(Q, I+, Rt−1_collect, Ht−1) 互相借鉴、结构化对话,最终 Ranswer = fanswer(Rsum, Q, I+);当达成足够共识或超过最大总结轮数时终止。全部辩论函数集合 F = {freason, fsum, fanswer}。
- 训练/推理策略:免训练(无需微调),完全是测试时的多智能体推理协议;关键外部组件为 Step1X-Edit 图像编辑模型与 ViT/CLIP/FID 三项质量校验。
5. 实验结果
- 基座模型:MUG 主要施加于 Qwen2.5VL-7B 与 InternVL3-14B;单智能体对照含开源 DeepSeek-VL-7B、LLaVA-OneVision-7B、LLaVA-Next-Llama3-8B、InternVL2-8B、InternVL3-14B、Qwen2.5VL-7B,闭源 Gemini-1.5-Pro、GPT4o mini (detail-high)、GPT-4v (detail-high)、Claude3.5-Sonnet
- 数据集与基准:MMMU(11,500 道大学级多学科题)、MMStar(1,500 道视觉问题)、HallusionBench(346 个由误导性视觉诱发幻觉的样本)、POPE(3,000 个 yes/no 物体幻觉问题)
- 关键结果:
- MMMU:Qwen2.5VL-7B 从 45.0 提升到 50.3(+5.3),InternVL3-14B 从 59.8 到 60.7(+0.9);MMStar 分别为 61.2→63.8、68.7→69.1
- HallusionBench 平均分:Qwen2.5VL-7B 46.4→53.8,InternVL3-14B 55.1→58.0;其中 figure accuracy 相对基座 Qwen 提升 9.0 分(43.9% vs 34.9%),对 InternVL3 提升 3.5 分(51.2% vs 47.7%)
- 相对多智能体基线的增益:对 MAD-Vote 在 MMMU 上高 5.6 分(50.3% vs 44.7%)、HallusionBench 平均分高 16.0 分(53.8% vs 37.8%);对 MAD-Judge 在 MMMU 高 2.9 分、HallusionBench 平均高 3.6 分;InternVL3-14B 上对 MAD-Vote 的 MMMU 增益为 5.5 分
- POPE:Qwen2.5VL-7B 87.4→88.4、InternVL3-14B 89.3→90.1;recall 分别提升 3.2 分(80.5% vs 77.3%)与 1.7 分(88.2% vs 86.5%);分场景上 random 88.5% vs 86.7%、adversarial 86.3% vs 85.2%、popular 87.3% vs 86.2%
- 类别分析:visual similarity 78.9% vs 69.7%、OCR 86.2% vs 75.4%、figure understanding 66.7% vs 46.3%
- 消融:去掉反事实编辑(w/o Editing)在 MMStar 掉 1.49、HallusionBench 掉 3.61、MMMU 掉 1.08;去掉卧底机制(w/o Undercover)掉幅更大,分别为 1.57、4.49、2.67
- 轮次:性能在第 1 轮达峰(HallusionBench 67.31→69.40、MMMU 47.88→50.33、MMStar 61.93→63.80),继续增加轮次收益递减
- 对比方法:Self-Refine、MAD-Vote、MAD-Judge,以及上列 11 个单模型基线(论文报告相对基线的提升在单侧配对 t 检验下 p < 0.01)
6. 论文结论
- 作者自述贡献:(1) 提出 MUG 协议,把社会推理游戏与反事实测试融入 MAD,用于识别患幻觉的智能体;(2) 在 MAD 三个维度上推进——反事实测试带来的事实核验、动态修改证据源带来的跨证据推理、以及主动追问式的推理;(3) 实验证明 MUG 在多模态推理准确率与幻觉检测上显著优于基线,并能缩小大模型与小模型之间的性能差距。
- 局限与未来工作:正文未设 Limitation 或 Future Work 章节,论文未明确说明局限(录用说明提到的 extended version 未包含在本文本中)。可注意的成本与依赖:每个样本都需调用 Step1X-Edit 生成反事实图并通过 ViT/CLIP/FID 三重校验(不达标需重复生成),再运行多轮多智能体辩论与投票;轮次分析也显示第 1 轮后收益递减。
[5] AAAI2026 — Verb Mirage: Unveiling and Assessing Verb Concept Hallucinations in Multimodal Large Language Models
- 会议:AAAI 2026(arXiv 录用说明:Accepted by AAAI-26)
- arXiv:2412.04939 — https://arxiv.org/abs/2412.04939
- 本地 PDF:
AAAI2026-Verb Mirage Unveiling and Assessing Verb Concept Hallucinations in Multimodal Large Language Models.pdf - 一句话定位:首个系统刻画 MLLM”动词幻觉”的工作:建基准、多角度诊断,并给出富动词知识的微调基线。
1. 中文摘要
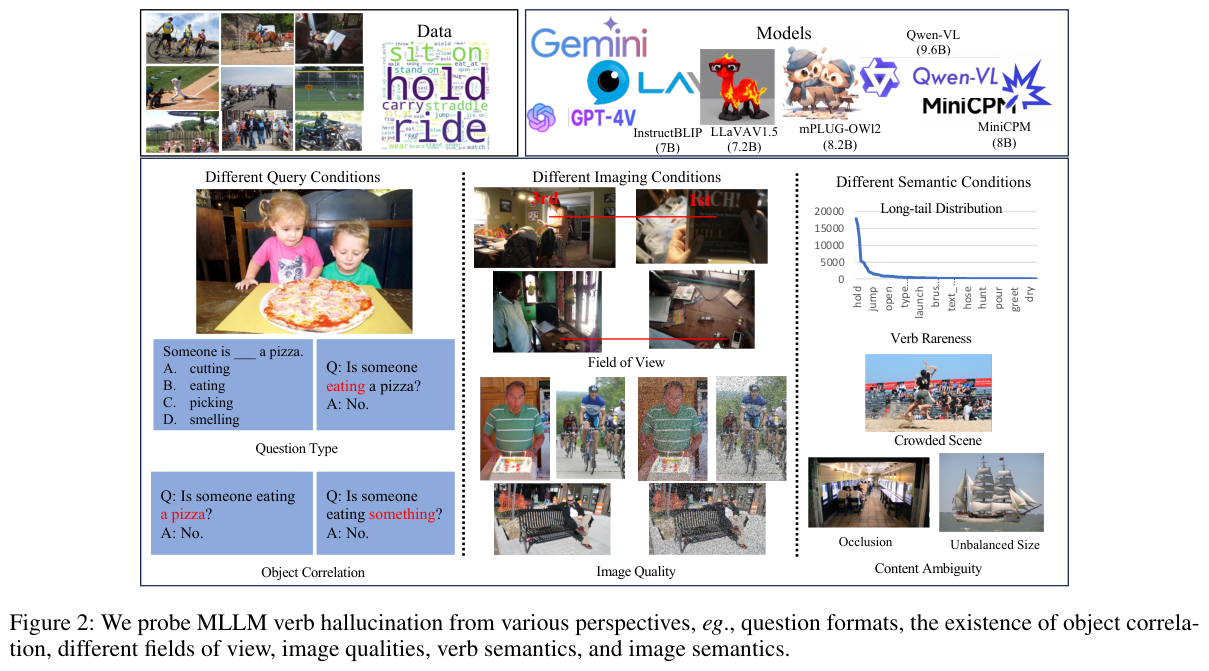
本文指出现有幻觉研究几乎都集中在物体/名词概念上,而理解人类行为至关重要的动词概念被忽视了,因此首次从多个角度系统考察 MLLM 的动词幻觉。作者基于已有数据集 HICO(含 600 个由 80 个物体类与 117 个动词类构成的动作类)与 CharadesEgo(含 157 个动作类、同一场景同时有第一人称与第三人称录像)构建了首个面向动词幻觉的基准,无需额外人工标注:在标签的每个”动词-物体”元组上,只更换动词、保持物体不变来生成问题与选项,从而尽量剥离物体幻觉的干扰。探测维度包括查询条件(MC 与 YN 问题格式、是否给出物体参照)、成像条件(胡椒盐噪声、第一/第三人称视角)、语义条件(动词长尾稀有性、图像内容歧义:人-物尺寸失衡、拥挤场景、遮挡)以及模型行为(关键图像区域注意力、视觉 token 注意力、token 不确定性、mAP 与准确率、视野裁剪)。结论是几乎所有 SOTA MLLM 都存在严重动词幻觉:它们高度依赖物体参照(无物体参照时 MC 准确率大幅下滑)、倾向”不会拒绝”(高召回低精确)、且对视觉失真比物体理解更敏感。随后作者检验了 OPERA、VCD、Nullu 等免训练方法与 REVERIE、Haloquest、Octopus 等微调方法,发现它们都无法有效缓解动词幻觉(作者认为其训练集缺少动词知识)。为此作者给出一个基于富动词知识微调的基线:用 Pangea 按源数据集比例抽 60K 样本、借助 VerbNet 的 290 个高频动词节点建立一对 290 映射构造指令微调集,对 LLaVA V1.5 做 LoRA 微调,动词幻觉显著缓解但作者自评”仍远不令人满意”。
2. 方法图
3. 研究动机
- 现有做法的缺陷:已有基准与缓解方法”mainly target hallucination about objects/noun-related concepts”,而”Action/verb-related concepts, which are crucial to understanding human events, are overlooked”。作者还具体指出 Hal-eval 的事件幻觉通过引入不存在的物体来测试,”can be bypassed by mitigating object hallucination”;而视觉关系虽属关系类,但空间关系、归属、主体-地点关系、属性等占了大多数,并未专门覆盖动词。因此本文聚焦图像中人类行为的理解(human-centric problem)。
- 本文的关键观察/假设:作者观察到所有被测模型在 POPE 上物体幻觉很低(object YN F1 多在 81–88)但 verb YN F1 只有 61–75,呈系统性落差(Figure 1),说明动词幻觉是一个被漏掉且严重的问题。
- 机制层面的洞见:预训练数据中名词数量是动词的 4–10 倍(Figure 4(a)),加上英文本身名词远多于动词,以及 shortcut learning,共同造成 MLLM 对名词的过度依赖——这解释了”无物体参照时性能骤降”。
- 与物体幻觉的本质差异:物体幻觉常被归因于对摘要 token 的过度关注,但作者发现”more attention to visual tokens does not exclude verb hallucination”;LLaVA V1.5 的 mAP(68.41)甚至高于 HICO 微调的 CLIP(60.45),说明它知道图像更可能含哪些动词,问题出在 token 的 mis-calibration。
4. 研究方法
- 总体流程(基准构建):以 HICO 与 CharadesEgo 为主数据集;对每个动词-物体元组,仅替换动词、保持物体不变来生成 YN 与 MC 问题(YN 负样本选对该物体合理但图中未发生的动词;MC 每题 1 个图中出现的动词 + 3 个可能对物体执行但未出现的动词),并用 WordNet 处理同义词与层级问题;引入 circular evaluation,指标为 accuracy / precision / recall / F1。
- 探测维度一:查询条件:比较 MC 与 YN 两种问题格式、以及是否给出物体参照(”Is someone holding a cup?” vs “Is someone eating something?”),以观察动词理解对物体参照的依赖程度。
- 探测维度二:成像条件:加入胡椒盐噪声(每像素以 75% 概率受影响)比较高质量与失真图像下的表现,并用 Cohen’s Kappa 形式的 Error Consistency 度量跨视觉条件的一致性;另用 CharadesEgo 的同一场景第一人称/第三人称录像比较 egocentric 与 exocentric 动词理解。
- 探测维度三:语义条件:把负样本分为 rare 与 common 两个子集(rare 为在同一物体类相关 HOI 中占比不足 20% 的长尾;common 为 hold/ride/sit on/straddle/carry 这 5 个占 HICO 动词标注 50% 的高频动词);并构造 ambiguous 子集(人-物相对尺寸失衡、拥挤场景、遮挡)与非歧义图对比。
- 探测维度四:模型行为分析:定义 Visual Token Attention = mean_j [Σ _ {i∈V}αij / (Σ _ {i∈V}αij + Σ _ {k∈T}αkj)](αij 为最后一层第 j 头对 token i 的注意力权重,V/T 为视觉/文本 token 集合),统计幻觉/非幻觉样本的关键区域注意力、token 概率分布与视野裁剪影响;用 Yes token 概率计算 mAP 并与 HICO 微调 CLIP 对照。
- 缓解基线(rich verb knowledge tuning):用 Pangea 按其源数据集比例抽 60K 样本,借助 VerbNet 选取 290 个高频动词节点建立一对 290 映射以携带动词结构知识,构成指令微调集(覆盖 Pangea P2S 映射中 290 个节点里的 280 个),按常规做法用 LoRA 微调 LLaVA V1.5。
5. 实验结果
- 基座模型:InstructBLIP-7B、LLaVA-V1.5-7B、mPLUG-Owl2、Qwen-VL-Chat、MiniCPM-Llama3-V2.5、Qwen2-VL-7B-Instruct、Molmo-7B-D,以及闭源 GPT-4(GPT-4-Turbo)与 Gemini-1.5(Gemini-1.5-Flash)
- 数据集与基准:HICO、CharadesEgo(自建动词幻觉基准);POPE(作为物体幻觉对照);Pangea(微调数据来源);分析通用能力用 MMMU 与 MathVista;标签语义处理用 WordNet、VerbNet
- 关键结果:
- 物体低幻觉 vs 动词高幻觉(Figure 1):各模型 object YN F1 为 86.14 / 86.10 / 84.56 / 88.38 / 86.70 / 88.46 / 81.82,而 verb YN F1 仅 61.10 / 69.32 / 63.10 / 71.95 / 74.46 / 67.69 / 62.69
- 不会拒绝(Table 1,YN w/ obj):LLaVA V1.5 准确率 52.16 但 recall 97.35、precision 仅 40.99;Molmo-7B-D 为 59.16 / 96.63 / 44.91;MiniCPM-Llama3-V2.5 相对最好,80.91 / 85.41 / 66.83
- 依赖物体参照:InstructBLIP 的 MC 准确率从 w/ obj 的 13.48 掉到 verb only 的 6.25;Qwen-VL-Chat 从 55.95 掉到 54.57
- 视觉失真影响:加胡椒盐噪声后 MiniCPM-Llama3-V2.5 的 YN 准确率从 79.14 掉到 67.40、F1 从 74.46 掉到 57.23;且高排名模型的 Error Consistency 反而更低,说明其动词幻觉易被视觉失真诱发
- 视角差异(Table 4,YN):Qwen2-VL-7B 第一人称 60.10 vs 第三人称 63.01;MiniCPM 59.42 vs 62.00;Qwen-VL-Chat 57.06 vs 60.62
- mAP vs Acc:LLaVA V1.5 的 mAP 为 68.41,高于 HICO 微调 CLIP 的 60.45,说明瓶颈是 token 误校准而非动词知识缺失
- 现有方法失效(Table 5,YN w/ obj acc / F1):LLaVA V1.5 52.16/57.69;OPERA 反而降到 42.46/53.69;VCD 52.38/58.04 且三个模型上效果不一致;Nullu 51.99/57.90;REVERIE 40.67/52.66;Haloquest 70.57/64.89(在含物体参照的 YN 上最高,但 MC w/o obj 仅 47.45)
- 作者基线(Ours,LoRA on LLaVA V1.5):YN w/ obj 78.48/68.13、YN w/o obj 77.37/61.61、MC w/ obj 61.73、MC w/o obj 60.79,全面优于 LLaVA V1.5 与全部对比方法;同时 MMMU 32.2→33.0、MathVista 23.6→24.5,通用能力未严重受损
- 消融/机制证据:Qwen-VL 在 20K 样本上用 VCD 计算的 KL 散度有 18.6K 个为 0,说明 MLLM 理解动词高度依赖语言先验且该先验难以去除
- 对比方法:免训练 OPERA、VCD、Nullu;微调 REVERIE、Haloquest、Octopus
6. 论文结论
- 作者自述贡献:(1) 首次指出并分析 MLLM 的动词幻觉,并在不同条件下进行探测;(2) 研究现有免训练与微调方法对动词幻觉的影响,发现微调仍是最有希望的方向;(3) 从视觉-语言交互与 token 不确定性角度探测模型行为,考察 MLLM 学习动词的程度。
- 局限与未来工作:论文明确表示”how to fine-tune existing models efficiently is still a problem to be explored”,且”whether there are effective training-free verb hallucination mitigation methods is still an open question”;作者自评所提方法虽成功缓解动词幻觉但”its performance is still far from satisfactory”,并提出未来可按结构化动词语义挖掘更多动作数据来微调 MLLM,或将方法接入 MoE 以规避干扰。作者还指出因相当比例的动词是及物动词,物体幻觉的影响无法被完全排除。
批注:动词幻觉这块可能可以做做。
[6] ACL2026 — Aligning with Your Own Voice: Self-Corrected Preference Learning for Hallucination Mitigation in LVLMs
- 会议:ACL 2026(arXiv 录用说明:Accepted to ACL 2026)
- arXiv:2604.24395 — https://arxiv.org/abs/2604.24395
- 本地 PDF:
ACL2026-Aligning with Your Own Voice Self-Corrected Preference Learning for Hallucination Mitigation in LVLMs.pdf - 一句话定位:用模型自己”核验—自纠”生成的同分布偏好对做 DPO,只用 5.2k 样本就压过依赖 GPT-4V 的前作。
1. 中文摘要
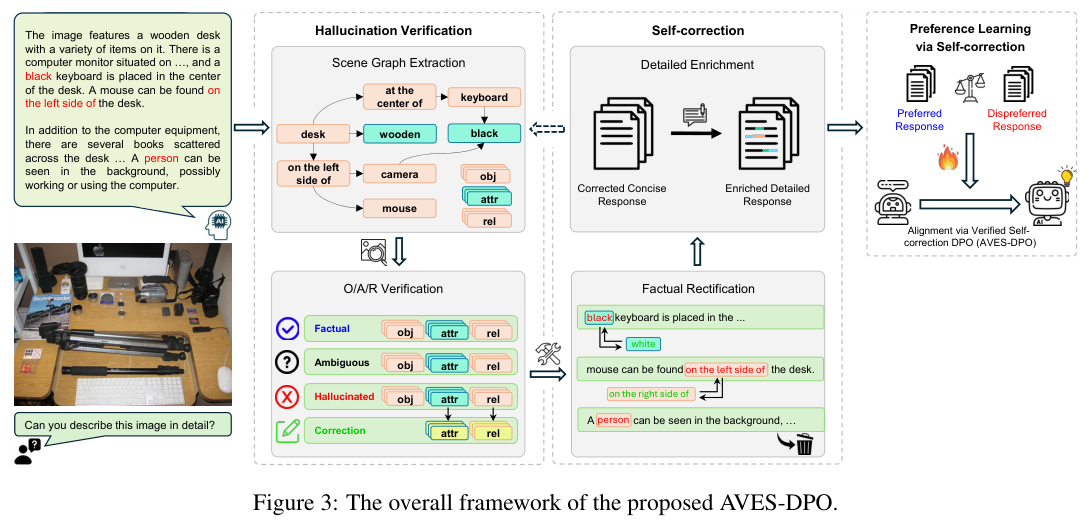
本文指出已有基于偏好学习的 LVLM 幻觉缓解方法大多依赖 GPT-4V 等专有模型构造偏好数据集,而这种依赖会在专有模型与目标模型之间引入分布错配(distribution mismatch),阻碍高效对齐。作者先用一个实证分析验证这一诊断:在 COCO 的 200 条幻觉样本上比较 GPT-4V 纠正与模型自纠,用偏好边际 M(纠正回答与初始回答的平均对数概率差)度量分布偏移,发现专有模型纠正的边际呈较大负值、自纠的边际分布集中在零附近,说明只有自纠落在模型自身分布内。基于此作者提出 AVES-DPO(Alignment via VErified Self-correction DPO),含两个阶段:幻觉核验(Hallucination Verification)与自纠(Self-correction)。核验阶段先把初始回答解析成场景图 G=(O,A,R)(物体、属性、关系),再用两个独立验证模型做共识式判定——两者一致才给出 Factual/Hallucinated 标签,否则记为 Ambiguous;物体核验用 YOLO 与 Grounding DINO,存疑样本再由 Qwen3-VL 系列复核,属性与关系只在已判定为事实的物体上核验,幻觉元素则从 GQA 词表按语义子类检索替换候选。自纠阶段先做 Factual Rectification(删除或替换幻觉内容,得到简洁且事实准确的回答),再做 Detailed Enrichment(补回缺失视觉细节),并用循环迭代过滤把富化文本重新送回核验模块,7B 最多迭代 3 次、13B 最多 5 次,未通过者丢弃以保证数据质量。最终以自纠回答为正例 y+、初始幻觉回答为负例 y− 构造偏好对,用 DPO 损失训练。在 Object HalBench、AMBER、MMHal-Bench、MME 上,7B 模型在超过 60% 的指标上取得 SOTA,且仅需 5.2k 样本(约为 LLaVA-RLHF 的 1/25)。
2. 方法图
3. 研究动机
- 现有做法的缺陷(两条):第一,构造偏好对”Ignores heavily on external supervision from proprietary models such as GPT-4V”,这种依赖引入分布错配——外部模型的生成模式常偏离目标模型的内部固有分布,从而阻碍有效的偏好对齐(pilot study 中 GPT-4V 纠正的偏好边际呈”relatively large negative margin”即是证据)。第二,已有数据集与训练目标”are disproportionately biased towards object hallucinations”,即主要关心物体是否存在,对属性或关系被误述这类细微幻觉处理不足。
- 本文的关键观察/假设:在 COCO 的 200 条幻觉样本上,专有模型纠正的偏好边际分布明显偏向负区,而模型自纠的边际分布”centered near zero”,说明自纠产生的数据本身就在模型内部分布之内,是自然、兼容的学习信号;图 2 进一步显示本文方法(红色)把偏好边际成功推向事实性一侧。
- 推理期方法的局限:LURE、Woodpecker、Pelican、VCD、OPERA 这类推理期方法对超参敏感、跨领域泛化受限,且”predominantly focus on object existence verification”,对属性与关系层面的细粒度幻觉关注不足。
- 效率动机:作者强调摆脱专有 API 依赖同时还能用极少数据取得更好效果,才使方案在成本上可扩展(LLaVA-RLHF 用 122k 样本,本文仅 5.2k,约少 25 倍)。
4. 研究方法
- 总体流程:MSCOCO 训练集图像 + “Describe the image in detail.” 提示产出初始回答 → Hallucination Verification(Scene Graph Extraction → O/A/R Verification)→ Self-correction(Factual Rectification → Detailed Enrichment,含循环迭代过滤)→ 得到 (x, y+, y−) 偏好对 → AVES-DPO 损失做 DPO 训练。
- Scene Graph Extraction:把初始回答 y 转成场景图 G=(O,A,R),O={oi} 物体、A={aij} 属性、R={rijk} 关系;用来源于 GQA 数据集的词表并按语义子类组织,便于在检出幻觉时就近检索同类的替换候选。
- O/A/R Verification(共识式核验):用两个独立验证模型 V1、V2,判定 L(x) = l 当且仅当 V1(x)=V2(x)=l(l∈{Factual, Hallucinated}),否则记为 Ambiguous。物体核验用 YOLO 与 Grounding DINO,被标为 Ambiguous 的物体再由 Qwen3-VL 系列(Qwen3-VL-30B-A3B-Instruct、Qwen3-VL-32B-Instruct)二次核验,两者输出完全一致才更新标签;属性与关系只对 L(oi)=Factual 的物体核验,判定为幻觉时从词表中检索同语义子类的正确属性/关系作为纠错候选。
- Self-correction:Factual Rectification 依据核验结果重构文本(删除或替换幻觉元素)得到简洁准确回答;Detailed Enrichment 补回缺失视觉细节以避免过度简化,并把富化文本送回核验模块做循环过滤——未检出幻觉则通过,否则重回自纠再生成,7B 迭代上限 3 次、13B 为 5 次,超限仍失败的样本丢弃。
- Preference Learning via Self-correction:数据集 DSC 中每个样本为 (x, y+, y−),y− 是核验判为幻觉的初始回答,y+ 是自纠得到的最终富化回答;损失为 LAVES-DPO(πθ;πref) = −E[log σ(β log(πθ(y+|x)/πref(y+|x)) − β log(πθ(y−|x)/πref(y−|x)))],即用 DPO 提高自纠回答、压低幻觉回答的似然。
- 训练/推理策略:LoRA(rank 128、alpha 256)、AdamW、训练 1 个 epoch、β=0.1,全部实验在单张 NVIDIA RTX A6000 Ada GPU 上完成;该方法属训练期对齐(改变参数),推理期不额外添加模块。
5. 实验结果
- 基座模型:LLaVA-1.5-7B 与 LLaVA-1.5-13B(均以 CLIP-ViT-L-336px 为视觉编码器,语言模型分别为 Vicuna-7B 与 Vicuna-13B)
- 数据集与基准:Object HalBench(CHAIRS、CHAIRI)、AMBER(生成与判别任务,含 CHAIR、Cover、Hal Rate、Cog 与 Existence/Attribute/State/Number/Action/Relation 细类)、MMHal-Bench(GPT-4 评分的 Acc、F1、Score、Hal Rate)、MME(通用多模态能力);训练数据图像取自 MSCOCO 训练集,7B 用 5.2k、13B 用 4.6k 偏好对;核验用词表来自 GQA
- 关键结果:
- Object HalBench(LLaVA-1.5-7B):CHAIRS 从 51.4 降到 12.2,CHAIRI 从 14.8 降到 3.9;同规模对比中 SENTINEL 用 8.6k 数据为 12.6/4.0、oDPO 用 19k 数据为 34.3/9.5、POVID 用 17k 数据为 45.8/13.9、HALVA 用 21.5k 数据为 41.4/11.7;LLaVA-RLHF 用 122k 数据为 53.6/14.8
- AMBER(7B):Hal Rate 从 32.5 降到 12.6、Cog 从 3.8 降到 0.9;判别任务 Overall 从 78.8 升到 82.3,Relation 从 58.5 提升到 66.6(SENTINEL 在 Relation 上反而退化到 48.7);13B 的 Relation 从 63.0 提升到 77.5
- MMHal-Bench(7B):Acc 78.8→82.3、F1 83.0→86.9,Hal Rate 0.57→0.53;MME 总分 1455.7→1491.1(但 13B 从 1528.0 降到 1363.6,出现权衡)
- 核验模块的鲁棒性(Table 4):LLaVA-1.5-13B 的 CHAIRS 从 50.4 降到 25.4、CHAIRI 从 14.3 降到 7.6(相对下降 49.6% 与 46.9%);对已较干净的 GPT-4V 也从 29.0/7.9 进一步降到 23.9/5.6,说明核验策略 model-agnostic
- 分布错配消融(Table 5):用 5.2k 专有模型(GPT-4V)监督仅从 51.4/14.8 改善到 38.4/11.4,而自纠方案降到 12.2/3.9
- 数据规模:即便只用 600 样本也能显著降低幻觉率
- 对比方法:VCD、LLaVA-RLHF、HALVA、POVID、oDPO、mDPO、SENTINEL(另以 GPT-4V 外部监督作为分布错配对照组)
6. 论文结论
- 作者自述贡献:提出 AVES-DPO,通过”核验—自纠”从模型自身内在知识生成同分布偏好对,解决外部反馈方法的分布错配问题;提出共识式幻觉核验机制以诊断物体、属性、关系三类多样幻觉;实验证明在多个基准上显著优于基线,且仅需 5.2k 样本即具备极高数据效率(7B 模型在超过 60% 的评测指标上达 SOTA)。
- 局限与未来工作:论文设 Limitations 并明确列出两条——(1) 属性与关系的核验被严格限制在单物体层面(strictly constrained to the single-object level),多物体共现的复杂场景留待后续研究;(2) 13B 模型虽大幅降低幻觉率,但代价是通用基准上的轻微性能下滑,说明随模型规模增大,”抑制幻觉”与”保留广泛预训练知识”之间的权衡更明显,未来指向 scale-aware alignment 策略。
[7] ACL2026 — Benchmarking Deflection and Hallucination in Large Vision-Language Models
- 会议:ACL 2026(arXiv 录用说明:Accepted to ACL 2026)
- arXiv:2604.12033 — https://arxiv.org/abs/2604.12033
- 本地 PDF:
ACL2026-Benchmarking Deflection and Hallucination in Large Vision-Language Models.pdf - 一句话定位:为多模态检索问答建”该弃答还是硬答”的动态基准,区分 deflection 与 hallucination。
1. 中文摘要
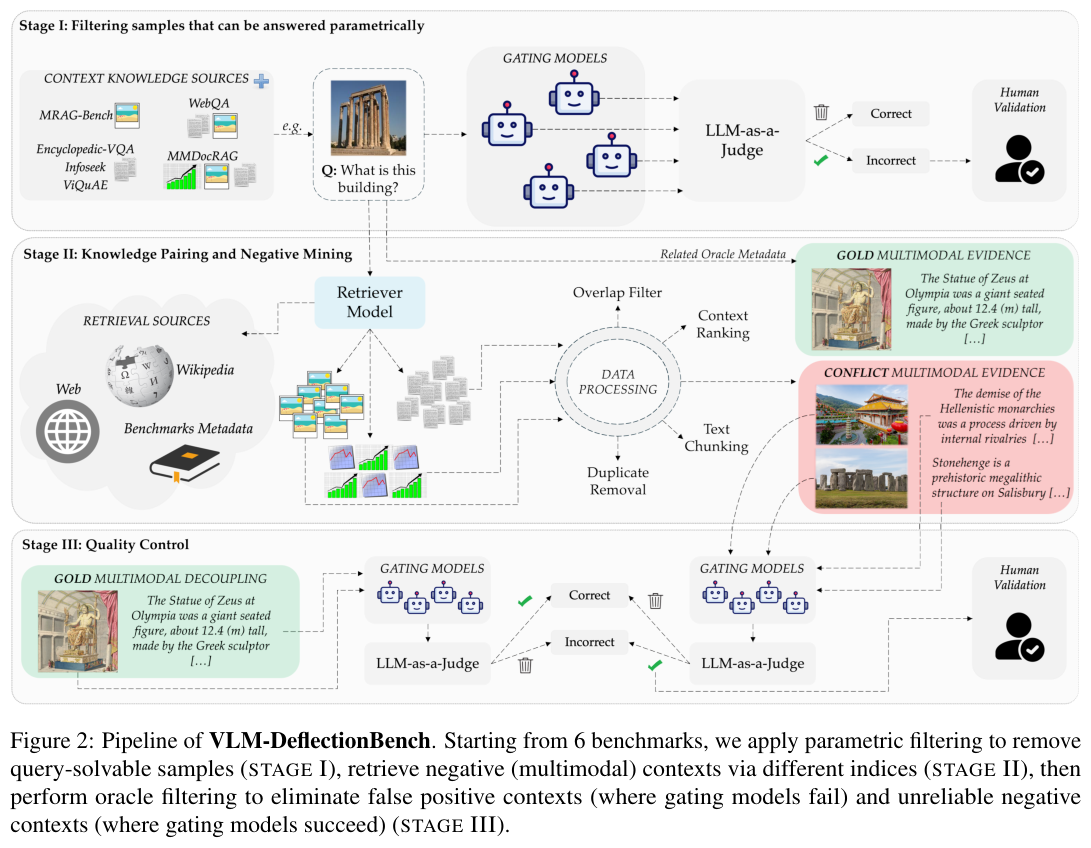
论文指出,面向知识密集型多模态问答的 LVLM 越来越依赖检索,但现有基准既忽略了”图像证据与检索文本证据相互冲突”的情形,也不关心检索知识不完整时模型该不该给出 deflection(如”抱歉,我无法回答”);同时这些基准会快速过时——LVLM 训练集膨胀后,很多题不检索也能答。作者给出三项贡献:一是提出动态数据构建流水线,用 gating 模型在无知识设定下过滤掉可被参数化回答的样本,使基准难度随时间保持;二是构建 VLM-DeflectionBench,共 2,775 条样本,覆盖多种多模态检索场景,每条同时配 gold context 与 distractor context,且全部预先检索以保证可复现;三是设计含 Parametric、Oracle、Realistic、Adversarial 四种场景的细粒度评测协议,把参数化记忆与检索鲁棒性拆开,并用 GPT-4o 配合 SIMPLEQA 协议作为裁判,将输出映射为 Accuracy、Deflection、Hallucination 三类。在 20 个 LVLM 上的实验表明,模型在噪声或误导性证据下大多不会弃答,而是直接幻觉。
2. 方法图
3. 研究动机
- 现有做法的缺陷:作者指出以往 KB-VQA 基准有两个问题,一是 “they suffer from rapid obsolescence: many questions that once required retrieval can now be answered directly from parametric knowledge”,二是 “they focus on accuracy, but do not distinguish failure modes”。此外论文在 Related Work 里强调,早期 OK-VQA/A-OKVQA/ViQuAE 假定每题都可答并”discouraged abstention”,InfoSeek、Encyclopedic-VQA、WebQA 仍是文本中心的(外部知识只以 passage 形式给出,没有视觉检索或多模态干扰项),MRAG-Bench 等虽有视觉上下文,却 “still lack explicit mechanisms for unanswerable queries or for distinguishing hallucination from deflection”。
- 本文的关键观察/假设:在证据不足时,”deflection” 与 “hallucination” 严格来说都算答错,但 deflection 是更可取的失败模式;因此一个可信系统应当”abstain when reliable evidence is absent, rather than hallucinate unsupported answers”。作者据此提出核心问题:can LVLMs deflect when they do not have enough information? 答案是仍然不能。
- 指标缺陷:只测 accuracy 会把”拒答”和”编造”混为一谈,掩盖 hallucination–deflection 之间的权衡。
- 设计取舍:论文刻意不用在线可控性差的实时检索,而是把 gold 与 distractor 上下文全部预先检索好并固定版本发布,从而”preserving comparability through fixed, versioned releases”。
4. 研究方法
- 总体流程:与静态数据集不同,VLM-DeflectionBench 由一条”动态流水线”生成,流水线由强开源模型(gating models)与外部评测器参数化,共三阶段:(i) 过滤掉可参数化回答的样本;(ii) 为保留下来的样本配上 gold 与 distractor 知识上下文;(iii) 质量控制,同时保证可解性与难度。样本记为 x = (q, v, K, a),即问题、可选图像、候选知识与金标答案。
- Stage I — Filtering samples that can be answered parametrically:gating 模型集合 G = {GEMMA3-27B, QWEN-2.5-VL-32B, INTERNVL3-38B, VL-RETHINKER-72B}。每个 G_j 只看问题与图像(无外部知识),由 GPT-4o 搭配 SIMPLEQA prompt 打标签 E(q, â_j, a) ∈ {CORRECT, INCORRECT, NOT ATTEMPTED},并映射为 Accuracy / Hallucination / Deflection。仅保留”所有 gating 模型都答错”的样本:R(x)=1 ⟺ ∀G_j∈G, E(q, G_j(q,v), a) = INCORRECT,得到真正需要外部知识的子集 S₁。
- Stage II — Knowledge Pairing and Negative Mining:为每条样本配 gold K(x)⁺ 与 distractor K(x)⁻。文本负例:用 EVA-CLIP 在 Wikipedia 索引 W_T 上检索候选页,切分成 passage 后用 Contriever 重排,取 top-10 并剔除 gold:K(x)⁻_txt = Rerank(Chunk(top-10(R_φ(v; W_T)))) \ K(x)⁺。视觉负例:在图像索引 W_I 上取 top-10 最相似的非 gold 图像:K(x)⁻_img = top-10(R_φ(v; W_I)) \ K(x)⁺。
- Stage III — Quality Control:两道检查。可解性:若所有 gating 模型在给定 gold 证据时仍失败(∀G_j, E(q,G_j(q,v,K⁺),a)=INC),样本丢弃;干扰项有效性:若任一 gating 模型能靠某个 distractor k⁻ 答对(∃G_j s.t. E(q,G_j(q,v,k⁻),a)=CORRECT),该干扰项被删除。最后强制每条样本至少 K_min = 5 个负例,并在评测前随机打乱正负上下文顺序以模拟真实检索。
- 评测协议:通过控制上下文 Z(x) 定义四场景——Parametric(Z_P=∅,只给问题与图像)、Oracle(Z_O=K⁺)、Realistic(Z_R=K⁺∪K⁻)、Adversarial(Z_A=K⁻)。理想行为分别是:Parametric 准确率极低、Oracle 准确率高、Realistic 在有干扰下仍保持高准确、Adversarial 弃答率最大化,且所有条件下幻觉率都应低。由于模型被要求严格只用给定证据(strict RAG 设定),所有 INCORRECT 一律计为 hallucination。
5. 实验结果
- 基座模型:共评测 20 个 LVLM。开源侧:LLaVA-OneVision、MiniCPM-V-4.5-8B、Keye-1.5-8B、InternVL3-9B、InternVL3-38B、GLM-4.1V-9B-Thinking、Pixtral-12B、Ovis2-16B、Ovis2-34B、Mistral-Small-3.1-24B-Instruct、Aria-25B、Gemma3-27B、Qwen2.5-VL-32B-Instruct、VL-Rethinker-72B;闭源侧:Claude-Sonnet-4、Claude-Opus-4、Gemini-2.5-Flash、Gemini-2.5-Pro、GPT-5(其中 Gemma3-27B、Qwen2.5-VL-32B、InternVL3-38B、VL-Rethinker-72B 同时是 gating 模型)。裁判为 GPT-4o(SIMPLEQA 协议);检索侧用到 EVA-CLIP 与 Contriever。
- 数据集与基准:数据源为 6 个已有基准——InfoSeek(1,646 条,保留率 5.6%)、WebQA(826,16.6%)、E-VQA(185,4.9%)、MMDocRAG(58,1.5%)、MRAG-Bench(45,3.3%)、ViQuAE(15,1.2%),合计 2,775 条、总保留率 5.1%。对比基准(Table 1)包括 OK-VQA、A-OKVQA、E-VQA、InfoSeek、WebQA、MRAG-Bench、ViQuAE、SK-VQA、MMDocRAG。数据全局统计:2,775 条样本、1,246 个唯一问题、2,717 张唯一查询图像、平均问题长度 12.5 词、平均 gold 上下文 1.9 条、平均负上下文 11.8 条。
- 关键结果:
- 参数化过滤有效:Parametric 场景下开源模型准确率近乎为零(LLaVA-OneVision 4.7%、InternVL3-38B 4.8%),证明可参数化回答的样本确实被滤掉;但闭源模型异常偏高,Gemini-2.5-Pro 27.0%、GPT-5 23.7%,作者认为”likely reflecting training-set contamination”。
- 给了金标证据仍幻觉:Oracle 场景下 Ovis2-34B 准确率 66.5%,已超过 Claude-Opus-4 的 49.1%;但 “LLaVA-OneVision hallucinates on 41.6% of queries despite being given the correct evidence”,说明瓶颈在 grounding 而非 retrieval。
- 干扰项使性能崩塌:Realistic 场景准确率普降 10–20 点,Pixtral-12B 从 62.7% 掉到 42.6%(Hall 44.8%),GPT-5 也在 25.5% 的查询上幻觉。
- 对抗场景弃答率仍不足:Adversarial 下 Claude-Opus-4 弃答 88.3%、Mistral-Small-3.1 83.8%,但 Qwen2.5-VL 在 83.9% 的查询上给出错误回答。
- 语言压过视觉的模态偏置(Table 5,Realistic,530 条文本正例 / 266 条视觉正例):正例为文本时模型能较好处理视觉干扰(Claude-Opus-4 视觉噪声下 84.3%);正例为视觉时文本干扰占主导,Keye-1.5-8B 与 Mistral-Small-3.1 准确率崩到 ≤1%,弃答率超过 80%,即使 Claude-Opus-4 也从 35.3% 降到 28.9%。
- 提示严格度的双刃剑(Table 6):Adversarial 下加严提示显著提升弃答,Mistral-Small-3.1 从 57.6% 升到 98.2%、幻觉降到 1.6%,Claude-Opus-4 从 87.0% 升到 92.2%;但 Realistic 下准确率崩塌,Keye-1.5-8B 从 58.7% 降到 36.2%,Mistral-Small-3.1 从 57.7% 暴跌到 9.2%。论文总结 “prompt engineering is a powerful but blunt tool”。
- 对检索噪声的鲁棒性(Figure 3,负例数 1→10):Ovis2-16B 准确率从 59.8% 降到 35.9%,幻觉近乎翻倍(36.5% → 57.6%);Claude-Opus-4 准确率从 42.2% 降到 27.4%,其幻觉率维持在 9–15%;Mistral-Small-3.1 弃答率只从 52.0% 微升到 55.9%,而准确率从 37.5% 崩到 18.3%,说明 “models prefer hallucination over abstention when retrieval is cluttered”。
- 评测可靠性:人工校验显示与 GPT-4o 裁判一致率 >92%、Cohen’s κ=0.91。
- 对比方法:本文是基准类工作,主表并非与方法对比,而是跨 20 个 LVLM 的行为对比;在 Table 1 中与 OK-VQA、A-OKVQA、E-VQA、InfoSeek、WebQA、MRAG-Bench、ViQuAE、SK-VQA、MMDocRAG 在”是否评测幻觉/弃答、场景数、是否动态、多模态查询与上下文、预检索、负例”等维度逐项对照。
6. 论文结论
- 作者自述贡献:① 提出动态 curation 流水线,过滤参数化可解样本,使保留问题在模型变强后仍是真正依赖检索的;② 用该流水线建成 VLM-DeflectionBench,2,775 条样本覆盖多样多模态检索场景,每条配 gold 与 distractor 上下文;③ 定义含 parametric / oracle / realistic / adversarial 四场景的细粒度评测协议,把记忆与检索鲁棒性拆开,并显式度量 hallucination 与 deflection。作者称这是”the first KB-VQA benchmark to combine multimodal retrieval with explicit evaluation of hallucination and deflection”。
- 总体判断:结果说明即使最强的系统在证据不完整时也会幻觉,而在拒答提示过强时又过度弃答,反映模型缺乏”calibrated confidence”;no model achieves balanced reliability——Mistral 过度弃答、Ovis2 只在干净证据下强、Claude 牺牲了 oracle 准确率换取对抗鲁棒性。
- 局限与未来工作:论文在 Limitations 中列出五点:① 评测依赖 GPT-4o + SIMPLEQA 自动裁判,无法完全替代人工标注;② 基准继承了来源数据集的偏置,那些源偏文本中心,可能低估以视觉为主或领域特定的知识;③ 实验只覆盖 license-friendly 或 API 可访问的模型,排除了一些 LLaMA 衍生家族;④ 受推理成本限制,每个查询只跑单次,未做重复采样;⑤ 基准聚焦短问答,扩展到长上下文推理或交互式对话仍待未来工作。另外作者声明无法保证源数据集中不含冒犯性或有害内容。
[8] ACL2026 — Dialectic-Med: Mitigating Diagnostic Hallucinations via Counterfactual Adversarial Multi-Agent Debate
- 会议:ACL 2026(arXiv 录用说明:Accepted by ACL 2026)
- arXiv:2604.11258 — https://arxiv.org/abs/2604.11258
- 本地 PDF:
ACL2026-Dialectic-Med Mitigating Diagnostic Hallucinations via Counterfactual Adversarial Multi-Agent Debate.pdf - 一句话定位:用”证伪而非求证”的三角色对抗辩论加视觉证伪模块,压住医学诊断幻觉。
1. 中文摘要
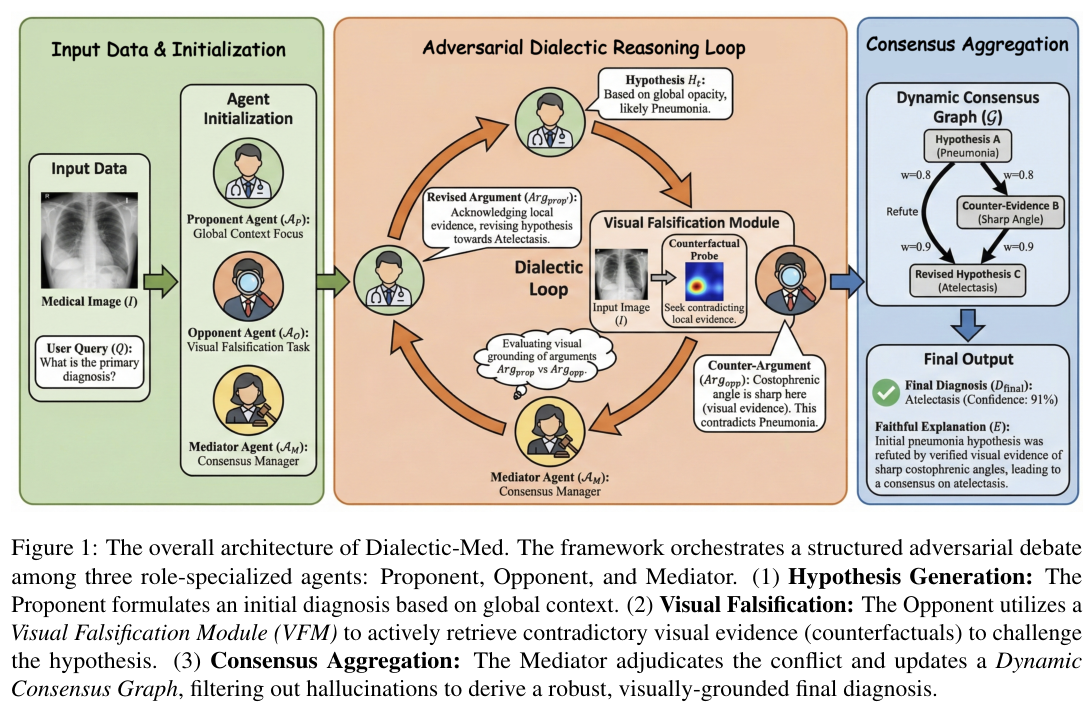
论文指出医疗场景下的多模态大模型存在严重的 confirmation bias:模型会先抓住一个可能错误的诊断假设,再”幻觉”出并不存在的视觉细节来支撑它;而现有 Chain-of-Thought(CoT)类方法缺少内在纠错机制,误差一旦在推理链早期引入就会被后验合理化(post-hoc rationalization)而固化,作者称之为 “Verificationist Trap”。受 Karl Popper 科学证伪哲学启发,论文提出 Dialectic-Med:一个由三个角色专精 agent 组成的对抗辩证框架——Proponent 基于全局图像给出初始诊断假设与理由;Opponent 配备新提出的 Visual Falsification Module(VFM),主动检索与假设相矛盾的视觉证据(反事实探针),并用 patch 级”证伪注意力图”把反驳锚定到具体像素区域;Mediator 通过加权 Dynamic Consensus Graph 裁决冲突并对 Proponent 给出修正反馈。整个推理被形式化为共识图的迭代扩张,最终诊断由累积可信度 Φ(h) 在根到叶路径上积分选出。在 MIMIC-CXR-VQA、VQA-RAD、PathVQA 上,该方法刷新 SOTA,并在 CHAIR 幻觉指标与专家评分的一致性上同时改善。
2. 方法图
3. 研究动机
- 现有做法的缺陷:作者认为 CoT 这类”逐步推理”方法根本上有 “Verificationist Trap”:their linear, forward-reasoning nature lacks an intrinsic mechanism for self-correction; they tend to seek evidence that verifies the current step rather than challenging it。多 agent 方面,现有工作 “most existing approaches rely on static consensus or text-only debate”,即静态共识或纯文本辩论,不做视觉层面的证伪。
- 本文的关键观察/假设:医疗 MLLM 的幻觉根因是 confirmation bias——“A model may latch onto a preliminary textual hypothesis and subsequently ‘hallucinate’ visual features to support this erroneous conclusion”,从而造成级联错误传播。作者据此提出一个 Popper 式假设:a robust diagnosis is established not merely by finding supporting evidence, but by surviving rigorous attempts at refutation(稳健的诊断不是靠找到支持证据,而是靠经受住严苛的驳斥)。
- 落地为工程约束:要把”证伪”变成可执行机制,Opponent 必须能做像素级视觉接地;作者强调 “Unlike models that use implicit attention, our VFM makes grounding explicit and adversarial”,主动去找与假设相矛盾的区域。
- 问题形式化:给定医学图像 I 与诊断询问 Q,目标是得到最终诊断 D* 与忠实解释 E,过程被建模为动态共识图 G_t = (V_t, E_t) 的构造,节点是假设或视觉证据,边编码 support/refute 逻辑关系及其置信权重。
4. 研究方法
- 总体流程(Algorithm 1: MADR, Multi-Agent Adversarial Dialectic Reasoning):输入图像 I、查询 Q、最大轮数 T_max;初始化为 G ← ({h0}, ∅),h_curr ← Proponent(I, Q);随后每轮依次做 ① 视觉证伪 ② 图扩张 ③ 中介修正;图上出现环(IsCyclic)时跳过该修正;循环结束后由 Aggregator(G) 给出 D*,Mediator 再产出解释 E。
- Visual Falsification Module(VFM,核心创新):Opponent 不做纯语义反驳。第一步 Counterfactual Probe Generation:由当前假设 H_t 与领域知识 K_med 生成反事实探针 Q_cf = GenProbe(H_t, K_med)(例如若 H_t 蕴含”应该有 opacity”,则探针指向 “sharp costophrenic angles” 或 “clear lung fields”)。第二步 Falsification Attention:用医学视觉语言编码器 PubMedCLIP 把 Q_cf 接地到图像 patch 嵌入 V={v_1,…,v_N},按缩放余弦相似度 s_i = qᵀv_i /(‖q‖‖v_i‖√d) 再做温度 τ 归一化得到 α_i = exp(s_i/τ)/Σ_j exp(s_j/τ);高 α_i 区域即”反事实前提的视觉支持区”,充当原诊断的”缺失证据”。
- Adversarial Dialectic Reasoning Loop:Phase 1 Hypothesis Generation 由 Proponent 产生 h_0;Phase 2 Adversarial Attack 中 Opponent 取 M_cf 的 top-k 区域 R_k,产出反证节点 e_t = Opponent(I, h _ {t-1}, R_k),攻击强度 S_attack(e_t) = (1/|R_k|)·Σ _ {r∈R_k} α_r;作者特意区分像素级注意力权重 α_r 与图结构边权 w。若 S_attack < θ_thresh 则判为弱攻击、循环终止(Consensus Reached),否则加入证伪边 (h _ {t-1}, e_t) 且 w = S_attack。Phase 3 Mediated Revision 中 Mediator 评估 e_t 的视觉接地性并给出 MediatorFeedback,Proponent 据此生成修正假设 h_t = Proponent(h _ {t-1}, e_t, fb_t),并加入权重取自 Proponent 自报置信度的修正边。
- Consensus Aggregation(动态共识图聚合):对叶节点 h 定义累积可信度 Φ(h) = Σ _ {π∈Π(h0→h)} exp( (1/|π|) Σ _ {(u,v)∈π} log w_uv ),最终诊断 D* = argmax _ {h∈V_leaf} Φ(h),即最能”经受住证伪—修正链”的那条路径;Mediator 再把胜出路径总结成解释 E。这使早期被检索到的高置信视觉反证不会被后续轮次覆盖(对抗 “lost-in-the-middle”)。
- 训练目标(Counterfactual Grounding Loss):为增强 VFM 分辨细微病理的能力,用三元组 (I, Q⁺, Q⁻) 微调(Q⁺ 与金标匹配、Q⁻ 为反事实查询),损失 L_CFG = −log( e^{s(Q⁺,M⁺)/τ} / Σ _ {k∈{+,−}} e^{s(Q^k,M^k)/τ} ),让正例注意力图对齐金标区域、负例注意力图被推开。
- 实现细节:所有多 agent 框架统一限制最多 T_max = 3 轮辩证;VFM 以 PubMedCLIP ViT-B/16 为骨干,在 ROCO 数据集上微调;默认攻击阈值 θ_attack = 0.3、语义相似度阈值 θ_sim = 0.8。
5. 实验结果
- 基座模型:Dialectic-Med 分别以 Qwen3-VL-8B、Qwen3-VL-32B、Claude-4.5 Sonnet、GPT-4o、Gemini-3 Pro、GPT-5.1 为骨干实例化;VFM 骨干为 PubMedCLIP ViT-B/16(ROCO 微调)。对比基线分三类:专用医学 MLLM(LLaVA-Med、Med-PaLM 2)、通用基础模型 + 标准 CoT(GPT-4o、Claude-4.5 Sonnet、Gemini-3 Pro、GPT-5.1,以及 CoT Baseline 组的 Qwen3-VL-8B / Qwen3-VL-32B)、agentic/推理框架(MedAgent、ReConcile、MedVCD、MedMMV)。
- 数据集与基准:MIMIC-CXR-VQA(长上下文临床推理,作者额外筛选出复杂鉴别诊断样本)、VQA-RAD(放射科平衡基准)、PathVQA(病理微观结构细粒度识别)。幻觉度量沿用 CHAIR(CHAIR_S 句级、CHAIR_I 实体级);混合模型公平性实验用 LLaVA-Med-1.5、Qwen3-VL-32B、GPT-4o 组成的异构模型池。
- 关键结果:
- 主干模型上的 SOTA:以 GPT-5.1 为骨干时 VQA-RAD 80.45%、MIMIC-CXR-VQA 76.28%,比单 agent 的 GPT-5.1 基线绝对提升 4.05% 与 8.18%;Gemini-3 Pro 骨干 79.60% / 74.80%,GPT-4o 骨干 78.24% / 72.46%。
- 小模型也超过大模型:仅用 8B 的 Qwen3-VL-8B 骨干,VQA-RAD 得 70.35%,显著超过专用医学模型 LLaVA-Med(56.20%),也超过 32B 模型直接标准 CoT 提示的 68.96%。
- 幻觉显著下降(Table 6,MIMIC-CXR-VQA):相对 GPT-4o 标准 CoT 基线,句级幻觉 CHAIR_S 18.4% → 10.7%(相对降 41.8%),实体级 CHAIR_I 12.1% → 6.5%(相对降 46.3%);中间基线 MedVCD 为 14.2% / 9.8%。
- 专家评测更忠实:三位认证放射科医师双盲评分下 Faithfulness 4.33/5.0,优于 SOTA 的 MedVCD(3.85),相对提升 12.5%(论文 Introduction 中的 12.5% 即指此)。
- 消融(Table 2,MIMIC-CXR-VQA / VQA-RAD 准确率变化):去掉 VFM 改纯文本辩论降 9.31% / 8.99%(”The most catastrophic performance degradation occurs when the VFM is removed”);去掉 Mediator 降 8.11% / 6.89%;退化为单 agent 标准 CoT 降 11.96% / 11.74%;去掉动态共识图、只取最后一轮假设降 3.51% / 3.19%;去掉 grounding 权重降 1.80% / 1.79%;去掉反事实探针降 6.88% / 6.19%;去掉 CFG Loss(零样本)降 2.61% / 2.58%。
- 效率:GPT-5.1 骨干下每查询 4.5k token、每千查询成本 $22.50,远低于 MedAgent(15k / $60.00)与 ReConcile(12k / $48.00)。
- 架构公平性(Table 3,异构模型池):Dialectic-Med 71.82%(MIMIC-CXR-VQA)/ 77.37%(VQA-RAD),仍高于 MedVCD (Mixed) 67.50% / 74.10% 与 ReConcile (Mixed) 64.12% / 72.85%,说明增益来自架构而非单一基座模型。
- 超参敏感性:θ_attack ∈ {0.2,0.3,0.4} 表现稳定(71.85 / 72.46 / 71.92),0.1 过于激进(68.40,高误拒)、0.6 退化为 CoT(66.10,CHAIR_I 升到 11.5);θ_sim = 0.8 为 Pareto 最优,比更宽松配置省约 15% 辩论轮数。
- 定性案例:胸片初判 “Pneumonia” 并幻觉 “patchy consolidations”,Opponent 在 VFM 引导下定位左侧膈肌抬高(α > 0.8),反驳 “The diaphragm elevation indicates volume loss, not consolidation”,Mediator 裁决后最终修正为 “Atelectasis” 并清除幻觉细节。
- 对比方法:LLaVA-Med、Med-PaLM 2、GPT-4o (CoT)、Claude-4.5 Sonnet、Gemini-3 Pro、GPT-5.1、MedAgent、ReConcile、MedVCD、MedMMV,以及 CoT Baseline 里的 Qwen3-VL-8B / Qwen3-VL-32B。
6. 论文结论
- 作者自述贡献:① 提出 Dialectic-Med,作者称是首个把 Popper 式证伪与对抗辩证作为内在纠错机制的医学多 agent 框架;② 提出 Visual Falsification Module,使 agent 能主动检索与特定诊断假设相矛盾的视觉证据;③ 在三个公开基准上验证诊断准确率与解释忠实度的显著提升。
- 核心论断:论文把根因归为 “Verificationist Trap”,并主张把范式从 generative confirmation 转到 discriminative falsification 是部署可信临床 AI 的必要前提;最终结果被总结为在临床”甜点”上实现:大幅削减危及生命的实体级幻觉、最大化专家评分的解释忠实度,同时计算开销只是无约束 agentic 框架的一小部分。
- 局限与未来工作:论文 Limitation 列了四点:① 同步场景下的推理延迟——多轮辩证天然比单遍推理慢,适合异步临床流程(如回顾性报告生成),在极紧急分诊中可能受限;② 视觉瓶颈与 OOD 病理——VFM 效果受骨干 VLM 视觉锐度与预训练分布上界约束,对极细粒度微病理(如 <3mm 结节)或微调数据中罕见的 OOD 病变,Opponent 可能找不到局部反证而”默认假共识”;③ 图聚合的启发式敏感性——依赖 θ_sim、θ_attack 等预设阈值,跨差异极大的医学亚专科部署可能需要领域特定标定;④ Mediator 裁决错误——Mediator 仍由参数化 LLM 驱动,可能残留推理缺陷或因预训练带来的 confirmation bias 而错误否决逻辑上成立的视觉反证。
[9] ACL2026 — Distorted or Fabricated? A Survey on Hallucination in Video LLMs
- 会议:ACL 2026(arXiv 录用说明:ACL 2026 findings)
- arXiv:2604.12944 — https://arxiv.org/abs/2604.12944
- 本地 PDF:
ACL2026-Distorted or Fabricated A Survey on Hallucination in Video LLMs.pdf - 一句话定位:首篇面向视频大模型幻觉的机制驱动综述,按”证据在不在”划出两型四子类。
1. 中文摘要
本文是(据作者自称)第一篇针对 Video LLM(Vid-LLM)幻觉的机制驱动综述。作者把视频幻觉定义为:模型生成语言上连贯、语境上合理,却与输入视频中可观察的时空证据相矛盾的输出。综述的核心贡献是一套分层分类体系(layered classification framework,Fig. 2):一级按”视觉证据是否存在”分成 Dynamic Distortion(实体被感知到,但时空演化或指称一致性被误建模;含 Spatiotemporal Dynamics 的 Order/Dur/Freq 与 Referential Inconsistency 的 Char/Scn)与 Content Fabrication(输出缺乏视觉证据、由统计先验或音频主导;含 Context-Driven Fabrication 的 Obj-Act/Scn-Evt 与 Audio-Visual Conflict 的 Act/Emo),共两型四子类,每类配代表案例与对应基准/缓解方法。作者进一步给出用单条判据(claim 是否有视觉证据支撑)实现的决策清单(Fig. 3),保证分类互斥可操作;并归纳根因:Dynamic Distortion 源于时序表征能力不足(丢失细粒度运动线索,长视频中更被弱长程记忆与差的时间定位放大),Content Fabrication 源于视觉接地不足(让预训练先验或主导音频压过视觉证据)。据此提出运动感知编码器与反事实学习等未来方向。
2. 方法图
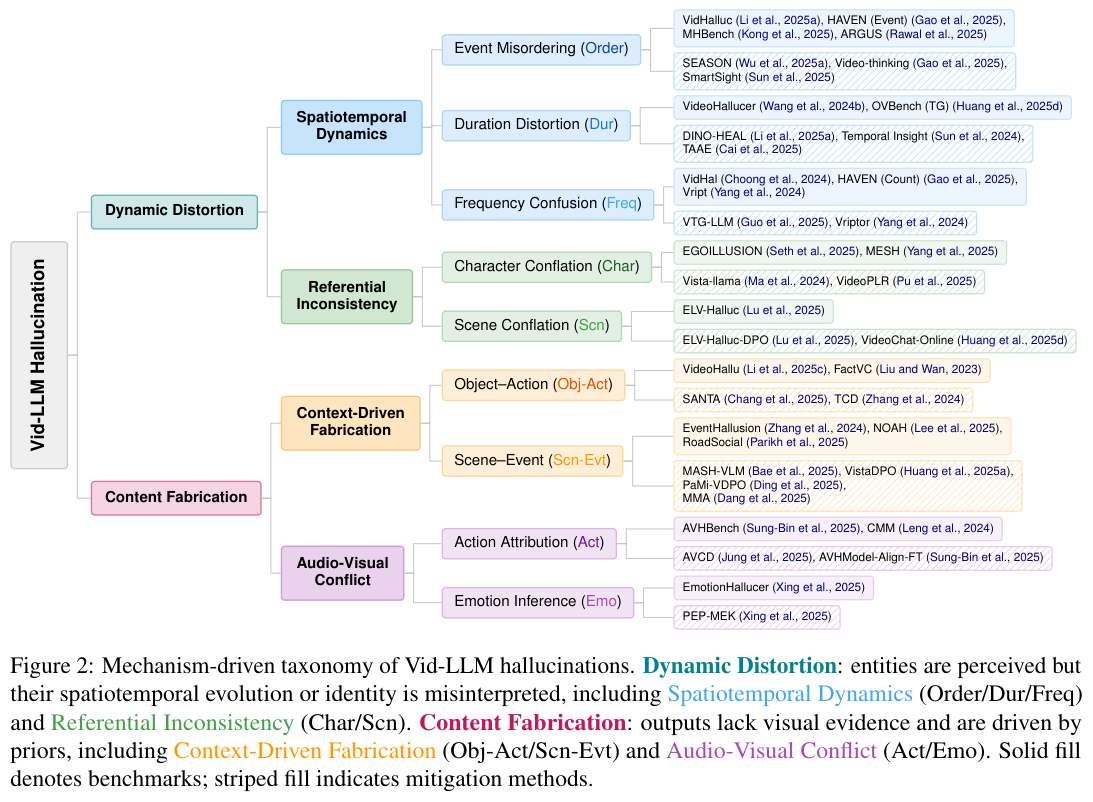
(说明:本文是综述,无实验方法流水线;上图即全文贡献主干——分类体系总览,含 4 条分支、8 个子类代表案例以及每个子类对应的基准(实心填充)与缓解方法(斜纹填充),故作为”方法图”。)
3. 研究动机
- 现有做法的缺陷:图像 VLM 幻觉已被充分综述(Liu et al., 2024a;Lan et al., 2024),但视频固有的时序结构、运动动态与音视频整合使这些结论难以直接迁移。作者进一步批评既有多模态幻觉综述(Sahoo et al., 2024;Bai et al., 2024)虽把视频与其他模态并列,但 “their discussion of video hallucination remains superficial, offering only brief mentions of benchmarks and mitigation strategies without structural or causal analysis”。
- 本文的关键观察/假设:视频幻觉有图像域不存在的独特类型;因此应按”视觉上可观察的失败模式”而非输入属性(音频、时长、题材)来分类。作者的理由是:similar failure modes(如动态关系错误、先验驱动的补全)在各类输入设定下都会出现,若以输入属性为主轴,会把结构上相同的失败拆开,且 “hinder cross-setting comparability”。于是输入属性(视频长度、领域)被降格为影响幻觉严重程度的 conditioning factors。
- 分类可操作性假设:分类只需一条判据——claim 是否有视觉证据支撑;有证据但时空关系/跨段一致性被误建模 → Dynamic Distortion,无清晰视觉证据而由统计先验或非视觉线索驱动 → Content Fabrication。作者用边界案例说明:模型输出 “The person is STANDING UP.”,若坐—站转换可见但被表示错(如颠倒)则是 Dynamic Distortion,若该转换根本不可见则是 Content Fabrication;Audio-Visual Conflict 被归入 Content Fabrication,因为它反映的是音频主导、与视觉证据相悖或超出视觉证据的推理。
- 任务背景:Vid-LLM 已用于动作识别、时序推理、音视频理解,并进入具身智能与自动驾驶等安全关键场景,幻觉直接带来可靠性与安全风险。
4. 研究方法
(综述类论文,此处写它的分类维度、组织逻辑与覆盖范围。)
- 分类维度一:一级的两型。① Dynamic Distortion——模型正确检测到实体,却误表示其时间推进或指称一致性;② Content Fabrication——输出缺乏视觉证据支撑,由学到的先验或音频主导。
- 分类维度二:每型下的两子类(共 4 子类、8 个代表案例)。Dynamic Distortion 下:Spatiotemporal Dynamics(含 Event Misordering / Order、Duration Distortion / Dur、Frequency Confusion / Freq)与 Referential Inconsistency(含 Character Conflation / Char、Scene Conflation / Scn);Content Fabrication 下:Context-Driven Fabrication(含 Object–Action / Obj-Act、Scene–Event / Scn-Evt)与 Audio-Visual Conflict(含 Action Attribution / Act、Emotion Inference / Emo)。
- 分类维度三:判据与互斥性。第 3.3 节给出决策过程:输入一条幻觉输出 → 判断视觉证据是否存在 → 存在则按时空关系与跨段一致性错误归入 Dynamic Distortion,不存在则按先验/非视觉线索归入 Content Fabrication;并把该过程落成 decision checklist(Fig. 3),使分类”empirically separable and mutually exclusive”、跨设定可复现。
- 组织逻辑与覆盖范围:Fig. 2 的每个叶子节点同时挂两类文献——实心填充是 benchmarks、斜纹填充是 mitigation methods;第 4 节按同一分类树梳理评测,第 5 节按同一分类树梳理缓解策略,第 6 节再把根因对应到未来方向(1. 时序与指称保真:video-native encoders 如 VideoMAE、引入光流的 motion-aware connectors、结构化记忆如 Mamba 与 episodic memory;2. 接地与对齐:反事实策略、引入不可能的 object–action 负样本、debiasing 目标,音视频场景中先验证视觉再纳入音频)。第 7 节把分类推广到三类新设定:超长视频、交互/流式、Agentic Vid-LLM,并说明各自映射到哪一类。
- 文献范围说明:综述覆盖已发表研究至 2026 年 1 月(”This survey includes research published up to January 2026.”),并维护持续更新的清单 https://github.com/hukcc/Awesome-Video-Hallucination 。
5. 实验结果
(本文是综述,无自建实验。以下为它整理的代表性基准数据集与结论性统计,均来自 Table 1 / Table 2 与第 4.3、5.3 节讨论。)
- 基座模型:论文未训练或提出基座模型。被综述/对比的模型涵盖 GPT-4o、Gemini-1.5、Gemini-2.0、Gemini-2.5-Flash、Gemini-Pro、VideoChat2-MCD、VideoChat-Online、Valley-Eagle、Vriptor、Comb-GRPO、AVHModel-Align-FT、Video-LLaMA、Video-LLaVA、Video-LLaMA2、Qwen2.5-VL、LLaVA-NeXT、LLaVA-OneVision、Video-R1、InternVL2、ST-LLM、VILA、MA-LMM 等(分布于表格的 SOTA Perf. 与 Reported Gain 两列)。
- 数据集与基准(Table 1 共 19 个视频幻觉基准,按四子类组织):
- Spatiotemporal Dynamics(8 个):VidHalluc(CVPR’25,5,002 视频 / 9,295 QA,ActivityNet、YouCook2、VALOR,MC+Bin,Acc/Score)、VideoHallucer(arXiv’24,948 视频 / 1,800 QA,Bin)、HAVEN(arXiv’25,6.5k QA,COIN、ActivityNet、Sports1M)、MHBench(AAAI’25,1,200 视频,Sth-Sth V2)、VidHal(arXiv’24,1,000 视频 / 3,000 QA,TempCompass、MVBench)、ARGUS(arXiv’25,500 视频 / ∼9.5k 标注,Ego4D、Panda-70M)、OVBench (THV)(CVPR’25,∼33k QA,流式,DiDeMo、QuerYD)、Vript(NeurIPS’24,12k 视频 / 420k QA,长视频)。
- Referential Inconsistency(3 个):EGOILLUSION(EMNLP’25,1,400 自我中心视频 / 8k QA,Ego4D)、MESH(MM’25,∼140k QA,TVQA+、UCF101)、ELV-Halluc(arXiv’25,200 视频 / 4.8k 对抗对,长视频 YouTube)。
- Context-Driven Fabrication(5 个):FactVC(EMNLP’23,300 视频,ActivityNet/YouCook2,Bleu4/Rouge-L)、EventHallusion(AAAI’26,400 视频 / 711 QA,ActivityNet)、NOAH(arXiv’25,9k 视频 / ∼60k 样本)、VideoHallu(NeurIPS’25,987 视频 / 3,233 QA,合成视频 Sora 等)、RoadSocial(CVPR’25,13.2k 视频 / 260k QA,交通场景)。
- Audio-Visual Conflict(3 个):AVHBench(ICLR’25,2,136 视频 / 5.3k 二选一 QA,AudioCaps、VALOR)、CMM(arXiv’24,1.2k 视频 / 2.4k QA,WebVid、AudioCaps)、EmotionHallucer(arXiv’25,230 视频 / 2,742 QA,MER 2023、Social-IQ 2.0)。
- 关键结果(结论性统计):
- 覆盖极不均衡:Table 1 汇总 19 个基准,”with a notable concentration on Spatiotemporal Dynamics (8 benchmarks)”,且大多针对短片段;Referential Inconsistency 与 Audio-Visual Conflict 各只有 3 个基准 “remain underexplored”,并且 “no benchmark addresses audio-visual consistency in long-form videos”;仅 11 个基准提供了专用 baseline。
- 性能两极分化:SOTA 模型在部分任务上很强(VidHalluc GPT-4o 81.2%;EventHallusion GPT-4o 91.93%;AVHBench 上 AVHModel-Align-FT 83.9%;MESH GPT-4o 79.1%;RoadSocial GPT-4o 69.8;CMM Gemini-1.5 88.4/64.2),但在细粒度时序推理与长上下文一致性上明显吃力——VideoHallucer 上 Gemini-1.5 仅 37.8%,ELV-Halluc 上 Gemini2.5-Flash 53.1%,ARGUS 上 Gemini-2.0 为 41%,Vript 上 Vriptor 58.3(F1)。
- 失败的量化归因:FactVC 的分析显示动作一致性问题是 captioning 错误的主要来源,”accounting for 38.3% of failures”。
- 缓解策略进展不均(Table 2):Spatiotemporal Dynamics 与 Context-Driven Fabrication 方法较丰富,Referential Inconsistency 与 Audio-Visual Conflict 仍薄弱。训练类方法增益大(up to 30–36%:VistaDPO +36.5% Acc on Video-LLaVA、AVHModel-Align-FT +33.8% Acc on Video-LLaMA),但训练开销高;免训练策略(SEASON +5.7% Acc on Qwen2.5-VL、SmartSight +2.9% Acc on Video-R1、TCD +3.2% Acc on VILA)模型无关、易部署但增益有限、偶尔推理延迟更高。少数方法增益突出:Temporal Insight +27.9% R@1(Video-LLaMA)、ELV-Halluc-DPO −27.7% SAH(Qwen2.5-VL)、VideoPLR +9.2% Acc、PEP-MEK +9.1% Acc(Gemini2.5-Flash)、VTG-LLM +6.8% R@1、Vriptor +7.5% F1(ST-LLM)。
- 根因结论:Dynamic Distortion often results from missing fine-grained motion cues due to limited temporal encoding,并在长视频中被弱长程记忆与差的时间定位进一步放大;content fabrication arises from insufficient visual grounding,让预训练先验或主导音频信号压过视觉证据。
- 对比方法:综述层面对比的不是单一 baseline,而是把各基准自带的 specialized baseline 与公开 SOTA 表现并列(Table 1 的 Baseline 与 SOTA Perf. 两列),并在 Table 2 中对比 20 余种缓解方法(SEASON、Video-thinking、SmartSight、Temporal Insight、DINO-HEAL、TAAE、VTG-LLM、Vriptor、Vista-LLaMA、VideoPLR、ELV-Halluc-DPO、VideoChat-Online、SANTA、TCD、MASH-VLM、PaMi-VDPO、MMA、VistaDPO、VideoHallu-GRPO、AVHModel-Align-FT、AVCD、PEP-MEK)在 Case、是否免训练(TF)、核心技术与关键机制上的差异。
6. 论文结论
- 作者自述贡献:① 提出(自称首套)面向 Vid-LLM 的机制驱动分层分类体系,把幻觉分为 Dynamic Distortion 与 Content Fabrication 两型、各两子类并配代表案例;② 依该体系系统梳理评测基准、指标与缓解策略,并首次做结构化与因果分析(相对于以往综述的”只提基准与缓解”);③ 分析幻觉根因并据此给出未来方向,形成一份连贯路线图。此外第 7 节把体系推广到超长视频、交互/流式、Agentic Vid-LLM 等新兴设定。
- 总体判断:视频幻觉与静态图像任务有本质不同的模式;referential inconsistency 与 audio-visual conflicts 仍是明显空白;现有缓解策略多作用在推理时或后训练阶段,说明 “the need for scalable, training-time alignment methods”。
- 未来方向(作者主张):开发保留运动线索的 video-native encoders、引入显式记忆机制支撑长期时序接地、用反事实学习把模型推理与先验驱动的联想解耦,从而构建可信且时序忠实的视频语言系统。
- 局限与未来工作:Limitations 中作者说明:以往 MLLM 幻觉综述对视频部分覆盖有限、缺乏结构化分类与因果分析,本文填补该空白;但 “some relevant work may be omitted”,且综述收录范围截止到 2026 年 1 月发表的研究。论文也指出目前 datasets 多限于短视频片段,音视频冲突与长视频一致性评测仍需更多基准建设。
[10] ACL2026 — Faithful-First Reasoning, Planning, and Acting for Multimodal LLMs
- 会议:ACL 2026(arXiv 录用说明:Accepted by ACL 2026 Findings)
- arXiv:2511.08409 — https://arxiv.org/abs/2511.08409
- 本地 PDF:
ACL2026-Faithful-First Reasoning, Planning, and Acting for Multimodal LLMs.pdf - 一句话定位:把”感知忠实”当设计约束而非事后指标,边生成边验证每个推理步。
1. 中文摘要
论文指出 MLLM 的推理链普遍不忠实:解释与视觉证据脱节,或与最终预测自相矛盾,而这并非提高任务准确率或把 CoT 写得更丰富就能解决。作者区分了 behavioral faithfulness(推理步与模型输出一致,以往研究的主要关注点)与 perceptual faithfulness(推理步必须落在输入图像中可验证的实体/属性上,本文关注点),并提出 Faithful-First RPA 框架。框架含两个部件:FaithEvi 是一套基于证据的感知忠实度评测流水线,先用 helper LLM 从每个推理步抽取”被声称的对象”,再通过 preference polling(冻结 CLIP-ViT-Large 加轻量 MLP 头,在 POPE 的二值标签上训练)估计对象存在概率,并用 GroundingDINO-base 做区域定位确认,把两者融合成对象级置信度,经三级映射得到步级分数 F_step,t 与链级分数 F_chain;FaithAct 则以这些信号驱动推理时的忠实度感知规划与动作,遵循 verify-as-you-generate 而非先生成后验证,通过 Poll/Ground/Select/Abstain/Count 等可调用函数与动态阈值决定每一步是否被接纳,未达标步会被动作引导地重写。在 LLaVA-Bench、RealWorldQA、POPE、MMHal 上,FaithAct 的感知忠实度在 11/12 个设定中最高,且不损害任务准确率。
2. 方法图
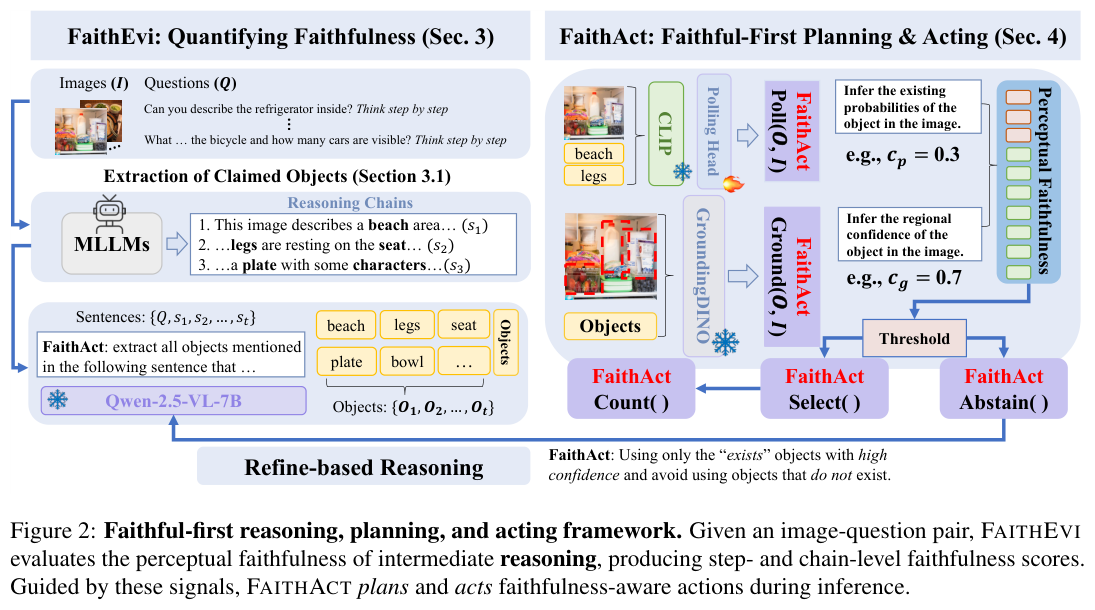
3. 研究动机
- 现有做法的缺陷:现有工作 “typically focus on improving task accuracy or enriching CHAIN-OF-THOUGHT (CoT) generation, yet the unfaithful reasoning remains unaddressed”。作者观察到 MLLM 会产生 “persuasive explanations that conflict with perceptual evidence, or utilize post-hoc rationalizations fabricate their reasoning progress”(后验合理化)。行为忠实度本身也难用:它依赖模型不可观测的内部决策过程。
- 本文的关键观察/假设:作者提出一条原则——“A perceptually faithful model reasons only over what is visually observable; it does not ‘see’ what the image does not reveal.”(感知忠实的模型只对视觉上可观察的内容推理,不去”看见”图像没有揭示的东西)。据此假设:只要推理保持感知接地,行为一致性往往会随之而来,无需额外优化输出正确性。
- 概念切分(论文最值钱的部分):把不忠实拆成两类——behavioral faithfulness(BF,推理轨迹是否反映导致最终输出的决策过程)与 perceptual faithfulness(PF,单个推理步是否扎根于可验证的输入证据)。Fig. 1 给出两种病态:左侧是”感知与行为都不忠实”(箭头方向/圆点数量的推理与真实决策无关,答案是靠模式联想选的、解释是事后编的),右侧是”感知不忠实但行为忠实”(推理与答案一致,却因旁边有黄色巴士而把自行车描述成黄色)。
- 范式主张:作者主张 “FAITHFULNESS SHOULD BE A DESIGN PRINCIPLE, NOT MERELY A POST-HOC EVALUATION OBJECTIVE”——每一步在进入推理链之前就应先验证其证据接地性;并指出感知忠实度可操作、可度量(每步都能对照多模态证据验证),行为忠实度只能当作结果而非可控目标。
4. 研究方法
- 总体流程:框架 = FaithEvi(量化忠实度)+ FaithAct(忠实度优先的规划与行动)。输入是图像 I 与文本查询 Q,MLLM 经 “think step by step” 提示产生推理链 R_raw = {s_1,…,s_T};FaithEvi 输出步级 F_step,t 与链级 F_chain,FaithAct 用这些信号在推理时规划并执行动作。
- FaithEvi 第一阶段 — Extraction of Claimed Objects:用 helper LLM(Qwen2.5-7B-Instruct)配合结构化提示,对 Q 与每个 s_t 的拼接文本抽取有视觉意义的名词性对象,剔除 “Let’s begin reasoning”、”Therefore, the answer is…” 这类引导/结论句,每步得到对象集 O_t = {O_t^1,…,O_t^{m_t}},全链并集记为 O = ∪_t O_t,使后续接地与轮询只作用于与视觉相关的内容。
- FaithEvi 第二阶段 — Preference Polling 与 Grounding:先用轻量轮询模块做”证据闸门”,因为目标检测器在遮挡、杂乱、低显著度时置信度不可靠。轮询用冻结的 CLIP-ViT-Large 得到 v = f_img(I)、t = f_text(X),做逐元素积 v⊙t 捕捉跨模态交互,再经两层 GELU MLP 头输出存在置信度 c_p = σ(W_2 GELU(W_1(v⊙t))),W_1∈R^{512×d}、W_2∈R^{2×512},该头在 POPE 的二值图像—对象存在标签上训练。接地阶段用冻结的 GroundingDINO-base 检测对象,返回候选框 B_t^i 与置信度 C_t^i,取最大值 c_g,t^i = max_j c_t^{i,j} 作为区域级证据。
- FaithEvi 第三阶段 — Faithfulness Scoring:对象级置信度融合存在性与定位两个信号 c_t^i = α·c_p,t^i + (1−α)·c_g,t^i,经验取 α = 0.7;经三级映射把连续置信度离散化(c<0.4 → 0,confidence absent;0.4≤c≤0.6 → c,uncertain;c>0.6 → 1,confidently present);步级分数 F_step,t = (1/m_t)Σ_i f_t^i,链级分数 F_chain = (1/n)Σ_t F_step,t(n 为去掉引导/结论句后的推理步数)。
- FaithAct — Planning 与 Acting:不像常规”先生成后验证”,FaithAct 遵循 verify-as-you-generate,每一步在加入链之前先显式检查感知支持。规划目标被写成带约束的优化:S* = arg max F_step(s_t) s.t. ∀t F_step(s_t) ≥ c,即只有证据支持足够强的步骤才有资格推进推理链;若某步 F_step(s_t) < c 则先细化或重新生成。执行层由一个轻量指令微调 MLLM 担任 reasoning controller,组合 SELECT / ABSTAIN / COUNT 等可执行步骤。
- 可调用函数接口:Poll() 返回对象存在概率;Ground() 返回 GroundingDINO 给出的框与置信度;Select() 在置信度超过阈值时把对象判为存在;Abstain() 在整体置信度低于阈值时弃选;Count() 统计可靠接地的框数,用于定量推理。其中只有 COUNT() 是功能性推理操作,其余都是施加感知忠实约束的验证函数;接口可扩展(如 Attribute()、Relate())。
- 动作引导的推理细化:未达阈值的步骤不是直接丢弃,而是带着评测器的新证据(对象存在标签、边界框、计数)重新调用 MLLM 进行重写,使轨迹既保持逻辑连贯又与感知证据一致。
5. 实验结果
- 基座模型:Qwen-2.5-VL-7B(Qwen)、InternVL3-8B(InternVL)、LLaVA-one-Vision-1.5-8B(LLaVA)。辅助模型/工具:Qwen2.5-7B-Instruct(对象抽取 helper LLM)、CLIP-ViT-Large(冻结,轮询编码器)、GroundingDINO-base(冻结,接地检测器),消融中另用 SAM3 替换 GroundingDINO。
- 数据集与基准:LLaVA-Bench、RealWorldQA、POPE(评测时把被问到的对象移除以保证公平)、MMHal-Bench(MMHal);另在感知需求较弱的 MathVista 与 ScienceQA 上做了补充评测。对比方法均为免训练推理框架:CoT、ReAct、Grounded-CoT、Visual Abstract Thinking(VAT)。超参:GroundingDINO box threshold 0.35、text threshold 0.25。
- 关键结果(指标为链级感知忠实度 F_chain,%):
- 整体最强:跨模型平均 FaithAct 达 55.86%,比最强的基线范式 ReAct(48.10%)高 7.76 个百分点,比 CoT 高 9.04%;”our method attains the highest faithfulness in 11 out of 12 evaluated settings”。
- 单点对比:InternVL 在 RealWorldQA 上 44.23±25.43(+CoT)升到 57.35±29.40(+FaithAct);Qwen 在 MMHal 上从 53.34±24.02(+CoT)升到 66.45±27.87(+FaithAct),而 InternVL + Grounded-CoT 在该集仅为 18.10±14.96。
- 当前模型普遍低估证据支持:Qwen 等模型在各数据集上的忠实度只有 ∼50,远低于理想值(接近 100)。
- 幻觉缓解:FaithAct 并非为缓解幻觉而设计,但在 MMHal 上 “achieving an average improvement of 21.99% and 9.81% over tool-augmented prompt-based reasoning frameworks”(即相对工具增强与提示式框架的平均提升)。
- 不牺牲任务准确率(Table 2):RealWorldQA 上 Qwen 70.1 → 74.5、InternVL 70.8 → 71.2、LLaVA 68.1 → 67.8;MMHal 评分上 Qwen 3.40 → 3.48、InternVL 3.61 → 3.58、LLaVA 3.41 → 3.46,在三个数据集中的两个上略有提升。
- 后期步收益更明显:Fig. 4 显示 F_step 的改善在推理链靠后的步骤上尤为突出,说明干预在更深推理时最有效。
- 消融(Table 3,Qwen):去掉 Poll() 忠实度降到 54.24±28.13、去掉 Ground() 降到 53.16±29.12,相对完整的 57.22±27.85 都下降约 5%,其中 Ground() 影响略大,说明区域定位提供关键视觉证据,两者互补。
- 替换接地器:把 GroundingDINO 换成 SAM3 后性能 “drops obviously (5% on REALWORLDQA and more on MMHAL)”,作者认为 FaithAct 需要能给出可靠置信度的定位专用模型。
- 阈值敏感性(Table 4,Qwen/RealWorldQA):α 与阈值的组合在 0.3-0.7 到 0.7-0.6 间变化不大(55.76 到 57.44),仅 0.5-0.5 组合略降至 52.5 左右。
- 感知需求较弱的基准(Table 6):MathVista 上 FaithAct 47.65±24.73 vs CoT 47.00±23.91(略好),ScienceQA 上 52.97±32.63 vs CoT 40.14±32.88。
- 计算开销(Table 5,Qwen-2.5-VL-7B):FaithAct 每链 18.85s / 14.04s / 16.48s / 14.72s(LLaVA-Bench / RealWorldQA / MMHal / POPE),CoT 对应 10.73 / 4.65 / 5.59 / 3.41s,δ Time 为 8.12 / 9.39 / 10.89 / 11.31 秒;论文指出它不修改底层生成函数或解码过程,故 token 生成速率与原始 CoT 相同。
- 人验(对象抽取环节):50 个 snippet、25 位标注者、共 7,550 个对象级标签,抽取精度 99.42%,仅 44 个假阳(过度抽取率 0.58%),1,250 个标注者—snippet 对的平均 snippet validity 为 0.9680。
- 定性案例:基线模型受语言先验影响把自行车说成黄色且称没有汽车,FaithAct 逐步感知验证后给出”黑色自行车与两辆车”;第二个序列题中把 (C) 中向上的箭头纠正为向右。
- 对比方法:CoT、ReAct、Grounded-CoT、VAT(Visual Abstract Thinking),均为免训练推理框架;另在定性分析中引用 Wu et al. (2025b) 关于过长 CoT 增加后段噪声的发现。
6. 论文结论
- 作者自述贡献:① 提出 FaithEvi——基于证据的感知忠实度评测流水线,逐步抽取被声称对象并在局部与全局层面用 preference polling 和 visual grounding 验证,输出步级 F_step,t 与链级 F_chain,构成通用的定量度量;② 提出 FaithAct——忠实度优先的规划与行动机制,用 FaithEvi 信号评估当前链的忠实度并决定可接纳的下一步,在动态阈值下执行忠实度感知动作,以轻量可扩展的可调用函数接口实现;③ 实验表明当前 MLLM 一致地低估推理过程中的证据支持,而强制逐步验证能显著提升感知忠实度且不牺牲任务准确率,同时有效缓解内容幻觉。
- 核心论断:作者主张把 “FAITHFULNESS SHOULD BE A DESIGN PRINCIPLE” 落地后,感知忠实度最高且幻觉被有效抑制;实验还显示感知接地可能与行为一致性正相关,但这一关系在本文中未被显式测量。论文结论称该框架把感知忠实度提升最多 24% 且不损害准确率(摘要与结论均使用 “up to 24%” 的说法,正文给出的可比数字是跨模型平均 55.86% vs ReAct 48.10%、以及 MMHal 上的 21.99%/9.81%)。
- 局限与未来工作:论文 Limitations 明确三点:① 只聚焦感知忠实度,不直接评估行为忠实度(推理轨迹与模型最终决策过程的一致性),实验虽提示感知接地可能伴随更一致的行为,但该关系未被显式测量或保证;② 虽然做了对象抽取的人验(LLM 抽取对象总体准确),但没有对步级/链级感知忠实度做大规模人工评测,不同粒度的人工研究有待补充;③ 当前实现主要在”对象是否存在”层面验证感知忠实度,扩展到属性级与关系级验证是重要未来方向,可进一步减少”对象存在但其属性或关系被误述”造成的感知不忠实。结论部分亦提到未来工作将扩展到行为忠实度与更具挑战的开放式推理场景。
[11] ACL2026 — Mechanisms of Prompt-Induced Hallucination in Vision-Language Models
- 会议:ACL 2026(arXiv 录用说明:ACL 2026 Main)
- arXiv:2601.05201 — https://arxiv.org/abs/2601.05201
- 本地 PDF:
ACL2026-Mechanisms of Prompt-Induced Hallucination in Vision–Language Models.pdf - 一句话定位:在受控数数任务里定位”抄提示”的注意力头,敲除后免训练大幅降幻觉。
1. 中文摘要
论文研究 VLM 的 prompt-induced hallucination(PIH):模型宁可服从文本提示也不看图像证据。作者把它放进可控的物体计数场景——提示故意夸大图中物体数(例如图里只有三朵睡莲,却要求”描述四朵睡莲”)——从而把提示与视觉证据的冲突量化为偏移量 k。实验覆盖 LLaVA-OneVision-7B、Qwen2-VL-7B、Janus-Pro-7B 三个 VLM 与 CountBench 数据:当真实物体数较少(2–4)时模型多半能纠正提示里的夸大,只在 k 很小时仍有约 20–40% 的 PIH;一旦真实数超过四个,模型就几乎无差别地服从提示,提示对齐率升到 80–90%、真值匹配率降到接近零,连 k∈{10,20,50} 的极端偏移也照抄。作者接着用 mean ablation 做逐头 knockout,按”从提示数切回真值数”的样本比例排序,再做分组敲除(m∈{1,3,5,10}),得到每个模型的 PIH attention heads(Qwen-VL 取 m = 3,LLaVA-OneVision 与 Janus-Pro 取 m = 10)。敲除这小组头可在不训练、不加数据的前提下把提示匹配率从 42–64% 压到 11% 以下、真值匹配率提到 70–78%,且基线计数与 CalTech101/MM-Vet/POPE 等通用能力基本不变;同样的头还能迁移到颜色识别任务,把 prompt-color copying 最多降低约 94%。机制分析显示这些头集中在语言模型早期层,Qwen-VL 与 LLaVA-OneVision(共享 Qwen2 语言骨干)的头高度重合,说明 PIH 主要由语言模型内部的信息路由介导,但三个模型抑制”抄写”的具体方式各不相同。
2. 方法图
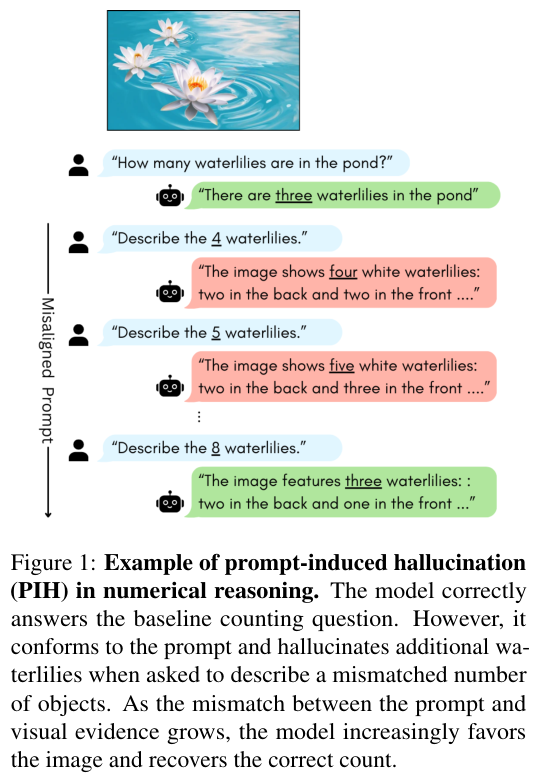
(选图说明:本文属机制可解释性研究,全文没有任何 architecture / pipeline / framework 总览图;Figure 2、3、6、7 是 PIH 率与基础概率的曲线,Figure 4、5、9、10 是敲除前后注意力质量与概率变化的柱状图,Figure 8 是注意力热力图,均属结果图。最接近”方法总览”的是 Figure 1:它用带箭头的对话流完整给出本文的实验范式——基线提示 “How many waterlilies are in the pond?” 与错配提示 “Describe the 4/5/8 waterlilies.”,以及模型在偏移增大时从服从提示回到视觉证据的行为,即 PIH 的构造与度量方式;而真正的干预步骤(mean ablation 的逐头 knockout、分组敲除与 top-m 选取)在正文 4.1 节与附录 D/E 中用文字与算法描述,没有配图。)
3. 研究动机
- 现有做法的缺陷:VLM 在文本提示与视觉证据冲突时倾向于文本(”current VLMs tend to disproportionately prefer textual information”)。以往的 LLM 幻觉研究多依赖 out-of-distribution 提示、超长上下文或显式人格设定等 “adversarial or non-realistic usage patterns, rather than the models’ behavior under typical user interactions”;作者希望研究来自 minor, realistic inconsistencies 的模态冲突。
- 本文的关键观察/假设:PIH 很可能不是数值推理能力不足——模型在直接问”有几朵”时答对,却在被要求”描述四朵”时编出本不存在的花。可见这是”提示诱导”而非”计数失败”。作者进一步假设:模型在数少物体时更自信、因而更抗错配提示,失败会集中在最小偏移(k = 1)附近。
- 任务背景:物体计数被选作干净的可控设定——真值可核验、数值偏差可精确控制、错误可显式度量。作者同时澄清为何这算幻觉而非单纯指令跟随:(1) 提示用 “in the image” 明确接地,(2) 模型描述了图中并不存在的物体。
- 机制层面的假设:以往工作显示注意力头常承担信息复制、上下文追踪等具体功能,而 MLP 更偏参数知识存储,因此作者把分析集中在注意力头上,并假设敲除 PIH 头可能通过”抑制复制”或”增加对图像的注意力”两种机制之一起效。
4. 研究方法
PIH 的受控构造:对每张真值为 N 的图,先用基线提示 P_B = “How many [objects] are there in the image?”,只保留模型答对 N 的样本;再用错配提示 “Describe the N + k [objects] in the image”,k ∈ {1,2,…,5} 表示提示与视觉输入的偏差距离(另做 k ∈ {10,20,50} 的极端偏移)。当模型描述了 N + k 个物体而不纠正计数时即记为 PIH。
Attention Head Knockout(核心方法):用 mean ablation
对某个头,将各 token 位置的输出替换为该头在序列上的平均输出
做注意力头敲除,直觉上是移除该头携带的 token 特异信息但保留其整体激活量级(技术细节见附录 D)。逐头施加干预,把 knockout success 定义为”在错配提示下,从提示数切换到真值数的样本比例”,据此排序取每模型 top-m 头;随后做第二阶段分组敲除(同时敲除全部 top-m 头),m ∈ {1,3,5,10},最终选定 m = 3(Qwen-VL)与 m = 10(LLaVA-OneVision、Janus-Pro)作为每模型超参,这组头称为 PIH attention heads。
对照与鲁棒性设计:为证明效果来自 PIH 头而非”任意敲除”,从 PIH 头所在层中随机抽取同等数量的头做 random baseline;并检验敲除是否损伤常规计数(基线提示的 exact match、被描述的物体是否仍正确)与通用能力。
功能分析三件套:① 复制形态分类——把响应分为 no-copying(NC)、format-copying(FC)、soft-copying(SC)、exact-copying(EC),并区分正确/错误,比较敲除前后分布;② 注意力质量迁移——逐层计算 assistant token 分配给 image token 的注意力占比(与 text 互补,和为 1),找变化最大的层;③ 数字/单词形式概率——用 “Describe the N_digit [objects]” 提示,比较敲除前后 P(N_digit|N_digit) 与 P(N_word|N_digit),用单个 token 把 format copying 与 soft copying 分开。
跨任务泛化验证:把同一组 PIH 头直接用到颜色识别任务上——基线提示 “What color is the [object] in the image?”,错配提示 “Describe the C + k [object]”,C 为真值颜色、k ∈ {1,2,3} 表示色轮上的感知距离,数据来自 Visual CounterFact。
5. 实验结果
- 基座模型:LLaVA-OneVision-7B、Qwen2-VL-7B、Janus-Pro-7B(Qwen-VL 与 LLaVA-OneVision 共享 Qwen2 语言骨干,但视觉编码器与融合结构不同)。论文未报告更大规模模型。
- 数据集与基准:CountBench(计数主任务)、Visual CounterFact(颜色任务)、CalTech101(改造为”仅当图中含某物体时复述句子”的受控复制指令任务)、MM-Vet、POPE(通用多模态能力)。
- 关键结果:
- PIH 随物体数上升而失控:2–4 个物体时橙色(真值)曲线多高于蓝色(提示)曲线,但仍约 20–40% 出现 PIH,且主要发生在 N+1;超过四个物体后模型 “increasingly conform to the prompt regardless of the discrepancy size”,提示匹配响应逼近 80–90%,真值响应降到接近零,且偏移大小不再重要(蓝线收敛);极端偏移下模型会给只有 9 只猫的图描述”59 只猫”。
- 自信度与 PIH 相关:N ≤ 4 时 p(N|P_B) 高、p(N+k|P_B) 低,N ≥ 5 时基础置信度下降、邻数概率上升;Pearson 相关系数 ρ = 0.37(Qwen-VL)、0.46(Janus-Pro)、0.1(LLaVA-OneVision)。
- 敲除显著压制 PIH(Table 1):错配提示下的 prompt match 从 LLaVA-OV 42.58%、Qwen-VL 56.51%、Janus-Pro 64.10% 降到 1.42%、3.22%、10.19%(即 42–64% → 低于 11%);真值匹配率同步升到 77.80%、70.66%、70.90%(”rates, reaching 70-78% after intervention”)。随机头敲除只带来轻微下降(37.80%、54.60%、58.30%),证明效果是 PIH 头特异的。摘要称敲除把 PIH 至少降低 40%,Introduction 称可把视觉接地的计数”restores visually grounded counts by up to 54%”。
- 不损伤常规计数与通用能力:基线提示 exact match 上 LLaVA-OneVision 反而提升 +4.35 点(76.89 → 81.24),Qwen-VL(78.49 → 79.29)与 Janus-Pro(80.32 → 79.41)约 1 点波动;Table 2 显示 CalTech101 上 LLaVA-OV 100.0 → 100.0、Janus-Pro 99.0 → 99.0(Qwen-VL 100.0 → 96.0),MM-Vet 50.5→50.7 / 43.9→42.8 / 46.5→44.8,POPE 89.3→89.3 / 85.0→86.0 / 86.3→87.3,波动很小。
- 跨任务泛化到颜色(Table 4):同一组 PIH 头把 PIH 比例从 LLaVA-OV 99.04% → 4.79%、Janus-Pro 85.22% → 44.58%、Qwen-VL 79.73% → 20.28%,论文表述为 “reducing prompt-induced hallucinations by between 40% and 95%”,Introduction 则称 mitigates prompt-color copying by up to 94.25%。
- 头的位置与来源(Table 3):top-10 PIH 头集中在早/中层;”the top-10 PIH-heads, 5/10 occur in the 0th layer”(Qwen-VL),LLaVA-OneVision 为 7/10,Janus-Pro 有 3/10 落在第 0–1 层。Qwen-VL 与 LLaVA-OneVision 的 top-1、top-2 头完全重合,m = 10 时一半重合,说明 PIH 主要由共享的语言模型注意力头介导,而非视觉组件或跨模态对齐层。
- 注意力迁移(Figure 4):敲除后所有模型的图像注意力质量上升,幅度最大的是 LLaVA-OneVision(Δ = 0.121,最早层);Figure 4 标注为 LLaVA-OneVision layer 2、Qwen-VL layer 27(Δ=0.053)、Janus-Pro layer 22(Δ=0.037)。(注意:正文 6.2 节的表述是 “layer 2 in LLaVA-OneVision, 22 in Qwen-VL, and 27 in Janus-Pro”,与 Figure 4 caption 里 Qwen-VL/Janus-Pro 的层号正好互换,原文存在这处不一致。)
- 复制形态的模型差异:敲除后数字形式(digit)响应几乎被消除(总量 LLaVA-OV 7.87→0.50、Qwen-VL 28.49→4.53、Janus-Pro 43.95→2.81),单词形式响应大幅上升(92.13→99.50、71.51→95.47、56.05→97.19)。Janus-Pro 靠抑制 format copying(减少近 30%)纠正,P(N_digit|N_digit) 显著下降、P(N_word|N_digit) 上升,注意力仅小幅移向图像;Qwen-VL 反而更依赖提示格式,P(N_word|N_digit) 降 32.6%、P(N_digit|N_digit) 升 13.6%,format copying 从 40.21% 升到 53.95%;LLaVA-OneVision 同时抑制 format 与 soft copying(P(N_word|N_digit) 降约 18%),图像注意力增幅最大(+12%),是唯一基线计数还变好的模型。
- 对比方法:论文没有与其他去幻觉方法(如 VCD、OPERA 等)横向比较;其对照设置是”随机选取同层等量注意力头做敲除”,以及把敲除前后、无干预三档并列比较,另在文献综述中与情境/模态冲突相关工作(如 Zhang et al. 的单模态不确定性视角)做定位。
6. 论文结论
- 作者自述贡献:① 提出并刻画 PIH——VLM 把提示信息置于冲突性视觉证据之上的失败模式;② 找到一小组注意力头,敲除后能跨模型、跨任务大幅降低 PIH,且无需额外训练、在对齐提示上不造成性能退化;③ 刻画 PIH 头的功能,证明敲除会抑制提示复制并增加向视觉证据的纠偏。
- 核心论断:PIH 来自系统性的”提示复制”而非视觉感知失败;它主要定位于语言模型的早期层,提示中的数值信息在多模态整合之前就被注入并向前传播;Qwen-VL 与 LLaVA-OneVision 共享很多同样的头,说明其来源是共享语言骨干而非视觉专用组件;敲除会一致地把行为推向基于图像的纠正,并泛化到颜色预测,同时不损害通用性能。
- 局限与未来工作:Limitations 指出四点:① 研究只覆盖中等规模 VLM(约 7B 参数),识别出的具体 PIH 头及其敲除效果未必能直接推广到显著更大的模型;② 分析依赖基于注意力的方法,只能看到内部计算的一部分,注意力模式往往不可直接解释(作者也确认 PIH 头自身没有观察到的简单一致注意力模式);③ 敲除可能引发其他注意力头或层的次级行为变化,本文没有显式追踪;④ 三个模型虽然都呈现”减少精确复制、增加图像注意力”的共同趋势,但复制被抑制的具体方式彼此不同(Qwen-VL 减少 soft copying 却增加 format copying,Janus-Pro 相反地严格减少 format copying),确切原因留待未来工作,作者认为需要从架构差异、被选头的模式或训练数据等角度进一步研究。
[12] ACL2026 — Mitigating Hallucinations in Large Vision-Language Models without Performance Degradation
- 会议:ACL 2026(arXiv 录用说明:ACL 2026 (Oral))
- arXiv:2604.20366 — https://arxiv.org/abs/2604.20366
- 本地 PDF:
ACL2026-Mitigating Hallucinations in Large Vision-Language Models without Performance Degradation.pdf - 一句话定位:把幻觉方向从隐表示里正交剥离,只改被选中的少量权重,去幻觉不掉能力。
1. 中文摘要
论文针对 LVLM 幻觉问题指出:用人工标注的无幻觉数据微调虽最直接但算力昂贵,近年流行的”表示干预”方法虽然高效,却会损害通用生成能力,作者把原因归结为两点——(1) 抽取幻觉成分时不彻底(幻觉成分与通用语义成分高度耦合,把通用语义一起删掉),(2) 参数更新不具选择性(对目标层内所有权重都施加扰动,动辄修改上亿参数,导致过拟合并破坏原参数分布)。为此作者提出 MPD,一个双阶段、免训练、基于编辑的框架:第一阶段 Semantic-aware Component Disentanglement,用辅助 LLM 构造”诱发幻觉的提问 / 语义等价的忠实提问”对比样本对,把忠实表示的 SVD 行空间当作接地语义子空间,将幻觉表示投影到其正交补上,从而抽出纯幻觉成分;第二阶段 Interpretable Parameter Updates,用余弦相似度挑出与幻觉成分最对齐的 top-K 权重向量,把它们的行向量投影到幻觉成分的零空间,实现选择性参数编辑。实验显示 MPD 在降低幻觉的同时保持 97.4% 的通用生成能力,且推理阶段不引入额外开销。
2. 方法图
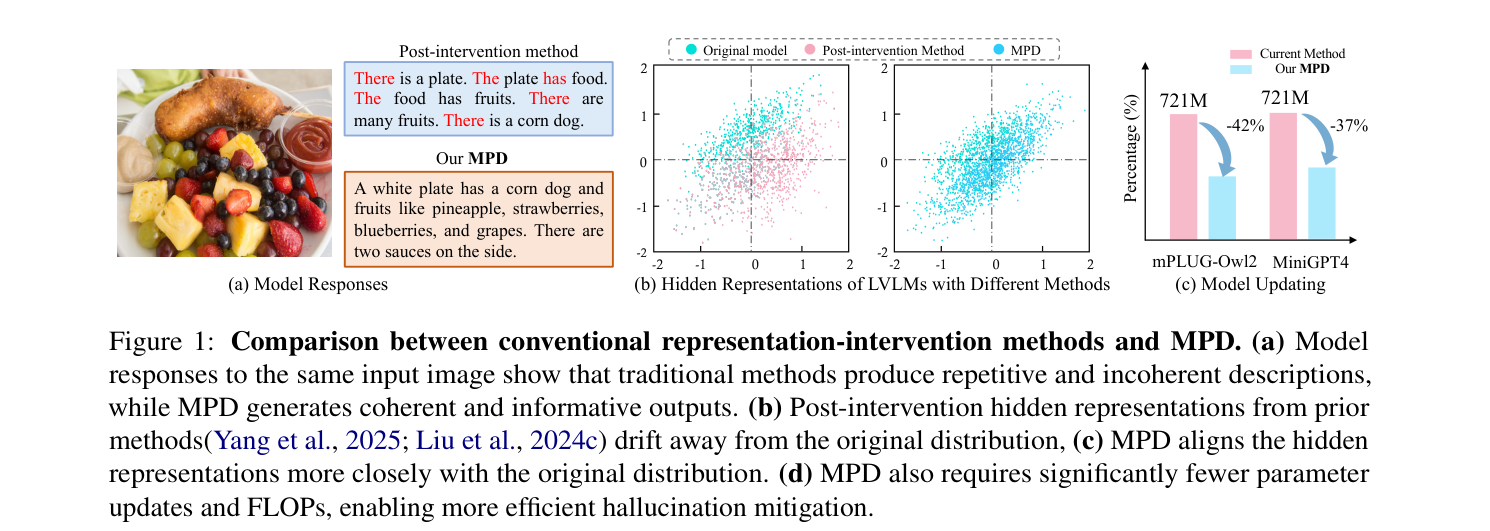
3. 研究动机
- 现有做法的缺陷:传统做法是靠人工标注清洗数据再微调,属 labor-intensive dataset curation,”inherently suffering from time-consuming bottlenecks”。而新近的表示干预方法虽然免去数据重建,却有一个关键问题:post-intervened LVLMs would lose general generative capabilities——论文在 Figure 1(a) 量化了这一点,干预后模型的语义不连贯与词汇重复率上升。
- 作者归因的两个缺陷:① 抽取幻觉成分时,这些成分 typically highly coupled with general semantic components,现有方法忽略共享成分,导致 unintended removal of general semantics(Figure 1(b) 左显示干预后表示分布明显偏离原模型);② 参数更新时 substantial perturbations are often applied to all weights within the targeted layers,一次性改动数亿参数(Figure 1(c) 给出 721M 的量级),造成过拟合并严重扰乱原参数分布。
- 本文的关键观察/假设:幻觉来自忠实与幻觉响应之间隐表示的细微偏差,因此只要能把”纯幻觉方向”从忠实语义子空间中正交剥离出来,并且只更新与该方向最对齐的少量权重,就能在不损伤通用生成能力的前提下压制幻觉。
- 定位差异:与 Nullu 的全局权重编辑不同,论文强调自己引入的是 fine-grained orthogonal subspace projection,由忠实/幻觉隐表示的对比对引导,且只编辑与幻觉特异方向最对齐的权重,而非修改全部参数。
4. 研究方法
- 总体流程(Algorithm 1 Pipeline of MPD):输入对比数据 D 与 LVLM 中的目标层集合 {ℓ};对每个目标层依次执行:算隐状态 → 抽正交幻觉分量 → 按相似度挑 top-K 权重向量 → 算投影矩阵 → 更新参数。MPD 是两阶段、免训练(editing-based)框架,作者称推理阶段不增加额外计算开销。
- 问题设定与对比数据:LVLM 由视觉编码器、文本编码器与作解码器的 LLM 组成。作者构造共享同一图像、仅文本不同的对比视觉—语言对:x_i⁻ 含幻觉内容,x_i⁺ 是与图像一致的忠实描述,数据集记为 D = {(x_i⁺, x_i⁻)} _ {i=1}^N(沿用 LURE 的配对数据构造方式);评测统一提示 “Please describe this image in detail.”。
- 阶段一 Semantic-aware Component Disentanglement(幻觉成分抽取):对每对样本取各层 ℓ ∈ {L_0,…,L} 的 token 嵌入并沿序列平均,堆成矩阵 X_ℓ⁺, X_ℓ⁻ ∈ R^{N×D};把幻觉表示建模为 X_ℓ⁻ = X_ℓ^real + X_ℓ^hall + ϵ⁻(接地语义 + 幻觉语义 + 残差噪声)。因为 X_ℓ⁺ 的行空间近似接地语义子空间,对其做 SVD:X_ℓ⁺ = U_ℓΣ_ℓV_ℓᵀ,取前 C 个左奇异向量得投影矩阵 P_ℓ = U_ℓU_ℓᵀ,于是幻觉成分为 X̃_ℓ = X_ℓ⁻ − P_ℓX_ℓ⁻ = (I − P_ℓ)X_ℓ⁻,与忠实子空间正交。
- 阶段二 Interpretable Parameter Updates(参数选择与编辑):对第 ℓ 层权重矩阵 W_ℓ ∈ R^{L×D},每行 w_ℓ^(i) 对应一个神经元,用与所有幻觉成分的平均余弦相似度打分 s_i = (1/N)Σ_j cos(w_ℓ^(i), x̃ _ {ℓ,j})/(‖w_ℓ^(i)‖·‖x̃ _ {ℓ,j}‖),取相似度最高的 top-K 权重(索引集 I_ℓ^hall)作为编辑目标。随后构造幻觉成分正交补(零空间)上的投影矩阵 Q̃_ℓ = I − X̃_ℓᵀ(X̃_ℓX̃_ℓᵀ)⁻¹X̃_ℓ,对每个被选中的权重做 w_ℓ^(i) ← Q̃_ℓ w_ℓ^(i),从而消除落在幻觉子空间内的方向,只改动极少量权重。
- 理论分析(Section 3.4, Proposition 1):把 X_ℓ^hall 拆成忠实子空间内的平行分量 X_ℓ^{hall,∥} = P_ℓX_ℓ^hall 与正交分量 X_ℓ^{hall,⊥} = (I−P_ℓ)X_ℓ^hall;证明正交投影残差 X̃_ℓ 在期望平方误差意义下比朴素差分估计 X̃_ℓ^diff = X_ℓ⁻ − X_ℓ⁺ 更接近真正的解耦幻觉信号:E‖X̃_ℓ − X_ℓ^{hall,⊥}‖_F² ≤ E‖X̃_ℓ^diff − X_ℓ^{hall,⊥}‖_F²(因为差分会把共享语义 X_ℓ^{hall,∥} 纠缠进来)。
5. 实验结果
- 基座模型:MiniGPT-4 V2、LLaVA-1.5-7B、mPLUG-Owl2 三个代表性 LVLM。
- 数据集与基准:CHAIR(在 MSCOCO 上,含句级 CHAIR_S 与实例级 CHAIR_I,另报 BLEU 反映描述质量,max token 64)、POPE(MSCOCO 上,random / popular / adversarial 三种负采样策略,报 Accuracy/Precision/Recall/F1)、MME(14 个任务,聚焦 Existence、Count、Position、Color 四个与幻觉相关的子集)、LLaVA-Bench(GPT-4V 评测 Accuracy 与 Detailedness)、HallusionBench(fACC/qACC/easyA/hardA/aACC);附录另报 OPOPE、AMBER、MMHalBench 与 GLM-4V、Qwen-VL 等更多基座的结果。对比方法:DoLa、OPERA、VCD、LURE、HALC、Nullu。
- 关键结果:
- CHAIR(Table 1,越低越好):MPD 在三个模型上取得最低句级幻觉——CHAIR_S 12.80(LLaVA-1.5-7B)、19.40(MiniGPT-4)、14.00(mPLUG-Owl2),优于最强的 Nullu(15.20、21.40、15.60);实例级 CHAIR_I 为 4.20 / 7.50 / 4.99(Nullu 为 5.30 / 8.99 / 5.77)。BLEU 保持有竞争力,mPLUG-Owl2 上最高 16.06。
- POPE(Table 2):三种采样策略下 MPD 的 F1 均最高。random 设置下 F1 达 88.20(LLaVA-1.5-7B,原模型 86.03、Nullu 87.43)、85.76(mPLUG-Owl2)、71.81(MiniGPT-4);adversarial 设置 mPLUG-Owl2 为 78.72,优于 original 76.58 与 Nullu 77.15;Accuracy 上 LLaVA-1.5-7B 从 87.98 升到 89.31。作者据此强调”复杂视觉场景不阻碍 MPD”。
- HallusionBench(Table 3):LLaVA-1.5-7B 的 fACC 17.9 → 19.9、qACC 8.1 → 9.0、aACC 41.5 → 44.3;MiniGPT-4 的 fACC 10.1 → 11.5、qACC 8.7 → 10.2,说明方法不局限于物体存在性幻觉。(注意:Table 3 中 mPLUG-Owl2 的 Nullu 行与 MPD 行数值(10.7/9.5/32.3/28.1/36.8 与 11.5/10.2/33.1/28.7/37.3)与 MiniGPT-4 的两行完全相同,且 mPLUG-Owl2 的 Original 行(19.9/13.8/44.8/39.1/47.3)明显高于其被”改进”后的行,疑为原文表格排版错误,引用该表时需谨慎。)
- 通用生成能力(LLaVA-Bench,Table 4,满分 10):LLaVA-1.5-7B Accuracy 5.59 → 6.39、Detailedness 4.72 → 5.52;MiniGPT-4 4.05 → 5.53 / 3.95 → 4.67;mPLUG-Owl2 5.76 → 6.13 / 4.22 → 4.62,即编辑后两项指标都上升而非下降。
- MME(Figure 2):MPD 在 Existence 与 Count 两个子集上最好,在 Position 与 Color 上保持竞争力(论文只给柱状图,未在正文列出具体分数)。
- 隐表示对齐(Figure 3):取 1,000 条忠实提示的 token 级表示做 PCA,MPD 编辑后的分布与原模型紧密对齐,而 Nullu 引入明显漂移。
- 参数扰动量(Figure 1(c)):MPD 相对基线把参数更新量在 mPLUG-Owl2 上减少 42%、在 MiniGPT4 上减少 37%(原始量级 721M)。
- 消融:编辑层范围(Table 5,LLaVA-1.5-7B):编辑 16–32 层最好(CHAIR_S 12.80、CHAIR_I 4.20、BLEU 15.31);范围越窄越浅越差——22–32 为 14.03/5.95/14.80,30–32 退化到 20.10/7.75/14.70 且 BLEU 无增益,说明覆盖不足会残留幻觉成分。
- 摘要口径:MPD 在 LLaVA-Bench 与 MME 上把幻觉降低 23.4%,同时保留 97.4% 的通用生成能力,且无额外计算开销(论文正文未给出 23.4% 的具体分解口径)。
- 对比方法:DoLa、OPERA、VCD、LURE、HALC、Nullu;另有 RoME/MEND/InstructEdit 等模型编辑工作与 OPERA、VCD 等解码/交叉注意力方法在 Related Work 中被定位对比。
6. 论文结论
- 作者自述贡献:提出 MPD——一个在不损害生成能力的前提下缓解 LVLM 幻觉的优化框架;它通过对比表示上的正交投影解耦幻觉成分,并用余弦相似度选择性更新与这些成分最相关的参数,从而避免大规模扰动;跨多个 LVLM 与基准的实验显示其在抑制幻觉的同时保留 97.4% 的生成能力,且推理阶段不增加成本,作者称这填补了幻觉缓解中效率与效果之间的鸿沟。
- 机制结论:阶段一的正交投影避免了幻觉成分与通用语义的相互污染(隐表示分布更贴合原模型);阶段二的选择性编辑把参数扰动大幅削减(mPLUG-Owl2 −42%、MiniGPT4 −37%),这是”不掉能力”的直接来源。
- 局限与未来工作:Limitations 有三点:① MPD 只在现有基准上改善对齐,不解决来自更广泛数据偏置或提示局限的幻觉;② 自动基准可能无法充分刻画长文本连贯性与风格多样性;③ 在高度歧义的视觉输入下的鲁棒性仍有待评估。
和Nullu的不同:
不完全是。两者本来都有“提取幻觉子空间 → 投影编辑”两步。MPD 改了第一步的提取公式,并在第二步增加了权重筛选。
下面统一符号,并区分论文原式与几何解释。
设:
符号 含义 $X_T,X_H\in\mathbb R^{n\times d}$ 忠实/幻觉表征,行对应样本 $W\in\mathbb R^{d\times m}$ 待编辑矩阵,列向量 $w_i$ 对应一个权重向量 $r$ Nullu 保留的幻觉方向数 $c,K$ MPD 保留的忠实主成分数、选中权重数 1.Nullu 的公式
先计算真假表征差:
$$
\Delta=X_H-X_T.
$$做 SVD,取前 $r$ 个右奇异向量:
$$
\Delta=U_\Delta\Sigma_\Delta V_\Delta^\top,
\qquad
B_\Delta=V_\Delta[:,1:r].
$$得到幻觉子空间投影矩阵:
$$
P_\Delta=B_\Delta B_\Delta^\top\in\mathbb R^{d\times d}.
$$对目标矩阵整体编辑:
$$
\boxed{W_{\text{Nullu}}=(I_d-P_\Delta)W.}
$$即所有列向量都执行 $w_i’=w_i-P_\Delta w_i$。
2.MPD 的公式
先对忠实表征做 SVD:
$$
X_T=U_T\Sigma_TV_T^\top.
$$按原文使用左奇异向量的写法,取:
$$
A_T=U_T[:,1:c]\in\mathbb R^{n\times c},
$$再提取残差:
$$
\boxed{
R=(I_n-A_TA_T^\top)X_H
\in\mathbb R^{n\times d}.
}
$$接着,根据各权重与残差向量的平均余弦相似度排名,选出集合 $\mathcal S_K$。
用 $R$ 的行空间构造投影:
$$
P_R=R^\top(RR^\top)^\dagger R.
$$这里用伪逆 ${}^\dagger$ 覆盖秩亏情况;可逆时就是原文的普通逆。对选中权重编辑:
$$
\boxed{
w_i’=
\begin{cases}
(I_d-P_R)w_i,&i\in\mathcal S_K,\
w_i,&i\notin\mathcal S_K.
\end{cases}
}
$$如果用对角掩码 $M_K\in\mathbb R^{m\times m}$ 标记选中列,整体可写成:
$$
\boxed{W_{\text{MPD}}=W-P_RWM_K.}
$$并排来看:
$$
\begin{aligned}
\text{Nullu:}\quad
&W’=W-\underbrace{P_\Delta} _ {\text{由真假差估计}}W,\\
\text{MPD:}\quad
&W’=W-\underbrace{P_R} _ {\text{由忠实参考残差估计}}
W\underbrace{M_K} _ {\text{只编辑部分权重}}.
\end{aligned}
$$所以,“增加权重筛选”只是一个区别;$P_\Delta$ 换成 $P_R$ 是另一个区别。
还有一个必须纠正的细节:MPD 原文的 $U_TU_T^\top$ 在样本维上投影;若要在 $d$ 维特征空间中排除忠实方向,应改用右奇异向量并右乘:
$$
R_{\text{feature}}
=X_H\left(I_d-V_{T,c}V_{T,c}^\top\right).
$$这与原文使用 $U_T$ 的公式并不等价。 原文还将相应单位矩阵写成了 $d\times d$,存在维度不一致。
批注:疑似论文有问题
[13] ACL2026 — Spotlight and Shadow: Attention-Guided Dual-Anchor Introspective Decoding for MLLM Hallucination Mitigation
- 会议:ACL 2026(arXiv 录用说明:Accepted for Findings of ACL 2026)
- arXiv:2604.10071 — https://arxiv.org/abs/2604.10071
- 本地 PDF:
ACL2026-Spotlight and Shadow Attention-Guided Dual-Anchor Introspective Decoding for MLLM Hallucination Mitigation.pdf - 一句话定位:把对比解码从”外部扰动”改成”内部层差”,用视觉注意力自动选一正一负两层来纠偏。
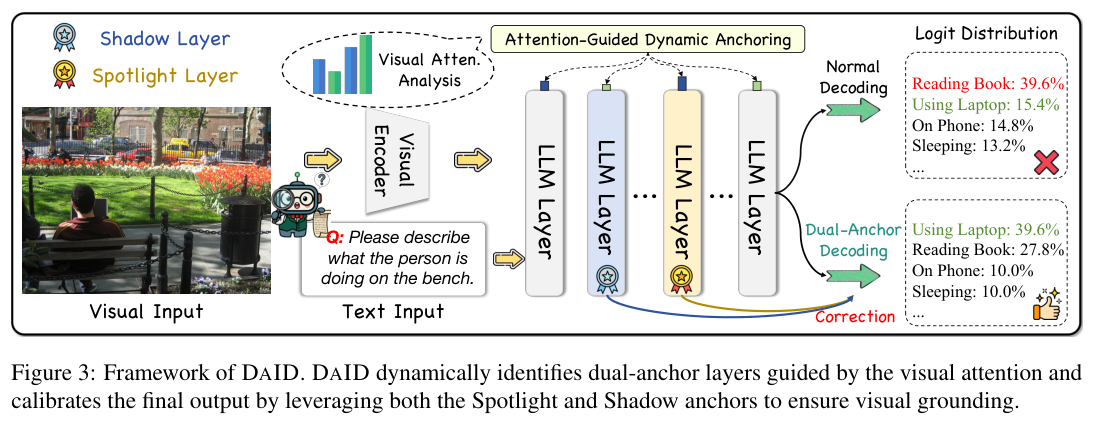
1. 中文摘要
本文面向 MLLM 的幻觉问题,提出免训练的 Dual-Anchor Introspective Decoding(DAID)。作者先做逐层诊断,发现两个稳定现象:浅层因视觉语义尚未与 LLM 潜空间对齐而”视觉失认”,语言先验主导、幻觉率最高(LLaVA-1.5 峰值 60.87%、LLaVA-NeXT 44.44%);中间层视觉辨识准确率最高(LLaVA-1.5 第 25 层、LLaVA-NeXT 第 17 层),但深层又因”文本惯性”回落。基于此,DAID 用 Visual Attention Score(VAS,各头对视觉 token 的注意力质量均值)在每个解码步动态定位两个锚点:VAS 最大的中间层作为 Spotlight(正锚)重注入真实视觉信号,Spotlight 之前 VAS 最小的浅层作为 Shadow(负锚)扣减语言惯性;最终 logits 由终点层分布经 [L_final + α·L_spot]·(1+β) − β·L_shad 校准,并用自适应合理性约束把调整限制在终点层高概率候选集 V′ 内以保证通顺。整个流程只需一次前向。多基准、多模型实验显示 DAID 在抑制幻觉的同时还提升了通用多模态推理。
2. 方法图
3. 研究动机
- 现有做法的缺陷:免训练对比解码(CD)被两类问题卡住。其一,VCD/ICD 每个解码步都要为负样本额外做一次前向,”increases inference latency by 1.83× compared to standard decoding on NVIDIA V100”;其二,负分布靠启发式外部扰动(如视觉掩码)合成,会引入随机噪声——Figure 1 里标准解码本来给出 “yellow” 系颜色,VCD 却因扰动噪声把答案偏向 “red” 词表。
- 本文的关键观察/假设:MLLM 内部本身就存在可利用的对比源。逐层探测(Figure 2,POPE 上做)表明:浅层幻觉率最高、视觉注意力最低(Layer 6 附近为局部极小),中间层视觉辨识准确率峰值与视觉注意力峰值同步(LLaVA-1.5 都在第 25 层),深层则出现”seeing-then-forgetting”,准确率分别掉 4.45%(LLaVA-1.5)与 11.12%(LLaVA-NeXT)。作者由此提出三条 takeaway:浅层=天然 Shadow 负锚,中层=天然 Spotlight 正锚,视觉注意力是无训练、可靠的内部状态代理指标。
- 任务背景/指标缺陷:作者把幻觉放到医疗影像、金融分析这类高风险场景讲其危害(模型可能凭空”看到”不存在的肿瘤),因此强调方法必须免训练、低延迟、可直接插到现有解码流程里。
4. 研究方法
- 总体流程:DAID 是免训练解码框架,在第 t 步先生成候选 token 的终点层分布,再按视觉注意力选出 Spotlight / Shadow 两层,用两层 logits 对终点层分布做双重校准,最后经合理性约束输出。只走一次前向(single forward pass)。
- 模块 A:Visual Attention Score(VAS):
VAS_t(l) = (1/H) Σ_h Σ _ {k∈V} A^{l,h} _ {t,k},即在第 l 层、第 t 个解码步对所有 head 累加落在视觉 token 集合 V 上的注意力质量。VAS 高说明该层真的在做视觉 grounding,低则说明由语言先验主导。 - 模块 B:Attention-Guided Dynamic Anchoring:Spotlight 层取 VAS 最大层
L_spot = argmax_l VAS_t(l);Shadow 层在 Spotlight 之前的层中取 VAS 最小层L_shad = argmin _ {l < L_spot} VAS_t(l)。加L_shad < L_spot的拓扑约束是为了保证负锚落在”视觉失认”的纯语言噪声区;附录 Figure 9 显示,若不限制(w/o Constraints)性能明显下降,加上该约束后 POPE 准确率由 83.14% 升到 85.08%(+1.94%)、F1 由 83.62% 升到 85.92%(+2.30%)。锚点是逐 token 动态选的,单条样本 20 步内平均负锚约 2.44.3 层、正锚约 23.324.2 层。 - 模块 C:Dual-Anchor Introspective Decoding:
L_DAID = [L_Lfinal + α·L_Lspot]·(1+β) − β·L_Lshad。前半项 Visual Perception Reinforcement 把中层峰值视觉信号重新注入,后半项 Language Prior Suppression 惩罚纯语言相关性驱动的 token。超参 α=0.8(视觉增强强度)、β=0.2(语言先验压制强度)。 - 模块 D:Adaptive Plausibility Constraint:只对满足
p_θ(y_t|L_final) ≥ γ·max_w p_θ(w|L_final)的候选集 V′ 施加双锚调整,其余置零;POPE 这类判别式任务用 γ=0.9,开放生成任务(CHAIR)用 γ=0.1。作者解释这样能避免把中层”视觉相关但语法不合适”的 token 直接塞进输出。
5. 实验结果
- 基座模型:LLaVA-1.5、LLaVA-NeXT、Qwen2-VL、MiniGPT-4、InstructBLIP,全部在 7B 参数规模评测;通用能力部分额外报告 LLaVA-1.5-7B/13B。
- 数据集与基准:幻觉类 POPE(Acc./F1)、CHAIR(CHAIR_S / CHAIR_I)、MME(Existence、Count、Position、Color 及 Total);通用类 GQA、VQAv2、MMB、SeedI(SEED-Bench)、VizWiz。
- 关键结果:
- POPE(LLaVA-1.5-7B):DAID 85.08% Acc / 85.92 F1,优于最强基线 EAZY 的 84.97 / 85.78,相对 Greedy 的 81.38 / 82.20 提升约 3.7 / 3.72 个百分点;LLaVA-NeXT 上 85.32 Acc / 85.76 F1(Greedy 83.78 / 82.24)。
- CHAIR(LLaVA-1.5-7B):CHAIR_S 降至 35.9%、CHAIR_I 降至 11.3%(Greedy 为 49.6 / 14.4,EAZY 为 38.8 / 11.4);LLaVA-NeXT 上 CHAIR_S 24.2%(Greedy 32.8)。
- MME Total:LLaVA-1.5 从 Greedy 559.48 提升到 633.68(Position 113.39→154.46、Color 149.92→162.38),LLaVA-NeXT 从 580.92 提升到 644.40。
- 消融(Table 2,LLaVA-1.5):去掉正锚 w/o PA → Acc 85.08→84.57;去掉负锚 w/o NA → CHAIR_S 35.9→48.9。两锚缺一不可。
- 超参:α 在 0.8 处、β 在 0.2 处同时达到峰值(倒 U 形);α=1.0 时 F1 反降 0.71%/1.66%,β=0.4 时 F1 降 1.51%/1.89%。
- 效率(附录 Figure 10,RTX 5070 Ti):LLaVA-1.5-7B 上标准解码 65.4 ms/token、DAID 88.0 ms/token(1.346×)、VCD 121.0 ms/token(1.850×);LLaVA-NeXT-7B 上 57.5 / 75.5 / 103.9 ms,DAID 比 VCD 快 37.6%。
- 对比方法:DoLa、VCD、OPERA、SID、EAZY,另含 Greedy 与 Beam Search 两个解码基线。
6. 论文结论
- 作者自述贡献:① 给出细粒度的逐层解码动态诊断,揭示浅层幻觉严重、中层视觉感知最强的规律;② 提出 DAID,在单次前向内同时放大真实视觉信号并压制语言先验;③ 在多个基准上同时改善幻觉指标与通用多模态推理能力。
- 局限与未来工作:受算力限制只评测了 7B 规模模型,超过 70B 的模型上层动态与可扩展性尚未验证;当前只做图文任务,视频/音频等模态未探索,作者认为把双锚框架扩展到序列化多模态数据是有前景的方向。伦理部分也提示该方法不能消除所有幻觉,高风险场景仍需谨慎使用。
[14] ACL2026 — Through the Magnifying Glass: Adaptive Perception Magnification for Hallucination-Free VLM Decoding
- 会议:ACL 2026(arXiv 录用说明:ACL 2026 Main Conference)
- arXiv:2503.10183 — https://arxiv.org/abs/2503.10183
- 本地 PDF:
ACL2026-Through the Magnifying Glass Adaptive Perception Magnification for Hallucination-Free VLM Decoding.pdf - 一句话定位:解码时按注意力热图把关键区域”放大”、把无关区域压扁,从输入侧提升有效分辨率。
1. 中文摘要
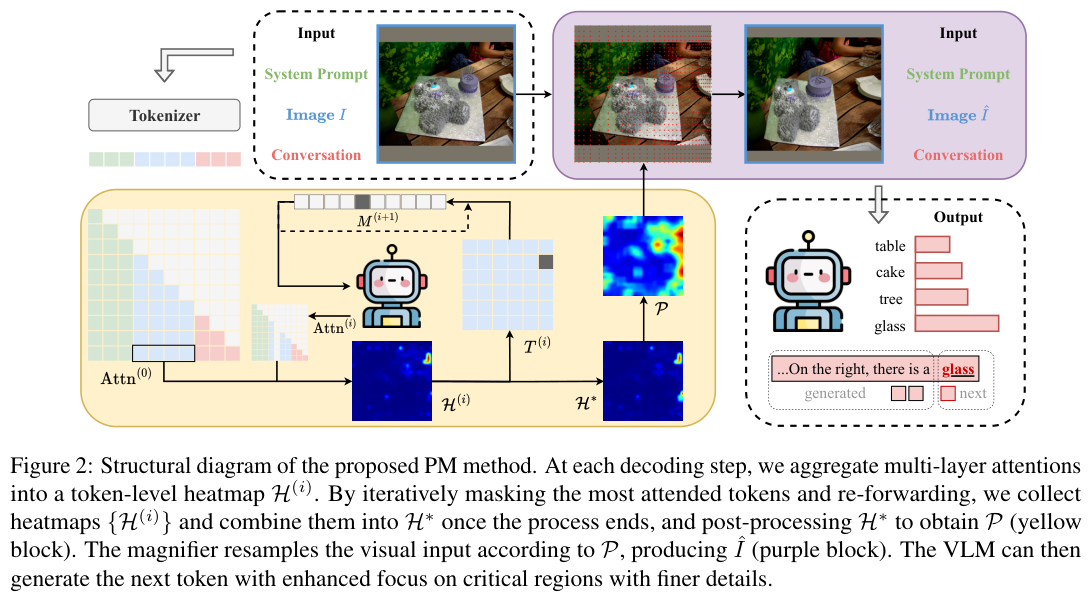
本文针对 VLM 幻觉提出 Perception Magnifier(PM),一个免微调的视觉解码方法。作者指出,已有免训练方案要么对比式地削减语言偏置、要么在解码时放大视觉 embedding 权重,但它们都难以捕捉细粒度视觉细节——注意力可能已经指对了区域,却因分辨率不足而认错。PM 的思路是在每个自回归解码步重新构造视觉输入:先聚合中后层(l ≥ L,默认 L=12)在最后一个生成 token 上的自注意力,并对所有 head 取 max,得到 token 级热图 H;再用 2-means 聚类挑出注意力最高的 token 群,从下一轮前向中把它们 mask 掉并重算,直到新热图的总注意力低于阈值 β 或达到最大迭代数,把所有轮热图累加归一化得到 H*;随后经方差增强+sigmoid+smoothing+bilinear 上采样得到像素级感知图 P;最后把 P 当作质量函数,沿横纵方向做逆变换采样(inverse transform sampling)得到放大图 Î,替换原图重新前向,直接对新的 logits 采样下一个 token。由于是”放大关键区域+压缩次要区域”而非裁剪,空间结构得以保留,幻觉率下降的同时通用生成与推理能力不受损。
2. 方法图
3. 研究动机
- 现有做法的缺陷:免训练解码方法分两派都有短板。对比解码类(VCD、ICD、VDD、M3ID 等)靠惩罚”视觉不一致的输出”来纠偏,但当两个 logits 对应的视觉细节本身都模糊时就会失效,且过度压制偏置信号会伤害连贯性与推理;另一派用 mask/bbox 提示关键区域,或像 ViCrop 那样裁剪关键区域作为辅助输入,”disrupts spatial structure and may impair tasks requiring holistic understanding, and doubles visual tokens’ compute”。
- 本文的关键观察/假设:① VLM 推理时对大量视觉 token 只分配边际注意力;② patch 化架构对尺度敏感的小细节天然吃力;③ 深层视觉模型会把细粒度特征压缩进少数 token(information registers),导致同类物体在多处出现时只看得到一处。由此得到一个反直觉结论:注意力准 ≠ 认得对,局部证据在有限分辨率下会被覆盖,所以应该”放大”而不是”换权重”或”裁剪”。
- 方法学依据:作者实测发现中间层注意力比末层更能准确定位相关物体,因此聚合 l ≥ L(L=12)的中后层注意力而非最后一层。
4. 研究方法
- 总体流程:PM 是逐解码步执行的插件式解码流程。每一步做三件事:由注意力构造感知图 P → 按 P 重采样得到放大图 Î = T(I, P) → 用 Î 重新前向得到 logits 并采样下一 token;magnified logits 直接 softmax 采样,不再与原 logits 做比例或对比融合。
- 模块 A:Perception Map Construction:
H = Σ _ {l=L}^{N_l} max_h Attn _ {l,h},即中后层注意力对 head 取 max 后跨层求和,得到 H×W 的 token 级热图,反映 VLM 的中间推理显著性。 - 模块 B:Post-Processing to Pixel Space:先把 H 归一化到 [0,1] 得 H′,再
H_proc = sigmoid(α·(H′−μ)/σ)放大方差,然后用 kernel size k 的均匀平滑滤波 + bilinear 上采样得到像素级 P。这一步专门提升低幅注意力值,保证”小但重要”的区域不被忽略。 - 模块 C:Iterative Refinement(IR,Algorithm 1):为覆盖那些因 information register 被漏掉的同类物体区域,迭代执行”前向→算热图 H(i)→2-means 聚类取高质心 token 集 T(i)→用 M(i+1) = M(i) ∩ ¬T(i) 在 token 级把它们屏蔽→再前向”,直到
Σ H(i) < β或达到 T_max;最后把各轮热图累加并除以计数 C 归一化得 H*。作者强调在 token 级而非图像级屏蔽,避免重新 tokenize 的开销。 - 模块 D:Attention-Based Magnification:把 P 当质量函数,先求横/纵两个方向的边缘累计分布
F_x(n)=Σ _ {j≤n} max_i P _ {i,j}、F_y(n)=Σ _ {i≤n} max_j P _ {i,j},再用逆变换采样重映射坐标Î = Interp(I, F_x^{-1}(i), F_y^{-1}(j))(双线性插值)。高感知值区域被拉伸放大、低值区域被压缩而非丢弃,因此保留整体结构。 - 超参:骨干 LLaVA-1.5-7B,注意力聚合起点 L=12,方差增强系数 α=10,平滑核 k=3,IR 停止阈值 β=0.3(Shikra 上 β=1.5),IR 最多 8 轮。
5. 实验结果
- 基座模型:LLaVA-1.5 7B 为主实验骨干;泛化性实验另用 Shikra-7B(referential dialogue VLM)。
- 数据集与基准:MME(Perception 与 Cognition 两个子集)、POPE(9 个 split,报 AVG)、MMHal-Bench(96 条开放式问答,GPT-4 评测幻觉率与均分)、LLaVA-Bench 的 COCO 与 In-the-Wild 两个 split(GPT-4o 辅助评测 Ref / Acc / Det)。
- 关键结果:
- MME Perception 总分:PM 683.33,对比 Greedy 630.00、IBD 653.33、PAI 648.33、M3ID 640.00、ViCrop-R 633.33;其中 Count 175.00(Greedy 143.33)、Position 138.33(Greedy 128.33)。
- MME Cognition:PM 355.36,Greedy 357.86——作者强调只有 PM 没有出现认知能力下滑,而 OPERA(310.36)、VCD(327.50)、SID(327.86)等普遍下降。
- POPE 平均准确率:PM 86.70%,高于 Greedy 84.59%、VDD 86.32%、API-C 86.41%、M3ID 86.24%(AOKVQA 86.94 / GQA 85.46 / COCO 87.68)。
- MMHal-Bench(Figure 3):PM 在全部对比方法中取得最低幻觉率,整体得分与最强基线相当;PM 去掉 IR 后两项指标都更差,说明迭代细化有效。
- LLaVA-Bench(GPT-4o 评测):PM 在 COCO 上 Ref 85.76 / Acc 97.74 / Det 95.80;In-the-Wild 上 Ref 62.46 / Acc 77.21 / Det 84.50,Ref 项优于 IBD(61.59/61.88 量级)。论文自述 COCO 的 Det 与 In-the-Wild 的 Acc 略低于个别方法,差距主要来自回答冗长度与”更依赖语言先验/世界知识”的题目。
- 消融(Table 3,MME Perception Total):Greedy 630.00 → w/o IR & MLA 640.00 → w/o MLA 645.00 → w/o IR 665.00 → 完整 PM 683.33,即多层聚合(MLA)与迭代细化(IR)各自都有贡献。
- 放大方式消融(Table 4b):同为感知图引导,Magnification 683.33 明显优于 ViCrop 646.67、DualView 650.00、Masking 648.33、Bounding Box 640.00、Blurring 630.00。
- 泛化到 Shikra-7B:MME Perception Total 613.33(Greedy 576.67,最好的基线 API-C 591.67)、POPE AVG 82.36%(Greedy 82.19%);作者解释 Shikra 视觉 token 更少、分辨率更低,固增益较小。
- 效率(附录 Figure 6):PM w/o IR 约为 greedy 的 3.5×,带 IR 约 12×;对比方法 IBD/VDD 约 2–3×,API/ViCrop 约 8–20×。全部实验约 24 GPU 小时,单卡 RTX 3090。
- 对比方法:greedy decoding、beam search(beam size 4)、OPERA、VCD、ICD、SID、VDD、M3ID、PAI、IBD、API(-C / -L)、ViCrop(-R / -G)。
6. 论文结论
- 作者自述贡献:① 提出 PM,在解码过程中自适应放大视觉兴趣区域以缓解幻觉;② 提出一种新的注意力 grounding 方法,跨层迭代聚合注意力生成感知图来引导放大;③ 通过大量实验证明 PM 在抑制幻觉的同时保持推理能力。
- 局限与未来工作:区域放大会扭曲局部形状,在需要几何保真的任务(如 CLEVR 式大小/形状判断)上可能反致幻觉;每个解码步都要对修改后的图像重做特征提取,无法使用 KV caching,PM w/o IR 约 3.5×、带 IR 约 12× 慢于 greedy;对视觉 token 与图像块映射复杂的模型(带 token sampler 或 cross-attention 抽取器)还需要额外的注意力对齐机制。未来方向包括更结构保真的感知图/后处理、在几何保真重要的任务上只在部分解码步放大、以及 speculative / deferred refinement 以降低重采样频率。
[15] ACL2026 — Vocabulary Hijacking in LVLMs: Unveiling Critical Attention Heads by Excluding Inert Tokens to Mitigate Hallucination
- 会议:ACL 2026(arXiv 录用说明:Accepted by ACL 2026 Main)
- arXiv:2605.10622 — https://arxiv.org/abs/2605.10622
- 本地 PDF:
ACL2026-Vocabulary Hijacking in LVLMs Unveiling Critical Attention Heads by Excluding Inert Tokens to Mitigate Hallucination.pdf - 一句话定位:用 logit lens 发现”无效视觉 token 劫持注意力”,据此挑出真正做视觉落地的注意力头并增强它们。
1. 中文摘要
本文用 logit lens 剖析 LVLM 的注意力机制,发现一个被作者命名为 Vocabulary Hijacking 的异常:少数与当前生成无关的背景视觉 token(称为 Inert Tokens,如 LLaVA-1.5 中的 #595、#157)会长期吸走大量注意力,而把它们在中间层的隐状态投影到词表空间后,逐层解码出的词几乎锁定在”kwiet”这类无意义词上,作者称这种僵化的语义塌缩为 Hijacking Anchors。基于这种语义刚性,作者提出 Hijacking Anchor-Based Identification(HABI):先用 Dominance×Frequency×Attention 三个维度合成 Hijacking Score,用 IQR 阈值(τs = Q3 + 1.5·IQR)在词表层面筛出 Hijacking Anchors 集合,再用 Hijacking Ratio(Trace 中命中该集合的比例)配合 Otsu 自动阈值定位 Inert Tokens。为了量化其危害,作者进一步提出 Hijacked Attention Ratio(HAR)与 Non-Hijacked Visual Attention Ratio(NHAR)两个指标,发现幻觉 token 的 HAR 明显更高、而真实物体 token 与高 NHAR 头强相关。最后提出免训练干预 HAVAE:按 NHAR 选出 top-K 个”未被劫持”的注意力头,用同层各头的平均注意力幅度对它们的视觉注意力做加法增强,从而在不增加计算开销的前提下压制幻觉并保持通用能力。
2. 方法图
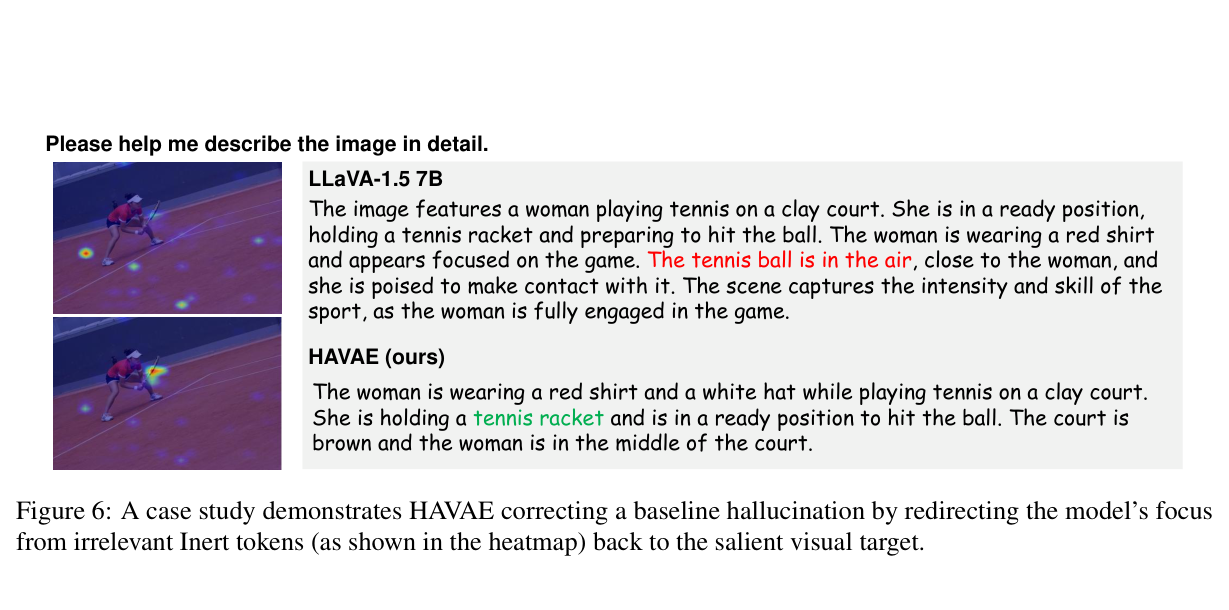
说明:该论文(含附录 28 页)没有给出”模块框+箭头”式的框架/流程图,全部 Figure 均为现象可视化、指标分布、超参消融与案例。经逐张 read_image 比对(Figure 1/2 是注意力热图与 logit lens 的纯观测证据、Figure 3/4 是分布直方图、Figure 5 是超参热图),Figure 6 是全文最能代表方法的一张:左栏同一张输入图上并列”基线注意力 vs HAVAE 注意力”两张热图,右栏上下对照 LLaVA-1.5 7B 的幻觉回答(红色 the tennis ball is in the air)与 HAVAE(ours)的修正回答(绿色 holding a tennis racket),直接体现 HAVAE 把注意力从 Inert tokens 重定向到显著视觉目标这一核心机制,故选它作为方法图。
3. 研究动机
- 现有做法的缺陷:领域内已有共识”对视觉 token 注意力不足是幻觉主因”,于是出现大量 attention-based 干预,但作者指出一个根本问题始终没解决——“Which specific attention heads are actually critical?”;缺少有原则的识别机制,这些方法只能依赖启发式(heuristic)来选头。
- 本文的关键观察/假设:把每个视觉 token 各层隐状态投到词表空间得到它的 Trace。正常 token 的 Trace 会从无意义逐渐演化到”phone”这类与图对齐的概念(Token #395 在第 20 层之后出现);但被高关注的背景 token(#595、#157)的 Trace 长期被”kwiet”这类固定无意义词垄断,完全不演化——这就是 Vocabulary Hijacking / Inert Tokens / Hijacking Anchors 三位一体的现象。
- 现象与幻觉的因果线索:作者在 top-300 视觉注意力最强的头上定义 HAR,发现幻觉 token 的 HAR 系统性偏高,说明关键视觉头一旦被”劫持”就失去 grounding;而真实物体 token 与高 NHAR(分配给有效视觉内容的注意力预算)强相关,于是 NHAR 被用作挑头准则。
- 与 Visual Attention Sink 的区别:作者认为 VAS 只是描述”持续吸引注意力+落在背景+贡献可忽略”,而 Vocabulary Hijacking 额外给出了词表层面的刚性语义证据,判别更精确(附录用 Jaccard 距离、背景分布、zero-ablation 等做了三方对比)。
4. 研究方法
- 总体流程:先在 COCO 2014 验证集抽 500 张图、用 “Please help me describe the image in detail” 做贪心解码,统计出词表级 Hijacking Anchors 与 token 级 Inert Tokens;再由此计算每个头的 NHAR 并选 top-K 头作为 H_target;推理时对这些头做注意力增强。整个干预免训练、零额外计算开销。
- 模块 A(Trace & Hijacking Score):
S_hijack(v_i) = D(v_i)·F(v_i)·A(v_i),D 是 Anchor 在 Trace 中的占比(Dominance),F 是该 Anchor 在所有 Anchor 中的对数平滑频率,A 是该 token 前 10 个解码步收到注意力的对数平滑均值。 - 模块 B(Hijacking Anchors 与 HABI):对词表词 w 求其名下所有 token 的 Mean Hijacking Score
S̄(w),取长尾分布的离群阈值τ_s = Q3 + 1.5·IQR得到 A_hijack;再定义r_hijack(v_i) = (1/|T_vi|)Σ_t I(t ∈ A_hijack),在高关注 token(top 5% 注意力质量)上该比例呈明显双峰,用 Otsu 法自动求阈值 τ_r,I_inert = {v_i | r_hijack(v_i) > τ_r}。 - 模块 C(HAR / NHAR 指标):
HAR(ℓ,h) = Σ _ {v∈I_inert} A / Σ _ {v∈I_v} A(诊断被劫持的程度);NHAR(ℓ,h)(y_k) = Σ _ {v∈I_v \ I_inert} A _ {k,v}(直接度量分配给有效视觉内容的全局限度预算);选头时用真实物体 token 集 O_real 上的平均值NHAR(ℓ,h) = (1/|O_real|)Σ NHAR(y_k),取 top-K 个入 H_target。 - 模块 D(Stage 2: Collective Attention Reinforcement):对 H_target 中的头,把视觉 token 的注意力改成
A ← A + α·(1/H)Σ _ {h'} A^{(ℓ,h')},即用同层所有头的平均注意力幅度做温和加法增强(不引入外部噪声)。默认 α=0.1;长上下文任务(Captioning、POPE-Chat)提高到 0.6(LLaVA-1.5-7B、MiniGPT-4、Qwen2-VL)或 0.7(LLaVA-1.5-13B、Shikra)。K=450(Qwen2-VL 为 300)。 - 关键设计取舍:作者实测”直接惩罚 Inert Token 注意力”(引入惩罚系数 β)反而更差(β=0.1 时 CHAIR_S 从 18.2 升到 20.2),因此选择”正向增强未被劫持的头”而不是”负向压制被劫持的 token”。
5. 实验结果
- 基座模型:LLaVA-1.5-7B、LLaVA-1.5-13B、Shikra-7B、MiniGPT-4-7B、Qwen2-VL-7B。
- 数据集与基准:CHAIR(CHAIR_S ↓ / CHAIR_I ↓)、POPE 及其对话版本 POPE-Chat(F1/Acc)、AMBER(生成式 CHAIR / Cover / Hal / Cog 与判别式 Acc / F1 / AMBER Score)、MME(Perception / Cognition);机制分析用 COCO 2014 验证集的 500 张图。
- 关键结果:
- CHAIR_I:LLaVA-1.5-7B 从最佳可靠基线 PAI 的 6.2 降到 3.8(−38.7%);Shikra-7B 从 Devils 的 9.3 降到 5.0(−46.2%);LLaVA-1.5-13B 从 8.6 降到 5.0(−41.9%);MiniGPT-4 从 7.6 降到 6.9(−9.2%)。
- CHAIR_S:LLaVA-1.5-7B 23.8→18.2(−23.5%)、Shikra 26.2→15.8(−39.7%)、LLaVA-1.5-13B 29.0→21.8(−24.8%)、MiniGPT-4 21.9→21.8(−0.5%)。注:论文把 VISTA 的部分 CHAIR 分数标记为”potentially unreliable”(粉色格),百分比是对”最佳可靠基线”计算的。
- POPE:LLaVA-1.5-7B F1 86.2、Acc 86.2(分别 +0.3%);POPE-Chat F1 88.0、Acc 87.0;MiniGPT-4 POPE-Chat 80.2/80.2(+1.0%/+1.8%);LLaVA-1.5-13B POPE Acc 84.7、POPE-Chat 87.9/86.6。
- Qwen2-VL-7B:CHAIR_S 27.6→22.8、CHAIR_I 8.8→6.2、POPE F1 79.2→79.4、Acc 89.1→89.3、MME 2268.4→2290.2。
- MME(vanilla→HAVAE):LLaVA-1.5-7B Perception 1472.5→1483.9、Cognition 322.5→327.9;MiniGPT-4 731.9→744.8、173.0→183.9;Shikra 962.0→976.0、250.4→272.5;LLaVA-1.5-13B 1515.0→1528.9、290.6→295.4。
- AMBER(LLaVA-1.5-7B):CHAIR_I 3.6(−5.3% vs 最佳基线 Devils 3.8)、Cover 51.7(+2.2%)、Hal 20.2(−1.5%)、Acc 78.6(+0.8%)、F1 82.7(+1.7%)、AMBER Score 89.6(+0.9%);Shikra AMBER Score 89.4(+2.3%)、Hal 17.8(−20.9%)。
- 调头策略消融(Table 4,LLaVA-1.5-7B):只按最大视觉注意力选头(I_inert=∅)会让 POPE F1 从 76.7 掉到 65.8、MME Perception 从 1483.9 掉到 1399.0、Cognition 从 327.9 掉到 277.0——证明”原始注意力高”是坏的代理指标。
- 与 AVISC 对比(附录 Table 11):POPE 83.2/84.1 → 86.2/86.3;MME Perception 1379.3→1483.8;AMBER CHAIR 12.6→3.6、Acc 70.7→78.6、F1 75.2→82.7。
- 其它消融:样本量达到 500 后指标稳定;惩罚 Inert Token 注意力的 β 消融显示正向增强更优;τ_r、τ_s 在 0.8×~1.2× 最优值之间波动时性能稳定。
- 对比方法:PAI(注意力干预)、Devils(注意力干预)、VISTA(activation steering),附录另与 AVISC 做了完整比较。
6. 论文结论
- 作者自述贡献:① 首次给出 LVLM 中 Vocabulary Hijacking 的机制分析,提出 HABI 可靠定位 Inert Tokens;② 提出 NHAR 指标与免训练干预 HAVAE,选择性增强对幻觉最关键的注意力头;③ 在多种架构上取得 SOTA 幻觉抑制效果,且零额外计算开销、通用能力不降反升。
- 局限与未来工作:Vocabulary Hijacking 的机制成因尚未完全阐明(具体是什么样的训练动力学导致无意义词固化成 Hijacking Anchors 仍是开放问题);受算力限制实验只覆盖到 13B 参数规模,更大模型待验证;作者还提出”用训练式策略来缓解 Vocabulary Hijacking”是重要的后续方向。伦理部分提示在医疗、法律等高风险领域使用需人工复核,幻觉缓解不等于消除错误。
[16] CVPR2026 — Beyond the Global Scores: Fine-Grained Token Grounding as a Robust Detector of LVLM Hallucinations
- 会议:CVPR 2026(arXiv 录用说明:Accepted at CVPR2026 Main Track)
- arXiv:2604.04863 — https://arxiv.org/abs/2604.04863
- 本地 PDF:
CVPR2026-Beyond the Global Scores Fine-Grained Token Grounding as a Robust Detector of LVLM Hallucinations.pdf - 一句话定位:把”该 token 与整图的相关性”换成”该 token 与每个 patch 的落点”,用注意力离散度+跨模态对齐一致性做 token 级幻觉检测。
1. 中文摘要
本文指出主流幻觉检测方法沿用”全局统计”范式——只看目标 token 与整幅图像的整体相关性(如把所有 patch 的注意力求和、看输出 token 概率、或用外部模型算 embedding 相似度)。这种粗粒度做法有一个致命漏洞:幻觉 token 往往在许多局部区域上各自只有很弱、但分布很散的相关性,累加起来却显得”与整图高度相关”,于是骗过检测器;再叠加 attention sink 现象,SVAR 这类 SOTA 检测器会频繁误判。作者的出发点是”忠实存在的物体 token 必须强落在某个具体图像区域”。据此提出 patch 级检测框架,并在模型各层揭示幻觉 token 的两个签名:① 注意力弥散、非局部化(忠实 token 则紧凑聚焦);② 与任何视觉区域都缺乏有意义的语义对齐。作者把两者形式化为 Attention Dispersion Score(ADS:先用 top-x% 激活+8 连通域分组并压掉小于阈值的小碎块以剔除 attention sink,再用前景 blob 质量与背景归一化 Shannon 熵组合成 (1−m)·Ĥ)与 Cross-modal Grounding Consistency(CGC:token 隐状态与 patch 隐状态余弦相似度的 top-k 均值)。把逐层 ADS 与 CGC 向量拼接为 2L 维特征,接 XGB/RF/MLP 轻量分类器即得可解释的 token 级检测器,token 级检测准确率最高约 90%。
2. 方法图
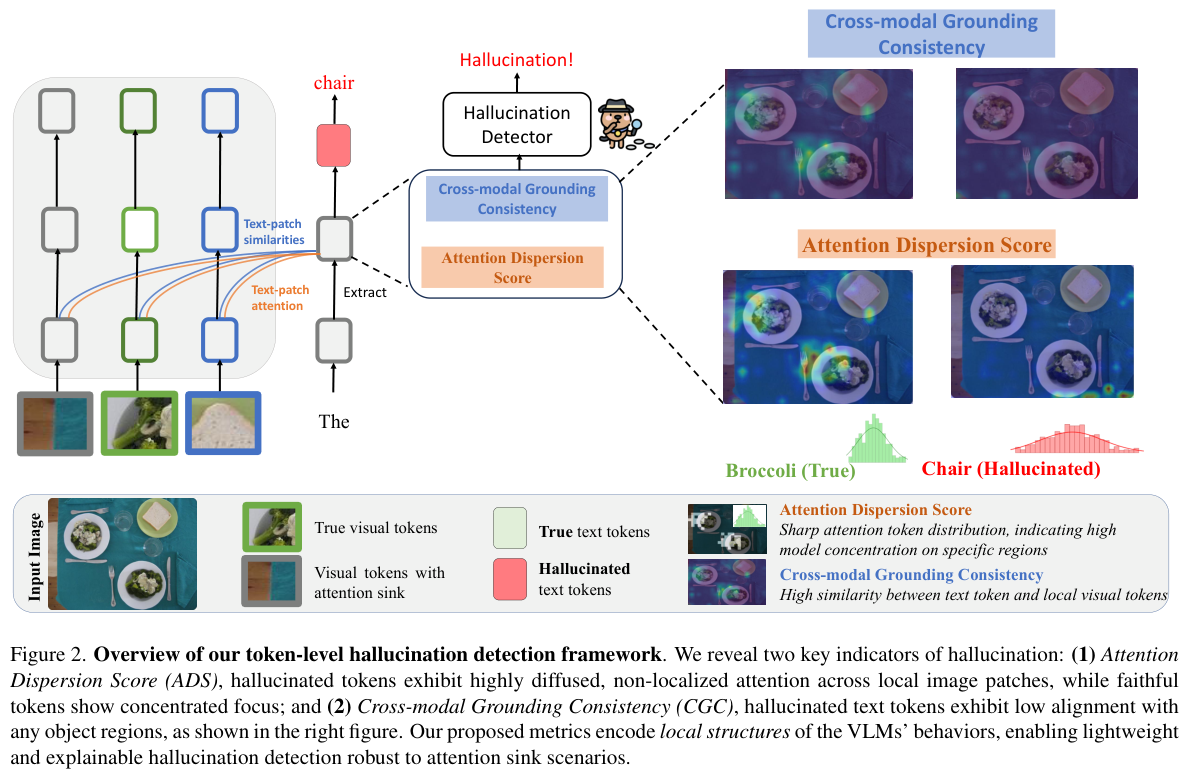
3. 研究动机
- 现有做法的缺陷:全局范式(total attention 聚合、前序 token 注意力、输出概率、外部模型 embedding 相似度)”evaluate the global image-token correlation rather than examining grounding at the level of specific image regions”。幻觉 token 的弱相关分散在大量 patch 上,求和后反而显得相关度高;SVAR 使用全局统计时还会被 attention sink 带偏(Figure 1 左给出误报与漏报的示意)。
- 本文的关键观察/假设:如果物体真的在图中,其 token 必须与”物体实际出现的那块区域”强对齐。于是检测应当下沉到 patch 级。
- 经验证据:Figure 4 给出 LLaVA-1.5-7B 在第 10/17/22 层的注意力图,真实 token(”camera”)聚焦在物体位置,幻觉 token(”wristwatch”)注意力散射全图;Figure 5 与 Figure 8 显示真实 token 在早/中层注意力熵更低、patch 相似度更高(p 值极小),而到约第 25 层之后两者差距收窄,说明深层语言先验主导。
- 推论:作者据此认为幻觉主要源于对语言先验的过度依赖,而不是视觉编码器本身缺陷——真实 token 的特征仍与其真实位置正相关。
4. 研究方法
- 总体流程:对一个 LVLM 生成的每个物体 token,逐层计算 ADS 与 CGC 两个 patch 级指标,拼成特征向量后送轻量分类器判定该 token 是”真实物体”还是”幻觉物体”。
- 模块 A(Attention Dispersion Score, ADS):先把各头注意力平均得层内 patch 注意力图
Ā_t^(n) = (1/H)Σ_h A_t^(n,h);保留 top-x%(x=10)patch 得到前景集 F,其余为背景 B;对保留 patch 做 8-connected 连通域分组,删掉面积小于阈值 τ_ADS 的碎块以剔除 attention sink,得到有效连通域 C*;再组合两个信号:前景 blob 质量m = Σ _ {c∈C*} Σ _ {p∈c} Ā(p)与背景上的归一化 Shannon 熵Ĥ = −Σ _ {p∈B} E(p)logE(p) / log|P|,最终ADS_t^(n) = (1 − m_t^(n))·Ĥ_t^(n)。ADS 低=注意力集中在连贯前景块、背景安静(有落点);ADS 高=blob 质量散、背景噪声大(幻觉)。只用 ADS 逐层向量的线性分类器 F1 已在 0.73–0.77。 - 模块 B(Cross-modal Grounding Consistency, CGC):在第 n 层取 token 隐状态 h_t 与 patch 隐状态 v_p,算余弦相似度
S_t,p = ⟨h_t,v_p⟩/(‖h_t‖‖v_p‖),取 top-k 个 patch 平均得C_t^(n) = (1/k)Σ _ {p∈T} S_t,p。真实 token 在相关 patch 上出现尖峰,幻觉 token 整体低且弥散(Figure 9)。CGC 分类器在三个模型上 F1 分别为 0.79(LLaVA-1.5-7B)、0.81(Qwen2.5-VL-7B)、0.76(InternVL-2.5-8B)。 - 模块 C(特征拼接与分类器):把逐层指标拼成
f_t = [ADS_t || C_t] ∈ R^{2L},用 XGBoost / Random Forest / MLP 三种轻量模型做二分类;超参由 grid search 选出(XGB:depth 6、lr 0.05、500 estimators;RF:depth 10、400 trees;MLP:hidden 128、lr 0.001、Adam)。 - 模块 D(数据与标签):从 MS-COCO 2014 验证集随机取 4000 张图(90/10 划分),用 “Describe this image” 提示生成描述;token 级真/幻标签不用 CHAIR 工具包而改用 GPT-4o,同时提供图像、COCO 人工 caption 和 ground-truth 物体清单,以减少歧义导致的漏标/过标;非视觉 token(如功能词)在训练与推理中都排除。POPE 上用 “Yes”/问题中的物体词做特征提取,正负样本 3339/217(约 6.1% 幻觉,严重不平衡),采用 5 折验证并报 F1 与 AUC。
- 默认超参:ADS 前景阈值 top-x% = 10,连通域 k = 8;CGC top-k% = 5。
5. 实验结果
- 基座模型:LLaVA-1.5-7B、Qwen2.5-VL-7B、InternVL-2.5-8B。
- 数据集与基准:MS-COCO 2014 验证集图像描述任务(4000 张,90/10 划分,GPT-4o 打 token 级标签)、POPE(Yes/No 格式,含 3339 真 / 217 幻觉样本)。
- 关键结果:
- MS-COCO 图像描述 token 级检测(F1 / AUC):Ours(XGB) 在 LLaVA-1.5-7B 为 0.82 / 0.88、Qwen2.5-VL-7B 为 0.84 / 0.94、InternVL-2.5-8B 为 0.90 / 0.94;Ours(MLP) 为 0.80 / 0.86、0.81 / 0.93、0.90 / 0.93;Ours(RF) 为 0.80 / 0.86、0.80 / 0.93、0.88 / 0.93。总体达到 0.8–0.9 区间,论文称最高约 90% token 级检测准确率。
- 对比基线(LLaVA-1.5-7B, F1/AUC):HalLoc 0.71/0.76、MetaToken(LR) 0.51/0.57、MetaToken(GB) 0.68/0.72、SVAR 0.76/0.75、DHCP 0.73/0.80、ProjectAway 0.79/0.85;Ours(XGB) 为 0.82/0.88,即超过次优基线约 5%~15%(论文原句表述为 up to 19%)。
- POPE(LLaVA-1.5-7B,类别极不平衡故报 F1/AUC):Ours 0.41 / 0.75,优于次优 ProjectAway 的 0.38 / 0.70(+6% / +2%);SVAR 在该设置下仅 0.25 / 0.37。
- 特征消融(AUC / F1):LLaVA-1.5 上 ADS 单独 0.86/0.80、CGC 单独 0.84/0.79、CGC+ADS 0.92/0.84;Qwen2.5-VL-7B 0.93/0.76 → 0.93/0.80 → 0.95/0.85;InternVL-2.5-8B 0.90/0.87 → 0.93/0.90 → 0.94/0.90,说明两个信号互补(注意力紧凑但语义不匹配,或注意力弥散却碰巧匹配,都各只有一半信息)。
- 与 SVAR 特征拼接(AUC / F1):LLaVA-1.5 85.12/69.35 → 89.41/74.07;Qwen2.5-VL 87.85/76.38 → 90.28/81.09;InternVL-2.5 86.21/76.31 → 89.54/81.56。
- 层选择消融(LLaVA-1.5 + MLP):只用 layers 6–12 时 ADS AUC 72.38、CGC AUC 76.51;用全部层最好(ADS 85.84、CGC 84.41),原因是中层(约 12–24 层)语义最丰富、末层偏向语言精修;SHAP 值分析结论一致。
- 阈值敏感性:ADS 的 top-x% 在 5%
30% 时 AUC 约 79.8–83.9;CGC 的 top-k% 在 1%10% 稳定(AUC 约 81.4–83.9),选到 20% 时 F1 掉到 72.96。
- 对比方法:MetaToken(LR / GB 两个变体)、HalLoc、DHCP、ProjectAway、SVAR。
6. 论文结论
- 作者自述贡献:① 指出在 patch 粒度上分析文本 token 与具体图像区域的关系才能有效检测幻觉,并据此揭示 LVLM 隐藏层中的结构性行为;② 提出 ADS 与 CGC 两个新指标;③ 给出两条关键发现(真实 token 注意力紧凑且与对应 patch 语义相似,幻觉 token 注意力弥散且与任何区域对齐都弱),并据此构建融合隐层表示与统计量(熵、patch 相似度、置信度对齐)的检测器,token 级准确率最高约 90%。
- 局限与未来工作:论文正文没有 Limitation / Future Work 章节,作者未明确说明(论文未报告)。补充材料中可看到对阈值(top-x%、top-k%)的敏感性分析:当保留 patch 比例超过约 15% 时会把注意力噪声与 sink 一并选入,性能下降;此外检测器依赖 GPT-4o 生成 token 级标签,标注成本与标签质量的影响论文未做讨论。
[17] CVPR2026 — Fighting Hallucinations with Counterfactuals: Diffusion-Guided Perturbations for LVLM Hallucination Suppression
- 会议:CVPR 2026(arXiv 录用说明:CVPR 2026)
- arXiv:2603.10470 — https://arxiv.org/abs/2603.10470
- 本地 PDF:
CVPR2026-Fighting Hallucinations with Counterfactuals Diffusion-Guided Perturbations for LVLM Hallucination Suppression.pdf - 一句话定位:用扩散模型”故意改图”造出反事实样本,离线估出视觉幻觉子空间,推理时把隐状态投影掉。
1. 中文摘要
本文提出 CIPHER(Counterfactual Image Perturbations for Hallucination Extraction and Removal),一个免训练、test-time 的幻觉抑制方法,专门针对视觉模态引发的幻觉——作者认为此前的免训练方法(如 Nullu)主要处理文本扰动引起的幻觉,视觉侧的幻觉方向尚未被利用。CIPHER 分两段。离线阶段:从 MSCOCO 训练集取 M=5000 个图文对,先用 GPT(GPT-3.5)把 ground-truth caption 改写成含”貌似合理但实际不存在物体”的幻觉 caption,再用 Stable Diffusion v1.5 的 VAE 编码原图、做 th=0.5T 步部分前向加噪,并以幻觉 caption 为条件反向去噪,得到结构大体保留但语义被改动的反事实图,每个原图用 B=5 个不同噪声种子生成 5 个变体,共 25,000 张,构成 OHC-25K。把 (原图, GT caption) 与 (反事实图, GT caption) 分别喂给冻结的 LVLM,取 caption token 的均值隐状态相减得到 δ,把所有样本的 δ 堆叠成矩阵做 SVD,前 r 个右奇异向量即”幻觉基”存入 Hallucination Basis Bank。推理阶段:在每个解码步、选定层(16–32)上把隐状态投影到该子空间的正交补 h_clean = h − Σ_j ⟨h, v_j⟩v_j = (I − V V^T) h,从而抹掉易致幻方向。整个过程不改参数、单次前向,吞吐与贪心解码持平。
2. 方法图
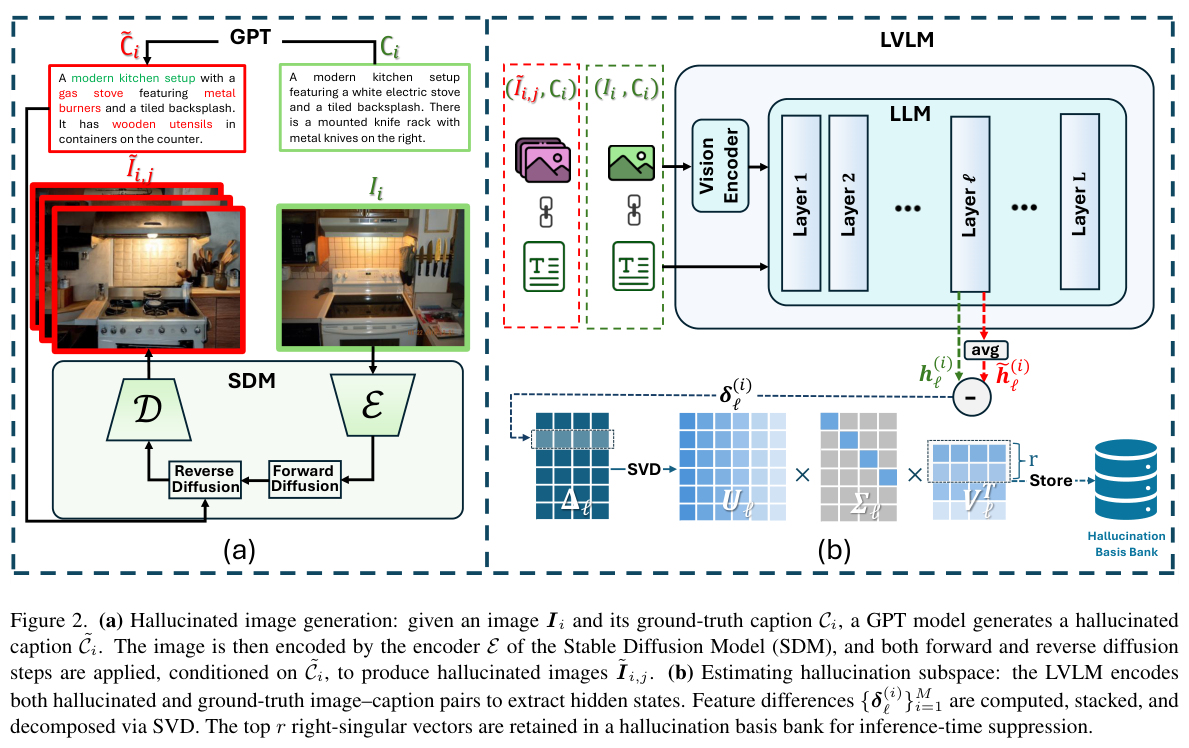
3. 研究动机
- 现有做法的缺陷:训练类方法需要昂贵标注/重训/改结构;后处理类依赖外部工具,泛化与部署都受限;test-time 方法里解码式的(如对比解码)需要多次前向、推理开销大。作者特别指出:test-time 特征级干预虽然只需一次前向,但”existing methods predominantly target hallucinations arising from the language component, leaving vision-induced hallucinations comparatively underexplored”——Nullu 是用文本扰动抽幻觉方向,没有从视觉侧动手。
- 本文的关键观察/假设:既然幻觉有一部分源于视觉,就应该直接制造”看起来合理但语义错误”的图像来逼出模型在这类输入下的表示偏移。作者用受控的部分扩散(保留全局结构、注入语义错误元素,例如凭空多出一串葡萄)来获得这种反事实图,再用”有幻觉图 vs 无幻觉图”在同一 GT caption 下的表示差作为幻觉方向。
- 可行性验证:逐层线性探针实验(Figure 6)显示,文本扰动造成的表示可分性只有中等且层间波动大(Accuracy 0.73–0.80、F1 0.74–0.78),而扩散式视觉扰动在所有层都稳定高可分(Accuracy 0.86–0.89、F1 0.86–0.89),说明视觉反事实捕捉到的是更结构化、更稳定的幻觉方向。
4. 研究方法
- 总体流程:离线造反事实数据 → 抽幻觉子空间并存基银行 → 推理时逐层正交投影。全程免训练、不修改模型参数,单次前向完成。
- 模块 A(Counterfactual Dataset Generation, OHC-25K):
z0 = E(I_i);˜z_th = √(ᾱ_th)·z0 + √(1−ᾱ_th)·ϵ;以幻觉 caption 为条件反向去噪˜z _ {t−1} = f_θ(˜z_t, t, ˜C_i);解码得˜I _ {i,j} = D(˜z0),j=1..B(B=5)。最终OHC-25K = {(˜I _ {i,j}, C_i)},即反事实图仍配原始 GT caption,形成”图文冲突但结构对齐”的样本;幻觉 caption 的生成沿用 LURE 的做法。 - 模块 B(Hallucination Subspace Estimation):对每个图文对取 caption token 在层 ℓ 的隐状态并做均值池化得
h_ℓ^(i);B 个变体先各自池化再对 B 求平均得˜h_ℓ^(i);方向δ_ℓ^(i) = ˜h_ℓ^(i) − h_ℓ^(i);堆叠成Δ_ℓ ∈ R^{M×d}后做 SVDΔ_ℓ = U_ℓ Σ_ℓ V_ℓ^T,取前 r 个右奇异向量V _ {ℓ,r}组成该层的幻觉子空间(hallucination basis bank)。 - 模块 C(Test-Time Nullification):
h_clean = h_test − Σ _ {j=1}^r ⟨h_test, v _ {ℓ,j}⟩v _ {ℓ,j},等价于投影矩阵P_ℓ = I − V _ {ℓ,r}V _ {ℓ,r}^T作用在隐状态上;在生成每个 token 之前对选定层施加。 - 关键超参:子空间秩 r 按模型网格搜索——LLaVA-1.5 用 r=8、MiniGPT-4 用 r=64、mPLUG-Owl2 用 r=32;投影层 16–32;扩散步 th=0.5T;SD v1.5、classifier-free guidance 7.5;beam size 3、temperature 0;CHAIR 最多生成 64 token、OPOPE 256、LLaVA-Bench 1024。
5. 实验结果
- 基座模型:LLaVA-1.5(Vicuna)、MiniGPT-4(LLaMA2)、mPLUG-Owl2。
- 数据集与基准:CHAIR(CHAIR_S / CHAIR_I,另报 BLEU)、Offline POPE(OPOPE,random/popular/adversarial 三种负采样,报 Accuracy/Precision/F0.2)、MMHal-Bench(8 类幻觉,GPT-4 评 informativeness,见 Figure 4 雷达图)、LLaVA-Bench(GPT-4V 打 accuracy 与 detailedness)。离线造数据用 MSCOCO 训练集 5000 对,评测用 MSCOCO 验证集随机 500 张;结果报 3 个随机种子的均值±标准差。
- 关键结果:
- CHAIR_S(LLaVA-1.5):CIPHER 13.05±0.57,对比 Greedy 20.40、OPERA 17.50、HALC 16.90、Nullu(次优)15.20,即比次优绝对降 2.15、比贪心降 7.35;CHAIR_I 4.53(Greedy 7.08、Nullu 5.30);BLEU 15.82。
- CHAIR_S(MiniGPT-4):CIPHER 18.48±1.20(Greedy 32.40、Nullu 21.40、HALC 25.20,比次优改善 2.92、比贪心降 13.92);CHAIR_I 8.33、BLEU 15.10。
- CHAIR_S(mPLUG-Owl2):CIPHER 13.60±1.06(Greedy 22.90、Nullu 15.60),比次优改善 2.00、比原始模型改善 9.30;CHAIR_I 4.92、BLEU 16.25(三个模型上 BLEU 都保持或提升)。
- OPOPE(三模型全指标第一):LLaVA-1.5 Accuracy 80.05 / Precision 93.72 / F 92.11(Greedy 79.14/91.98/90.45、Nullu 79.52/93.46/91.79);MiniGPT-4 72.25/96.50/92.58(Greedy 71.22/93.72/90.04);mPLUG-Owl2 77.87/92.93/90.95(Greedy 76.46/88.85/87.29)。
- LLaVA-Bench(GPT-4V):LLaVA Accuracy 6.79→7.08、Detailedness 6.33→6.75;MiniGPT-4 5.54→6.16、5.58→6.64;mPLUG-Owl2 6.48→7.35、6.26→6.91。
- MMHal-Bench:Figure 4 雷达图显示 LLaVA+CIPHER 在全部 8 类上均优于原始 LLaVA,增益最大的是 Attribute、Environment、Holistic 与 Adversarial(论文未给具体数值表)。
- 效率(Table 4,LLaVA-7B、A6000):CIPHER 吞吐 0.70 items/s,与 Greedy 持平;对比 Beam 0.55、DoLa 0.42、VCD 0.35、OPERA 0.10、HALC 0.05、Nullu 0.70。
- 消融:① 幻觉来源——只用图像扰动最好(CHAIR_S 13.05 / CHAIR_I 4.53 / BLEU 15.82),只用文本扰动为 15.20/5.30/15.69,文本+图像联合反而略差(15.71/5.32/15.66);② 扩散步长 th∈{0.25T,0.5T,0.75T,T} 中 0.5T 最佳;③ 子空间秩 LLaVA r=8 最佳,MiniGPT-4 r=64、mPLUG-Owl2 r=32;④ 投影层区间 16–32 最佳(CHAIR_S 13.05),16–24 最差(18.10);⑤ 高斯噪声(σ 从 0 到 1.0)下 CIPHER 的 CHAIR_S 始终低于原始模型,噪声越强差距越大。
- 对比方法:test-time 类 DoLa、VCD、HALC、OPERA、Nullu;后处理类 Woodpecker、LURE;另有 Greedy 与 Beam Search 基线(附录说明基线结果取自 Nullu 论文的复现配置)。
6. 论文结论
- 作者自述贡献:① 提出 CIPHER,免训练、test-time、专门针对视觉模态幻觉;② 提出扩散引导的反事实数据构造流程 OHC-25K(25,000 张语义与 GT caption 冲突的编辑图),用以估计幻觉子空间;③ 推理时把隐状态投影到该子空间的正交补即可抑制幻觉,无需重训或改参数;④ 多基准实验表明幻觉率下降且生成质量保持。
- 局限与未来工作:论文没有单独的 Limitation 章节,作者在 “Conclusion and Future Work” 中只给出一条未来方向——当前用的是固定的离线投影,未来希望做到按输入动态自适应投影,以获得更灵活的上下文感知抑制(论文未报告其他局限)。
[18] CVPR2026 — FINER: MLLMs Hallucinate under Fine-grained Negative Queries
- 会议:CVPR 2026(arXiv 录用说明:CVPR 2026)
- arXiv:2603.17662 — https://arxiv.org/abs/2603.17662
- 本地 PDF:
CVPR2026-FINER MLLMs Hallucinate under Fine-grained Negative Queries.pdf - 一句话定位:造了两套”细粒度否定问句”基准,逼 MLLM 对多项物体/属性/关系中的单点错误说”不”。
1. 中文摘要
本文指出既有幻觉基准多停留在粗粒度提问(POPE、DASH 只查单个物体是否存在,AMBER 也只含单物体/单属性/单关系),而真实用户的问题往往是细粒度的。作者定义”negative query”(询问图中不存在内容的问句),并做了动机实验:把否定问句按”物体→加属性→加关系”的方式逐级加细,构造 7 个粒度等级,每个样本只注入一处矛盾(NEG_OBJ / NEG_ATTR / NEG_REL),正确答案恒为 “No”。结果 InternVL3.5-14B 的准确率随粒度下降,在 FINER-CompreCap 上从第 1 级的约 80% 掉到第 5–7 级的约 20%,在 FINER-DOCCI 上从约 58% 掉到第 6–7 级的约 15%。为系统拆解原因,作者提出两个基准:FINER-CompreCap(基于 CompreCap 的人工标注场景图)与 FINER-DOCCI(用 Gemini-2.0-Flash 从 DOCCI 长 caption 抽场景图,再用 Qwen2.5-VL-72B 过滤+人工抽检),把问句分成 Multi-obj、Multi-attr、Multi-rel、Wh(”what” 自由问答)四类,且都做成 5 选 1 的 MCQ,用”正负配对准确率 Acc_paired”衡量(同一图文对的正、负两版都必须答对)。最后提出 FINER-Tuning:用 Pixmo 长 caption + Phi-4-14B 抽取并改写正/负短语,构造偏好对做 DPO,让模型学会识别问句本身的细粒度错误。
2. 方法图
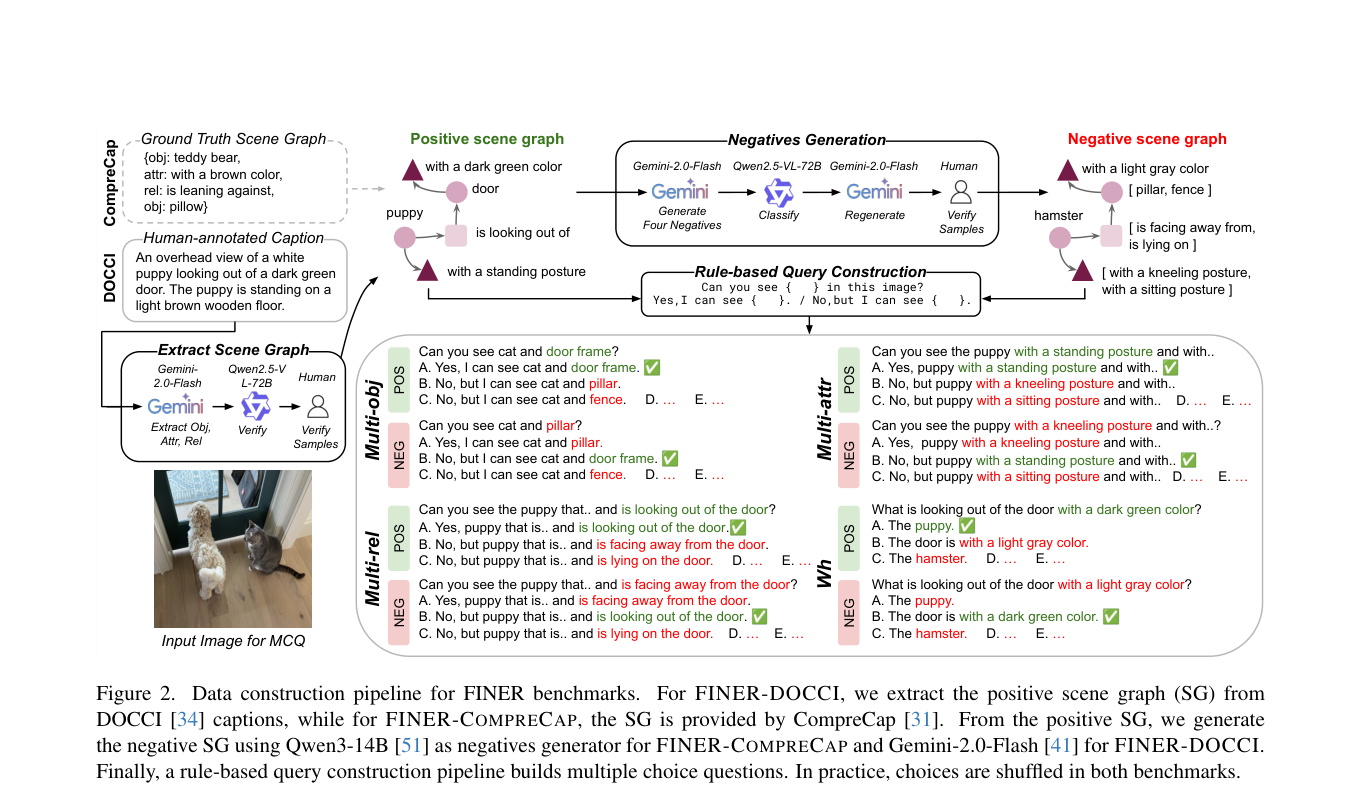
3. 研究动机
- 现有做法的缺陷:MLLM 对否定问句容易产生 false positive(不会答 “No”),但现有探针太粗——“POPE and DASH focus on single object presence, and AMBER includes only single objects, attributes, and relations”。也就是说,已有基准无法回答”模型能否拒绝同时涉及多个物体、属性、关系的细粒度错误”。
- 本文的关键观察/假设:把否定问句的粒度逐步加细,模型的准确率会单调下降;并且真正的难点形态是”细粒度错误与图中真实存在的元素共存“——例如问句里 3 个物体都对、只有第 4 个被替换成不存在的物体(如把 “door frame” 换成 “pillar”),模型就会顺着已有内容答 “Yes”。
- 评测协议层面的取舍:作者认为二值 Yes/No 容易受模型偏置影响,所以改用 5 选 1 MCQ(正确项+”No, but I can see …”式的干扰项),并且每个负例 MCQ 都配一个对应的正例 MCQ,要求两版都答对才算对(paired accuracy),从而堵住”一律答 No”或”一律答 Yes”的捷径。
4. 研究方法
- 基准构建(场景图 → 负例 → 模板问句):以场景图 SG 为基础,含物体 OBJ、属性 ATTR、关系 REL;为每个成分生成语义上貌似合理但错误的负例(NEG_OBJ / NEG_ATTR / NEG_REL),每个实体生成四个不同负例变体(区别于 POPE/DASH 只用单个负例)。正例问句由正 SG 中同类多元素模板组合而成(如 “Can you see cat and door frame?”),负例问句则把其中一个元素替换为随机负例(如 “Can you see cat and pillar?”)。MCQ 的正确答案要求模型指出图中真正存在的实体(如 “No, but I can see cat and door frame”),其余负例变体充当干扰项,选项在基准中被打乱。
- 两个基准:FINER-CompreCap 基于 CompreCap 的人工标注场景图(限于 COCO 图像),含 6,300 条 Multi-obj、3,338 条 Multi-attr、4,280 条 Multi-rel、3,166 条 Wh MCQ,每题最多 6/3/3 个物体/属性/关系;FINER-DOCCI 基于 DOCCI 的 5K 图像与长人工 caption,用 Gemini-2.0-Flash 抽场景图、Qwen2.5-VL-72B 过滤、人工抽检,含 10,000 条 Multi-obj、28,630 条 Multi-attr、11,542 条 Multi-rel、20,944 条 Wh MCQ,每题最多 6/5/3 个成分。
- 四类评测设置:Multi-obj / Multi-attr / Multi-rel 考察存在性与属性-物体绑定(binding)能否在多元素共存时定位错误;Wh 设置是”错配前提”式的自由问答(对一个真实物体问带错误属性的 what 问题,如 “What is looking out of the door with a light dark green color?” 的正误两版),考察事回答与前提纠错。
- 评测指标(paired accuracy):
Acc_paired = (1/N) Σ_i Γ(M(x_i, q_i+))·Γ(M(x_i, q_i−)),Γ 为答对指示函数;只有正、负两版都答对才计 1 分,因此随机猜测只有 4.0%。 - FINER-Tuning(DPO 训练配方):① 从 Pixmo-caption 长描述中用 Phi-4-14B 抽正短语 Ψ+(对应 OBJ / ATTR / REL / WH 四类);② 让同一 LLM 随机替换一个实例生成负短语 Ψ−;③ 用模板(5 套模板以避免过拟合基准的 prompt 模式,Wh 类直接由 LLM 生成)构造 (q+, a++, a−+) 与 (q−, a+−, a−−) 偏好对;④ 标准 DPO 损失
L = −E[log σ(β(Δθ − Δref))],β=0.1,只去除 COCO 与 DOCCI 训练切分以避免数据泄漏,最多 160k 偏好对、LoRA 训练 1 个 epoch(LLaMA-Factory)。 - 评测工具链:主要用 VLMEvalKit 做标准化评测,未集成的基准按各自官方协议评测;共 3 类任务、16 个基准。
5. 实验结果
- 基座模型(被评测/被微调):LLaVA-NeXT-7B(LLaVA-1.6-7B)、Qwen2.5-VL-7B-Instruct、InternVL-3.5-8B、InternVL-3.5-14B(这四个做了 FINER-Tuning);另作为参照评测 InternVL-3.5-38B、Gemini-2.5-Flash,以及幻觉感知微调基线 LRV-V2-13B、LLaVA-RLHF-13B、RLHF-V-13B、OPA-DPO-13B、RLAIF-V-12B(其基线 OmniLMM-12B)。
- 数据集与基准:本文提出的 FINER-CompreCap(FINER-COMPRECAP) 与 FINER-DOCCI 两个基准;外部对照含 8 个幻觉基准(DASH、POPE、RePOPE、HallusionBench、AMBER、CRPE relation split、MMHal-Bench、HaloQuest)与 6 个通用能力基准(MMStar、TextVQA、ChartQA、MMVP、NaturalBench、V*Bench)。
- 关键结果(Acc_paired,格式为 正版/负版配对,即 CompreCap 的 Multi-obj/Attr/Rel/Wh 与 DOCCI 的同四项):
- Random Guess:四项、两基准均为 4.0。
- LLaVA-1.6-7B:25.3 / 13.0 / 7.6 / 15.3(CompreCap)、10.1 / 12.3 / 8.2 / 13.3(DOCCI)→ FINER-Tuning 后 48.4 / 38.4 / 24.2 / 22.1(分别 +23.1 / +25.4 / +16.6 / +6.8)、26.4 / 29.4 / 24.7 / 18.5(+16.3 / +17.1 / +16.5 / +5.2)。
- Qwen2.5-VL-7B:69.2 / 62.5 / 30.1 / 28.9、48.7 / 47.5 / 36.7 / 23.4 → 71.4 / 67.0 / 38.3 / 34.8(+2.2 / +4.5 / +8.2 / +5.9)、49.8 / 52.2 / 43.4 / 28.0(+1.1 / +4.7 / +6.7 / +4.6)。
- InternVL-3.5-8B:75.0 / 72.5 / 49.8 / 23.5、58.1 / 54.3 / 41.8 / 16.8 → 77.1 / 78.9 / 64.1 / 34.2(+2.1 / +6.4 / +14.3 / +10.7)、62.6 / 60.1 / 52.7 / 23.7(+4.5 / +5.8 / +10.9 / +6.9)。
- InternVL-3.5-14B:74.5 / 68.1 / 47.0 / 21.8、58.6 / 55.9 / 41.4 / 15.6 → 80.0 / 78.9 / 71.2 / 30.1(+5.5 / +10.8 / +24.2 / +8.3)、65.9 / 65.0 / 57.0 / 23.0(+7.3 / +9.1 / +15.6 / +7.4);论文强调最大增益 24.2% 出现在 Multi-rel,且 14B+FINER-Tuning 在该子集超过 38B 版本的 66.8 达 4.4 个百分点。
- 更强参照:InternVL-3.5-38B 为 77.8 / 78.1 / 66.8 / 50.9、62.3 / 64.8 / 54.2 / 36.6;Gemini-2.5-Flash 为 75.7 / 77.3 / 77.8 / 58.2、64.4 / 64.5 / 56.7 / 49.6(Wh 类两模型在 DOCCI 上仅 36.6 与 49.6)。
- 旧式幻觉微调基线在 FINER 上几乎失效:RLHF-V-13B、LLaVA-RLHF-13B 在 CompreCap 的 Multi-rel 上只有 1.6% 与 1.1%;RLAIF-V-12B 虽是这类方法中最好的(62.2 / 39.6 / 19.2 / 20.5、46.5 / 31.7 / 32.4 / 19.4),仍显著低于前沿 MLLM。
- 人类表现(每种设置 20 题、共 160 题):CompreCap 92.5 / 92.5 / 97.5 / 95.0,DOCCI 92.5 / 95.0 / 90.0 / 90.0。
- 动机实验(InternVL-3.5-14B,7 级粒度):CompreCap 从第 1 级约 80% 掉到第 5–7 级约 20%;DOCCI 从约 58% 掉到第 6–7 级约 15%。
- 外部幻觉基准(FINER-Tuning 后普遍提升):DASH 上 InternVL-3.5-8B 68.3→74.5(+6.2)、14B 55.8→61.3(+5.5);AMBER 上 LLaVA-1.6 78.1→85.0(+6.9);MMHal-Bench 幻觉率 InternVL-3.5-14B 降到 10%;HaloQuest 上 LLaVA-1.6 44.2→63.5(+19.3)。
- 通用能力(6 个基准平均):LLaVA-1.6-7B 48.4→50.3、Qwen2.5-VL-7B 69.8→70.1、InternVL3.5-8B 68.1→68.7、InternVL3.5-14B 68.0→69.4(+1.4%),即没有出现常见的”对齐税”。
- 消融(InternVL-3.5-8B):同一数据下 SFT 明显更差——同时用正负问句训练时 Multi-obj 从基线 74.2 掉到 37.5(−36.7),只用负例问句时 RePOPE 从 91.5 掉到 69.1;DPO 只用负例问句(75.8 / 75.2 / 52.4 / 29.8)已超过基线但不如正负并用,即 FINER-Tuning(76.5 / 78.3 / 64.1 / 36.1,RePOPE 93.1);只训练某一子集时该子集最好(如只训 Wh 时 Wh 46.5),但训全部子集最均衡。
- 对比方法:RLAIF-V、OPA-DPO、RLHF-V、LLaVA-RLHF、LRV-Instruct-V2 等幻觉感知微调方法,以及 InternVL-3.5-38B、Gemini-2.5-Flash 两个更强模型;论文也报了 human 上界。
6. 论文结论
- 作者自述贡献:① 提出 FINER 这一细粒度否定问句套件与两个基准(FINER-CompreCap、FINER-DOCCI),在 multi-object / multi-attribute / multi-relation / Wh 四类设置下系统评测 MLLM 的否定与纠错能力;② 揭示”细粒度错误与真实元素共存”时模型会幻觉,且粒度越细越严重;③ 提出模型无关的 FINER-Tuning(DPO 配方),在四个前沿 MLLM 上最高带来 24.2% 的配对准确率提升,同时改善 8 个已有幻觉基准与 6 个通用能力基准。
- 局限与未来工作:大规模基准没有完全由人工标注验证,构造无噪声、完全人工验证的 FINER 留待后续;规则模板生成 MCQ 虽然组合灵活,但可能降低问句的自然度,未来可用 LLM 改写或人工重写来改进措辞;Multi-rel 子集最多只含 3 个关系,若有合适数据源可扩展;人类研究规模很小(每子集仅 20 题),只能反映小样本下的人类行为,不能当作基准整体质量的度量。未来还要做更强的 negation-aware reasoning。
[19] CVPR2026 — HulluEdit: Single-Pass Evidence-Consistent Subspace Editing for Mitigating Hallucinations in Large Vision-Language Models
- 会议:CVPR 2026(arXiv 录用说明:accepted at CVPR 2026)
- arXiv:2602.22727 — https://arxiv.org/abs/2602.22727
- 本地 PDF:
CVPR2026-HulluEdit Single-Pass Evidence-Consistent Subspace Editing for Mitigating Hallucinations in Large Vision-Language Models.pdf - 一句话定位:把隐状态拆成正交的”视觉证据/语言先验/残差”三块,只压制先验块来降幻觉。
1. 中文摘要
本文针对大视觉语言模型(LVLM)的物体幻觉,提出 HulluEdit——一个单趟(single-pass)、免参考模型的推理期干预框架。其核心是正交子空间编辑:在编辑层把隐状态 h 分解成三个互相正交的分量——用归一化余弦相似度加权后做加权 SVD 得到的视觉证据子空间 U,在 U 的正交补内从非视觉文本缓存构造的反先验子空间 P,以及两者之外的残差不确定性子空间 R。由于约束 UᵀP = 0 由构造保证,沿 P 方向的抑制在数学上完全不触碰视觉分量 h_U。编辑强度由两个”证书”指标——视觉确定性比 VCR 与先验冲突比 PCR——反比调度,并经最小范数闭式解得到 h′ = h_U + h_P/(1+λn+λp) + h_R/(1+λn);证书感知门控只在 VCR 过低或 PCR 过高时才真正施加编辑。方法不需要训练、不需要二次前向、不需要额外参考模型,在 POPE 与 CHAIR 上跨多种架构取得最好结果,同时保持 MME、MMVet 上的通用能力,额外开销低于同层 O(d²) 复杂度的 2%。
2. 方法图
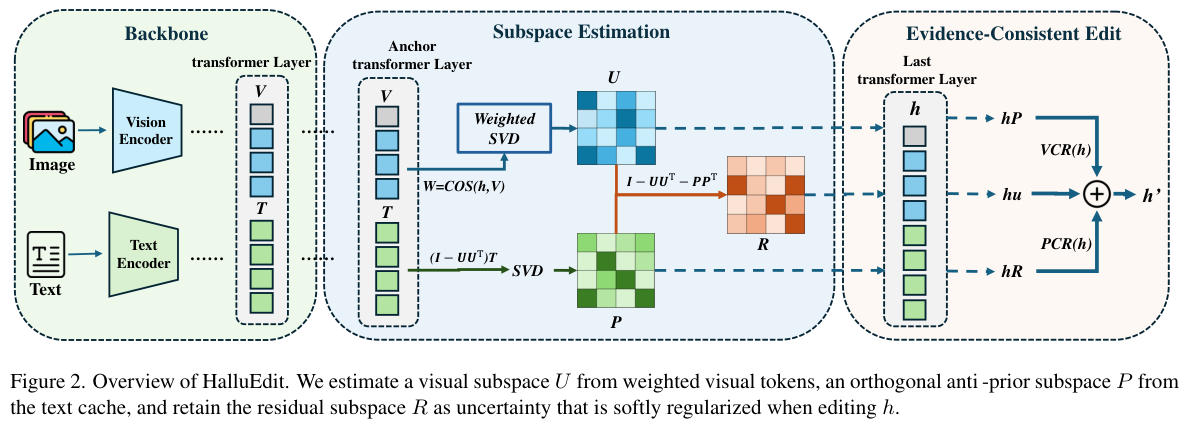
(注:论文标题与摘要写作 HulluEdit,图 2 的 caption 与第 3 节正文误写作 HalluEdit,二者指同一方法。)
3. 研究动机
- 现有做法的缺陷:对比解码类方法(VCD、DoLa 等)”often require a reference model or secondary inference, increasing latency and engineering complexity”;静态子空间编辑类方法(Nullu、VAF)在离线阶段构造 dataset-level 的幻觉子空间,因此 “lack token-level adaptability and risk suppressing genuine visual evidence”。作者总的判断是:这些方法 “lack reliable decoupling mechanisms and fine-grained control between suppressing linguistic priors and preserving visual evidence”。
- 本文的关键观察/假设:受 DeCo 启发,作者观察到 “representations from mid-layers of large models can serve as reliable references for calibrating the output layer”——即中层富集物体视觉证据。于是把锚点层(LLaVA 取第 26 层)的表征用来在线构造样本级子空间,把编辑放在最后一层,让视觉特征在深层”反制”先验抑制。
- 一条设计上的强假设:只要反先验子空间被限制在视觉子空间的正交补里(UᵀP = 0),压制先验就”数学上”不会损伤视觉 grounding;反之,如果两者纠缠,就必然出现”要么压不掉幻觉、要么压掉真实视觉线索”的两难。
4. 研究方法
- 总体流程(三层结构):① 从 anchor transformer layer 一次性抽取并缓存视觉特征矩阵 V ∈ R^{nv×d},同时用滑动窗口维护动态文本缓存 T(来自历史解码步的非视觉隐状态);② 在线估计视觉证据子空间 U 与正交的反先验子空间 P;③ 在最后一层(edit layer)把每个隐状态 h 投影到三个正交子空间并做证书感知的自适应编辑。
- Context-Aware Visual Evidence Subspace(式 1–2):按当前 h 与每个视觉 token 的归一化余弦相似度做 softmax 得到权重 wᵢ,再对加权视觉矩阵做截断 SVD:U,Σ,Vᵀ = SVD(W^{1/2}V),只取前 r 个左奇异向量(UᵀU = I_r),等价于加权 PCA。
- Conflict-Aware Anti-Prior Subspace(式 3):先把文本缓存投影到视觉补空间 T̃ = T(I_d − UUᵀ),再对其取前 q 个左奇异向量得到 P ∈ R^{d×q}。这样 UᵀP = 0 由构造保证。残差子空间由 Π_R = I_d − Π_U − Π_P 给出,满足 h = h_U + h_P + h_R 且能量可加 ‖h‖² = ‖h_U‖² + ‖h_P‖² + ‖h_R‖²。
- 自适应强度与闭式编辑(式 11–18):定义 VCR(h) = ‖h_U‖²/‖h‖²、PCR(h) = ‖h_P‖²/‖h‖²;强度 λn = min(κ·(1−VCR)/VCR, λmax)、λp = min(λ0·PCR/(1−PCR), λmax),即视觉证据越弱越压非视觉成分、先验冲突越强越压 P。求解最小范数二次规划得到唯一闭式解 h′ = h_U + h_P/(1+λn+λp) + h_R/(1+λn)——视觉分量被严格保留;门控 g(h) = 1 当 VCR < γv 或 PCR > γp,最终 h_final = g(h)·h′ + (1−g(h))·h。
- 训练/推理策略与代价:完全免训练、免参考模型、免二次前向,编辑发生在输出层 logits 之前的隐状态上;单 token 开销为 O(nv d r + nt d q)(子空间估计)+ O(d(r+q))(投影)+ O(d)(编辑),在 r = 8、q = 5 ≪ d = 4096、nv ≤ 576、nt ≤ 512 下退化为 O(d(r+q)),不足同层 O(d²) 的 2%。理论上给出三条保证:evidence consistency(VCR(h′) ≥ VCR(h)、PCR(h′) ≤ PCR(h))、non-interference(正交编辑不动视觉分量)、Lipschitz 稳定性。
5. 实验结果
- 基座模型:LLaVA-1.5-7B、LLaVA-1.5-13B、MiniGPT-4、mPLUG-Owl2、Qwen-VL-Chat-7B(”All models utilize their official configurations, with HulluEdit applied purely during inference to the final transformer layer”)。
- 数据集与基准:POPE(Random / Popular / Adversarial 三个 split,报 Accuracy 与 F1)、CHAIR(500 张 MSCOCO 图像,报 CHAIR_i 与 CHAIR_s)、MME(14 个子任务,本文重点看 Existence/Count/Position/Color)、AMBER(CHAIR/Cover/Hal/Cog)、Hallu-Bench(Overall/qAcc/fAcc/aAcc)、MMVet;效率用 500 张 MSCOCO 图上的解码吞吐(TPS)衡量。
- 关键结果:
- POPE-Adversarial(LLaVA-1.5-7B)Accuracy 从 Greedy 77.6 → 本方法 82.5,F1 79.4 → 83.4(同表最强的 VAF 为 80.1/81.0);POPE-Random 上 87.8 → 90.4。作者称在全部 18 个评测设置上都取得最高 Accuracy 与 F1。
- CHAIR(LLaVA-1.5):CHAIR_i 7.08 → 4.18,CHAIR_s 20.40 → 13.00(静态子空间基线 Nullu 为 5.30 / 15.20);mPLUG-Owl2 上 CHAIR_i 8.62 → 3.35、CHAIR_s 22.90 → 13.60。
- MME 上有得有失:Existence 181.67 → 195.00(+13.33)、Position 104.44 → 126.67(+22.23)、Color 152.78 → 160.00(+7.22),但 Count 118.33 → 105.00(−13.33);作者解释为细粒度数值信息可能落在被保守正则化的残差子空间里。
- 消融(LLaVA-1.5-7B / MSCOCO):去掉证书门控最致命,CHAIR_i/CHAIR_s 从 4.18/13.00 退化到 7.70/22.90;锚点层取 20 或 30(5.55/19.72、5.37/13.80)与单层同层编辑(La=Le=last,5.50/18.20)都不如 La=26+末层;换均匀 SVD 为 4.85/13.68,去掉正交补构造为 5.60/15.90,用固定强度为 5.20/13.88;只压残差(5.90/16.82)或只压反先验(5.40/14.66)均差于两者联合。
- 扩展基准:AMBER 的 CHAIR 8.2 → 5.3(相对 Vanilla 降 35.4%),Cog 4.0 → 2.1;Hallu-Bench Overall 27.6 → 30.1(亦高于 QLoRA 的 25.2);MMVet Total 23.6 → 28.5(DeCo 27.9)。
- 对比方法:DoLa、VCD、OPERA、DeCo、Nullu、VAF,另外在 CHAIR 表中还列了 Greedy、Beam Search、Woodpecker、LURE、HALC,POPE 表中列了 ICD。
6. 论文结论
- 作者自述贡献:① Orthogonal evidence–prior decomposition:用加权 SVD 估计样本自适应的视觉证据子空间,并在其余空间构造正交反先验子空间,保证视觉保留与先验抑制互不干扰;② Certificate-aware adaptive editing:基于 VCR/PCR 的闭式自适应强度编辑,在压制幻觉的同时维持视觉保真;③ Efficient single-pass inference:完全在线解码、无参考模型、无额外前向、无参数更新,可跨多种 LVLM 架构通用且开销极小。
- 局限与未来工作:论文未设独立的 Limitation/Future Work 章节(正文与附录中均未见 “limitation” 或 “future work” 小节)。正文唯一自认的代价是 MME 上 Count 能力下降,作者将其归因于细粒度数值信息可能编码在被保守正则化的残差子空间中,但未提出后续解决方案。
[20] CVPR2026 — KVSmooth: Mitigating Hallucination in Multi-modal Large Language Models through Key-Value Smoothing
- 会议:CVPR 2026(arXiv 录用说明:Accepted by CVPR 2026)
- arXiv:2602.04268 — https://arxiv.org/abs/2602.04268
- 本地 PDF:
CVPR2026-KVSmooth Mitigating Hallucination in Multi-modal Large Language Models through Key-Value Smoothing.pdf - 一句话定位:用注意力熵自适应地对 KV-Cache 的键值做 EMA 平滑,压制 sink token 引发的语义漂移。
1. 中文摘要
本文提出 KVSmooth——一个免训练、即插即用的多模态大模型(MLLM)幻觉缓解方法,核心是对 KV-Cache 中的键与值施加注意力熵引导的自适应指数滑动平均(EMA)。作者先给出三点观测:真值物体 logit 的均值与方差随解码单调下降,而幻觉物体 logit 的均值与方差持续上升;注意力”行熵”(row-entropy)可作为 sink 强度的实时代理,与传统列和指标强正相关(余弦相似度分布集中在 0.79);幻觉物体的 logit 排名与其行熵正相关,说明注意力越弥散越会抬高幻觉分数。方法据此设计:假设隐状态满足随机游走先验 h_t = h _ {t−1} + ε_t,推出其 MAP 估计恰好化为 EMA 形式 ĥ_t = (1−λ_t)o_t + λ_t h _ {t−1},并把平滑落在键与值缓存上;再用长度为 M 的 FIFO 队列统计当前 token 行熵的分位排名 k,得到逐 token、逐层的系数 λ̂_t = k/M,并截断在 [λref−0.2, λref+0.2] 区间内。LLaVA-1.5 上 CHAIR_S 由 41.8 降至 18.2、F1 由 77.5 升至 79.2,精度与召回同时提升。
2. 方法图
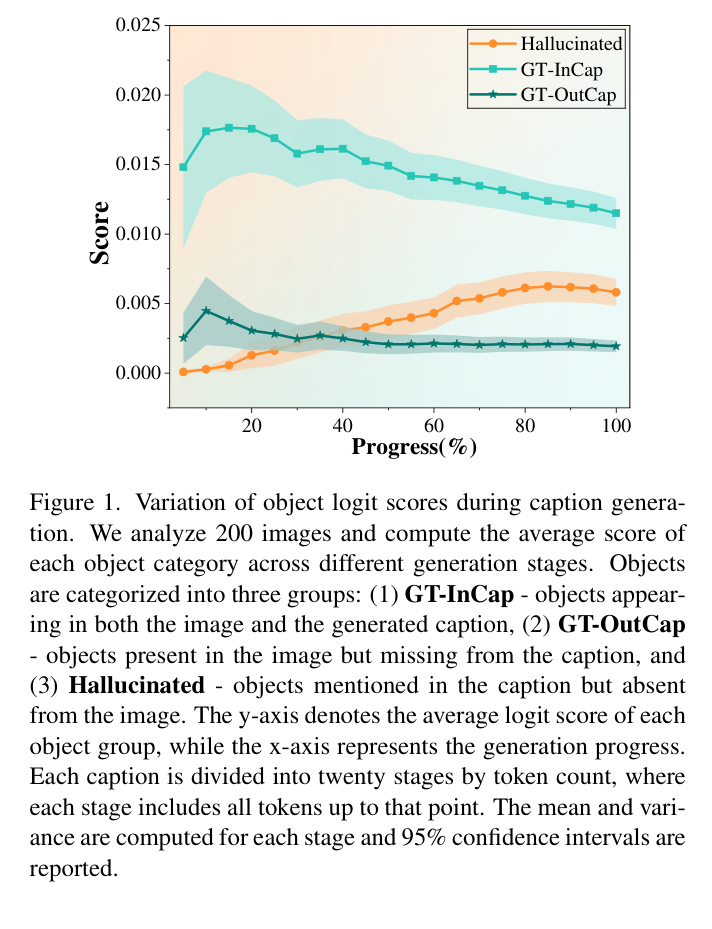
3. 研究动机
- 现有做法的缺陷:论文把已有缓解方法归为对比解码(VCD 等)与注意力重分配(PAI、SPARC、MiddleLayer 等)两类,但认为这些方法要么需要额外计算,要么改善精度时牺牲召回——原文在 PR 分析里指出其他方法 “can improve precision, they often result in significant recall degradation—sometimes even falling below the baseline at comparable precision levels”。此外,识别 sink token 的传统指标是注意力列和,计算它 “requires multiple decoding steps and backtracking, which is computationally inefficient”。
- 本文的关键观察/假设(三点):Obs1——真值物体(GT-InCap / GT-OutCap)logit 均值单调下降、方差趋稳,而幻觉物体 logit 均值上升、方差略增,即幻觉候选在隐表示层面不断积累不稳定性;Obs2——注意力行熵高的 token 其隐状态近似历史平均值、位于表示的中心流形,因而在后续步骤吸引过度注意力,形成 attention sink;Obs3——幻觉物体的 logit 排名与行熵呈弱正相关(真值物体相反),说明”注意力越均匀 → 幻觉分数被系统性抬高”。
- 由此得到的因果判断:论文把 “variance propagation via sink tokens” 认定为物体幻觉的根因,并据此把问题重述为”维持真值物体的主导信号 + 抑制 sink token 带来的随机扰动”。
4. 研究方法
- 总体流程:不改模型参数、不改结构,只在解码过程中对指定层的 KV-Cache 做逐 token 的自适应 EMA 平滑;系数由该 token 的注意力行熵在最近窗口内的分位排名决定。
- 模块 A:EMA Smoothing on KV-Cache(Sec. 4.1):假设 h_t = h _ {t−1} + ε_t, ε_t ~ N(0, σ²_p),则转移先验 P(h_t|h _ {t−1}) 为高斯;对 log P(o_t|h_t) + log P(h_t|h _ {t−1}) 做 MAP,解得 ĥ_t = σ²_p/(σ²_p+σ²_o)·o_t + σ²_o/(σ²_p+σ²_o)·h _ {t−1},令 λ_t = σ²_o/(σ²_p+σ²_o) 即得 EMA 形式。作者进一步用”两个独立高斯之积仍为高斯”论证:与其平滑隐状态本身,不如同时平滑缓存中的 K_t 与 V_t,抑制 logit 均值与方差的效果最强。
- 模块 B:Entropy-Guided Coefficient Adaptation(Sec. 4.2):行熵定义为 z^l_t = −(1/H)Σ_h Σ_j α^{(l,h)} _ {t,j} log(α^{(l,h)} _ {t,j}+ε)(式 5),作为 sink 强度的实时代理。维护长度为 M 的 FIFO 队列 S^l 保存最近 token 的行熵,取当前 z^l_t 在队列中的百分位排名 k,得到 λ̂^l_t = k/M,再截断为 λ̃^l_t = max(λref−0.2, min(λref+0.2, λ̂^l_t))(式 13–14)——作者说明这是为了在保留当前状态自身性质的同时抑制高熵 sink token。
- 最终形式(式 15):K̂^l_t = (1−λ̃^l_t)K^l_t + λ̃^l_t K^l_t−1,V̂^l_t = (1−λ̃^l_t)V^l_t + λ̃^l_t V^l_t−1,只在选定的目标层集合上执行;全程免训练、免额外模型,直接插入注意力前向(见 Algorithm 1 与 Algorithm 2)。
- 实现细节:对三个模型都取 7B 版本;EMA 施加在 3–31 层;FIFO 队列长度固定为 15;λref 分别设为 LLaVA-1.5 0.9、MiniGPT-4 0.5、InstructBLIP 0.7;全部使用 greedy decoding,最多生成 512 token。
5. 实验结果
- 基座模型:LLaVA-1.5、MiniGPT-4、InstructBLIP(论文写明 “All models adopt their 7B versions”)。
- 数据集与基准:CHAIR(caption 幻觉)、OPOPE(物体存在性验证)、AMBER(多场景综合评估)、Object HalBench(用 GPT 辅助抽取物体)。
- 关键结果:
- CHAIR(LLaVA-1.5):CHAIR_S 41.8 → 18.2(相对下降约 56%),F1 77.5 → 79.2;MiniGPT-4 CHAIR_S 31.8 → 17.0、F1 69.9 → 71.7;InstructBLIP CHAIR_S 61.4 → 42.2、F1 71.6 → 75.1。对比中 MiddleLayer 在 LLaVA-1.5 上 CHAIR_S 为 17.8 但 F1 只有 75.9,而 SPARC 为 45.6/78.9。
- OPOPE:精度与 Fβ=0.2 三个模型全面上升(LLaVA-1.5 Precision 86.17 → 91.20、Fβ=0.2 85.03 → 88.90;MiniGPT-4 87.43 → 90.74、83.94 → 86.59;InstructBLIP 83.26 → 85.19、82.06 → 83.69),但 LLaVA-1.5 的 Accuracy 由 76.75 略降到 74.60(论文只强调”highest average Accuracy and Fβ=0.2”)。
- AMBER / Object HalBench(LLaVA-1.5):AMBER CHAIR 6.1 → 3.1、Hal 27.3 → 18.7、Cog 2.8 → 1.3,Cover 50.6 → 50.8 略有提升;Object HalBench 的 CHAIR_SR 由 45.3 降到 16.7(论文给出的相对降幅为 LLaVA-1.5 63.1%、MiniGPT-4 40.3%、InstructBLIP 41.6%)。
- 消融(Table 4,LLaVA-1.5 / CHAIR):只平滑注意力输出 o_t 为 CHAIR_S 33.8/F1 74.7,只平滑 Key 为 35.6/79.4,同时平滑 Key 与 Value 为 18.2/79.2;模块消融上固定系数(Ours w/o Ada.)为 36.2/79.2,自适应系数为 18.2/79.2。
- 效率(Table 5,LLaVA-1.5 / CHAIR):本方法 3.61 s/caption、峰值显存 14625.06 MB、34.33 ms/token、29.18 token/s,基线为 3.36 / 14629.21 / 31.24 / 32.06,而 OPERA 为 34.62 s/caption、313.78 ms/token、3.43 token/s。
- 对比方法:VCD、OPERA、PAI、SPARC、MiddleLayer(论文称这五个是 representative training-free approaches)。
6. 论文结论
- 作者自述贡献:① 提出 sink degree 概念——用注意力行熵定义、可连续实时识别易致幻觉的 token;② 提出 KVSmooth,一种轻量、免训练、按 sink degree 自适应调整平滑强度的 KV-Cache EMA 平滑方法;③ 在多基准、多 MLLM 上验证了有效性与通用性。
- 局限与未来工作:论文未设 Limitation 或 Future Work 章节(正文与附录均未见相关小节)。可核对的代价是:平滑强度越大越降幻觉,但对极早层(0–2)或最后一层(32)施加 EMA 会造成 F1 明显下降,因此层范围与 λref 需要按模型调参(λref 在三个模型上分别是 0.9/0.5/0.7);作者未给出自动选参方案。
[21] CVPR2026 — Locate-then-Sparsify: Attribution Guided Sparse Strategy for Visual Hallucination Mitigation
- 会议:CVPR 2026(arXiv 录用说明:Accepted by CVPR 2026)
- arXiv:2603.16284 — https://arxiv.org/abs/2603.16284
- 本地 PDF:
CVPR2026-Locate-then-Sparsify Attribution Guided Sparse Strategy for Visual Hallucination Mitigation.pdf - 一句话定位:先因果归因定位”致幻觉层”,再按层分配特征干预强度,替代全层均匀 steering。
1. 中文摘要
本文针对 LVLM 的特征干预(feature steering)类幻觉缓解方法提出改进:现有方法对所有层施加统一强度的 steering,忽视层间差异,因而会破坏与幻觉无关的层、拉低泛化能力。作者提出 LTS-FS(Locate-Then-Sparsify for Feature Steering),一个即插即用框架,按每层的”幻觉相关性”控制干预强度。流程分三步:先用 CHAIR、POPE、Antidote 构造一个双层粒度幻觉数据集(100 条 sentence-level + 100 条 token-level 样本);再用因果干预做归因——把第 l 层多头注意力的第 h 个头输出置零,度量幻觉 token 对数概率的变化量,得到 token 级归因分数 s_tok^l,并用提示词 cue、位置、幻觉三项指标加权聚合出 sentence 级分数 s_sent^l;最后做层间稀疏化:以 τ = rs·mean(s^l) 为阈值屏蔽低分层的干预,并把高分层的 steering 强度按归一化归因分数缩放,λ_l = λ·m_l + λ·s̃^l,因此可无缝套在 Nullu、VTI 等已有 steering 方法上。在 CHAIR、POPE、MME、LLaVA-Bench 上,LTS-FS 同时改善幻觉指标与通用能力。
2. 方法图
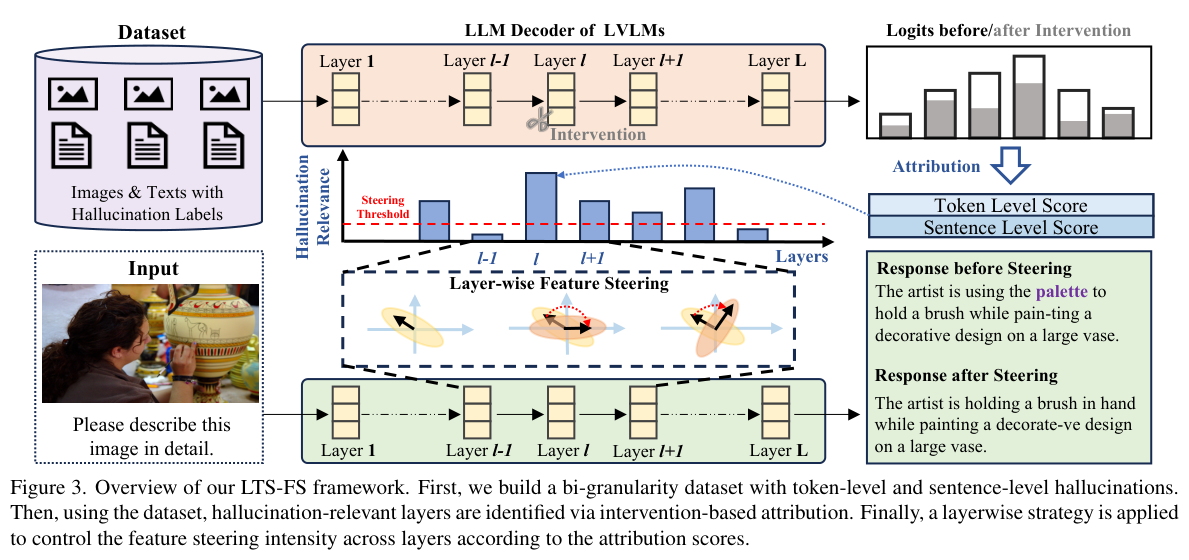
3. 研究动机
- 现有做法的缺陷:微调式方法”is costly and leads to degradation of generalization ability”;解码式方法(对比解码、自纠正)”require many more decoding steps for each input query, leading to high inference costs”。特征干预方法虽然不增加解码步数,但现方法只按启发式规则统一调整所有层(如 Nullu 对所有层施加同一强度),作者指出这些规则 “overlook the inherent differences across layers in pre-trained models, making the steering process work on layers less relevant to hallucinations”,结果是特征分布被改变(Fig. 1a 的 t-SNE 可视化)、泛化能力受损(Fig. 1b 的 CHAIR/MMMU 表现)。
- 本文的关键观察/假设:不同层对幻觉输出的因果贡献差异很大,因此”在哪一层干预”和”干预多强”应当由数据驱动地决定,而不是人为设定。作者进一步按输出长度区分两类幻觉:短回答里幻觉只出现在个别 token(token-level),长回答里会整句虚构(sentence-level),需要用两套粒度的样本一起做归因。
- 方法层面的假设(三项指标):借助已有幻觉模式分析,作者假设三类 token 更易触发幻觉——总结性 cue(如 “additional” 或句末句号)、句子中靠后的 token、以及本身含事实错误的 token,故给它们更高权重。
4. 研究方法
- 总体流程(三步):构造双粒度幻觉数据集 → 用因果干预归因定位幻觉相关层 → 按层稀疏化地分配特征干预强度(框架图见 Fig. 3)。
- 模块 A:Bi-granularity Dataset Construction:token 级样本来自 POPE、Antidote 这类 wh-/yes-no 问句,可用规则定位幻觉 token;sentence 级样本来自 CHAIR 风格的多句描述,按句子切分后用 CHAIR 的物体一致性判据标注”整句是否为幻觉”,再由人工专家归入两个粒度。整套归因只使用训练 split(或其中的小标定子集),不含任何评测 benchmark 样本,策略一旦确定即固定用于后续所有测试。
- 模块 B:Hallucination-Relevant Layer Localization(式 1–7):把第 l 层的 MHA 输出 a_l 的某个头按掩码 M^h 置零,度量幻觉 token y 的对数概率变化,得到 token 级归因 s_tok^l = Σ_h log[ P(y | h^{l−1}, a_l) / P(y | h^{l−1}, a_l ⊙ M^h) ];句级分数则对句内 token 做加权求和 s_sent^l = Σ _ {y_t∈T_sent} w(y_t|T_sent)·s_tok^l,权重来自三项指标的可乘形式 w̃ = (1+λcue·u)·(1+λpos·r)·(1+λhall·v) 再归一化,其中 u 为 cue 指示(总结词/句号,取 0/1)、r 为位置指示(越靠后越大,∈[0,1])、v 为幻觉指示(该 token 是否含事实错误,取 0/1)。任务简单(问答)时用 token 级分数,任务通用(captioning)时用句级分数。
- 模块 C:Layerwise Feature Steering(Algorithm 1):硬稀疏 + 软加权。① 阈值 τ = rs·(1/L)Σ_l s_l;② 掩码 m_l = 1[s_l ≥ τ];③ 屏蔽低分层 s_l ← m_l·s_l;④ 归一化 s̃_l = s_l/Σ_i s_i;⑤ 层的 steering 强度 λ_l = λ·m_l + λ·s̃_l;⑥ 调用任意特征干预函数 h̃_l = f(h_l, λ_l)。因此方法只决定”强度分配”,与具体 steering 实现解耦,可插到 Nullu 与 VTI 上。
- 超参数与训练策略:λpos = λcue = λhall = 1,rs = 0.5;不需要训练,只在推理期改特征;作者也试验了按样本归因分布自适应选 rs 的 soft gating,效果与固定 rs 相差极小,故实验统一用硬门控。
5. 实验结果
- 基座模型:LLaVA-v1.5-7B、LLaVA-v1.5-13B、Qwen-VL2.5-7B。
- 数据集与基准:CHAIR(报 CHAIR_S/CHAIR_I,并以 Recall、Sentence Length 作对照)、POPE(Random / Popular / Adversarial,报 Accuracy 与 F1)、MME(10 项感知 + 4 项认知)、LLaVA-Bench(用 GPT-4V 做辅助评测,报 Accuracy 与 Detailedness);归因数据集由 CHAIR(句级 100 条)与 POPE+Antidote(token 级 100 条)构成。
- 关键结果:
- CHAIR(LLaVA-v1.5-7B,MSCOCO):Regular 为 C_S 53.0 / C_I 13.9,VTI 为 47.4/13.9,Nullu 为 50.2/13.7;接上框架后 LTS-FS(VTI) 降到 35.8/11.9,LTS-FS(Nullu) 为 46.8/13.5。13B 上由 40.8/9.5(Regular)降到 32.0/8.8(LTS-FS(VTI));Qwen-VL2.5-7B 上由 27.0/7.4 降到 23.8/6.0(LTS-FS(Nullu))。
- POPE:LLaVA-v1.5-13B 的 Random 准确率由 81.91% 提升到 86.59%、Adversarial 由 71.07% 到 73.78%(均为 LTS-FS(VTI));LLaVA-v1.5-7B Popular 由 77.52% 到 80.09%、Adversarial 由 70.13% 到 73.04%;Qwen-VL2.5-7B Popular 由 83.31% 到 83.59%、Adversarial 由 80.17% 到 81.11%。F1 同样全面上升(如 7B Popular 80.71 → 82.25,13B Random 83.85 → 87.48)。
- LLaVA-Bench(GPT-4V 辅助评测,LLaVA-1.5):Original 的 Accuracy 5.74 / Detailedness 5.23,Nullu 为 6.46/5.51,LTS-FS(Nullu) 为 6.96/6.23;Qwen-vl2.5 上由 6.06/5.54 提升到 6.59/6.07。(引言另称 “increasing detailness from 4.72 to 4.92 under GPT4v-Aided Evaluation on LLaVA-Bench”,与 Table 6 的数值不一致,见”不确定之处”。)
- 消融(LLaVA-v1.5-7B,以 Nullu 为基础):只用 token 级样本归因为 C_S 50.0/C_I 13.4、POPE acc 79.59/F1 81.85;只用句级为 47.3/13.0、79.33/81.58;两者合用(完整框架)为 46.8/13.5、79.92/82.02(Nullu 基线 50.2/13.7、79.11/81.37)。阈值 rs 消融:rs=0.0(即 Regular)53.0/13.9,rs=0.3 为 49.5/14.2,rs=0.5 为 46.8/13.5(默认),rs=0.7 为 47.6/13.0,rs=0.9 为 49.1/13.3,soft gating 为 46.7/13.4。
- MME:作者报告 LTS-FS 在全部感知类任务上均有提升,而 Nullu 只在 OCR、Posters 等任务上提升明显、在 Count 等任务几乎无增益。
- 对比方法:VCD、AGLA、Nullu、VTI(其中 Nullu 与 VTI 是被集成的两种特征干预基座方法)。
6. 论文结论
- 作者自述贡献:① 把幻觉按粒度分类并构造数据集,将模型组件与 token 级/句级幻觉关联起来;② 用基于干预(intervention-based)的归因方法定位幻觉相关层;③ 提出层间稀疏策略,选择性调整特征干预强度,在更好的幻觉缓解效果下保持泛化能力。
- 局限与未来工作(原文 Limitation 小节):因已有特征干预技术尚未在 70B 规模模型上评估过,作者自述把本方法扩展到 70B 模型仍是挑战(”extending our method to 70B models remains a challenge”);未来工作有两项——研究 LTS-FS 定位出的幻觉相关层究竟呈现什么特性,以及把该框架接入模型预训练过程,从更根本上减少幻觉生成。
[22] CVPR2026 — Mitigating Multimodal Hallucinations via Gradient-based Self-Reflection
- 会议:CVPR 2026(arXiv 录用说明:CVPR 2026)
- arXiv:2509.03113 — https://arxiv.org/abs/2509.03113
- 本地 PDF:
CVPR2026-Mitigating Multimodal Hallucinations via Gradient-based Self-Reflection.pdf - 一句话定位:用一阶泰勒梯度量化每个视觉/文本 token 的影响力,据此约束解码以同时压制两种偏置。
1. 中文摘要
本文把 MLLM 的幻觉归因于两种偏置:文本–视觉偏置(过度依赖 prompt 与已生成文本、忽视视觉)与共现偏置(训练数据中频繁共现物体之间的伪相关)。作者提出 GACD(Gradient-based Influence-Aware Constrained Decoding),一个推理期方法,不需要辅助模型也不需要微调。核心是”偏置估计”:对第 m 步 logits 做一阶泰勒展开,得到对每个视觉 token、prompt token 与前序输出 token 的 Jacobian,并用其曼哈顿范数 ∥g∥₁ 作为该 token 的影响力,再按组求和得到 I^v_m、I^p_m、I^y_m,从而在样本级别量化”这一步有多依赖文本、有多依赖视觉”。基于此,GACD 有两个组件:① Object-aware Visual Token Grouping——用 spaCy 从 y_<m 中抽名词,把每个名词链接到对其 logit 影响最大的视觉 token,构成物体掩码 M_m,把视觉 token 分成物体相关 t^o 与无关 t^u(只在对名词的预测步启用);② Anchor-specific Influence-weighted Decoding——把对比解码写成 ẑ_m = (1+α_m)z*m − α_m z^o_m,其中 z^o_m 由 {t^o, t^p, y<m} 产生,再解析地求解 α_m 使 t^u 的影响力对齐到主导文本模态 max(I^p_m, I^y_m),从而放大与已提物体无关的视觉证据、抑制共现伪线索。另设基于视觉影响力占比 r^v_m 的样本自适应早停,抑制长序列的视觉遗忘。
2. 方法图
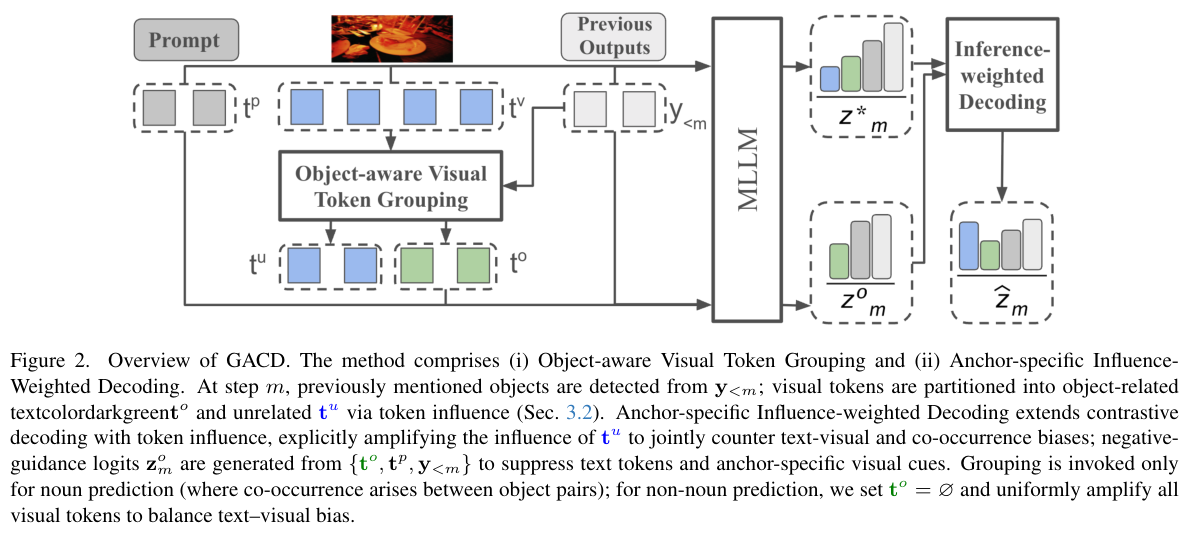
3. 研究动机
- 现有做法的缺陷:推理期方法虽然便宜,但 “offer limited insight into the severity of underlying biases, leaving the root causes of hallucination insufficiently understood”;一部分方法还要依赖分割网络、检测器甚至另一个 MLLM 作辅助模型,”which introduce extra sources of error”。更关键的是粒度问题:多数方法用启发式调出的先验,”vary across datasets and fail to generalize reliably”,并且 “apply uniform weighting across all visual features, offering no mechanism to selectively adjust bias at the level of individual features”——这对由”不同物体对应不同视觉特征”引起的共现幻觉尤其无效。
- 本文的关键观察/假设:幻觉可以分解为两种可测量的偏置。文本–视觉偏置在长序列里越来越重(”as output length grows”,模型越来越依赖先验文本、越来越无视视觉线索);共现偏置来自训练数据里的伪统计相关,典型现象是”看到 chair 就报出 dining table”。作者的关键主张是:这两种偏置都可以用样本级、token 级的梯度敏感度来度量,而无需改变模型参数——“such behavior can be probed without changing θ⋆ via parameter-dependent analyses”,从而支持”self-reflective”式的缓解。
- 实证支撑:作者用 r^v_m 统计发现除 InternVL2 外,LLaVA-v1.5、InstructBLIP、mPLUG-Owl2 都更依赖文本 prompt 而非视觉输入(Fig. 3a、Fig. 4);在 100 张只有 chair 与 100 张只有 table 的 MSCOCO 图上,另一物体被幻觉出来的比例为 23.5%,其中 31.9% 的案例里两个预测共享同一个”最有影响力的视觉 token”(Fig. 5),为共现幻觉的 token 级机制提供了直接证据。
4. 研究方法
- 模块 0:Gradient-Based Token Influence Estimation(Sec. 3.2):在参考点对第 m 步 logits 做一阶泰勒展开 z*_m ≈ Σ_s g^v_ms t^v_s + Σ_n g^p_mn t^p_n + Σ_i g^y_mi y_i + Const,其中 g^v_ms = ∂z*_m/∂t^v_s 等为 token 级 Jacobian;用曼哈顿范数作为影响力 I^v_ms = ∥g^v_ms∥₁(同理 I^p_mn、I^y_mi),并按组聚合 I^v_m = Σ_s I^v_ms、I^p_m、I^y_m,给出”视觉 / prompt / 前序输出”三路贡献的样本级分解。
- 模块 A:Object-aware Visual Token Grouping(式 8–10):对每个已生成名词 y_i,选出对其影响力最大的视觉 token 构成 M_is,累积物体掩码 M_ms = 1[Σ _ {i<m} M_is > 0];再用 Hadamard 积划分 t^o = t^v ⊙ M_m 与 t^u = t^v ⊙ (1−M_m),对应影响力 I^o_m、I^u_m。该分组只在预测名词时启用(共现幻觉发生在物体对之间),非名词步令 t^o = ∅、统一放大所有视觉 token 以对抗文本–视觉偏置。
- 模块 B:Anchor-specific Influence-weighted Decoding(式 11–13):令 z^o_m = π(t^o, t^p, y_<m) 为 anchor-specific 负向 logits,修正为 ẑ_m = (1+α_m)z*_m − α_m z^o_m。作者论证沿 z*_m − z^o_m 方向增大会提高 KL(σ(z*_m)∥σ(z^o_m)),等价于强调只出现在原始分支里的 t^u。α_m 由”让 t^u 的影响力对齐主导文本层级 I^t_m := max(I^p_m, I^y_m)”解析求出:α_m = (I^t_m − I^v_m)/(I^v_m − Ĩ^o_m + Ĩ^t_m − I^t_m);为保证物体相关视觉与 prompt 的影响力非负,还有上界约束 0 ≤ α_m ≤ min(I^o_m/(Ĩ^o_m−I^o_m), I^p_m/(Ĩ^p_m−I^p_m))。与依赖置信度阈值、需要调参的自适应合理性约束(VCD/M3ID 等)不同,这里的约束是影响力层面的显式条件。
- 模块 C:Sample-dependent Early Stopping(式 14):定义视觉影响力占比 r^v_m = I^v_m/(I^v_m+I^p_m+I^y_m);当 y _ {m−1} = EOS 之后的一个 token 的 r^v_m 低于阈值 ε 时提前停止,避免在视觉扎根极弱时继续生成。
- 实现细节:最大输出长度 256;梯度用 torch.autograd.grad 直接对输入 token 求取;名词用 spaCy 的 en_core_web_sm 抽取;α_m 上限在判别任务取 5、生成任务取 3;早停阈值 ε 为 LLaVA-v1.5/v1.6 7%、InstructBLIP 25%、mPLUG-Owl2 2.5%、InternVL2 10%;单张 NVIDIA A40、batch size 1、默认 greedy 采样。全程免训练、免额外模型。
5. 实验结果
- 基座模型:LLaVA-v1.5、InstructBLIP、mPLUG-Owl2、LLaVA-v1.6、Qwen2-VL、InternVL2。
- 数据集与基准:生成任务用 AMBER、MSCOCO(按 CHAIR 指标:C_S、C_I、Recall、Len,以及 cog 共现幻觉与 AMBER 的 overall Score)、LLaVA-QA90(用 GPT-4V 打 Accuracy 与 Detailedness,10 分制);判别任务用 AMBER(判别 VQA)与 POPE(存在性 VQA,报 Accuracy 与 F1)。附录另报 MMBench、MM-Vet、ScienceQA、VizWiz、MME 等。
- 关键结果:
- AMBER(LLaVA-v1.5):CHAIR 由 7.8 → 5.6,hal 36.4 → 24.3,cog 4.2 → 1.8,判别准确率 72.0 → 80.3,F1 74.7 → 86.0,overall Score 83.5 → 90.2(论文表述为 “up to 8% increase in overall score on AMBER”)。InstructBLIP 上 Score 86.5 → 88.1,mPLUG-Owl2 上 84.0 → 89.6。
- MSCOCO CHAIR:LLaVA-v1.5 的 C_S 48.8 → 41.0、C_I 13.4 → 10.9(VCD 为 44.8/12.8,M3ID 44.5/12.1,AVISC 46.4/13.4);InstructBLIP 57.8 → 47.4、mPLUG-Owl2 59.2 → 45.0。作者总结说句级幻觉最多降 33%、实例级最多降 32%、cog 最多降 57%,而 Recall 平均只掉 1.1%(其他方法平均掉 3.2%)。
- POPE(MSCOCO Adversarial):mPLUG-Owl2 提升最大,Acc 72.5 → 84.2、F1 77.5 → 83.7;LLaVA-v1.5 80.9 → 83.5 / 81.6 → 82.1;InstructBLIP 79.8 → 82.5 / 81.4 → 82.1;而 InternVL2 保持 85.8/85.0 不变(作者解释其原始视觉影响力占比已超过 50%,可改进空间小)。
- LLaVA-QA90(GPT-4V 打分):LLaVA-v1.5 Acc 3.23 → 6.20(论文称 Acc 提升最高 92%)、Det 3.54 → 5.13;InstructBLIP 3.84 → 6.28;mPLUG-Owl2 4.07 → 6.69、Det 4.33 → 6.28(最高 45% 的细节度提升)。
- 组件消融(CHAIR,LLaVA-v1.5):仅 Visual Amplification(VA)为 C_S 46.4/C_I 11.6;再加 Co-occurrence Hallucination Reduction(CR)为 46.2/11.3;加上 early stopping(ES)的完整模型为 41.0/10.9(基线 48.8/13.4)。梯度算法消融:用 Integrated Gradients 为 Acc 83.4/F1 82.9、耗时 20335 ms,本方法的直接梯度为 84.2/83.7、仅 385 ms;范数选择上 L1 优于 L2 与 L∞。
- 对比方法:RLAIF-V(对齐式)、VCD、M3ID、AVISC(对比解码),POPE 表中还对比 Woodpecker。
6. 论文结论
- 作者自述贡献:① 提出基于一阶泰勒梯度的偏置估计,可在不改参数、不用辅助模型的前提下,逐 token 地理解并调整视觉特征与文本 token 对当前输出 token 的影响;② 设计两个互补模块——抑制与当前输出物体强相关的伪视觉特征(缓解共现偏置)、增强视觉特征相对文本 token 的贡献(缓解文本–视觉偏置);③ 实验显示在保持 accuracy–informativeness 平衡的同时降低幻觉并提升准确率(AMBER overall 最高 +8%、POPE F1 +8%、LLaVA-QA90 细节度最高 +45%、准确率 +92%)。
- 局限与未来工作(原文 Limitations):方法只适用于白盒 MLLM,因为需要访问梯度(”Our method is limited to white-box MLLMs, as it requires access to gradients”);效果取决于基座模型原有的视觉影响力占比以及视觉信息在该问题中的重要性——存在性问题主要靠视觉,而关系型问题需要超出视觉的推理;作为后处理技术,本方法不涉及模型训练。未来工作是把 GACD 的洞察用于指导并改进 MLLM 的训练策略,以增强视觉感知。
[23] CVPR2026 — MoD-DPO: Towards Mitigating Cross-modal Hallucinations in Omni LLMs using Modality Decoupled Preference Optimization
- 会议:CVPR 2026(arXiv 录用说明:CVPR 2026. Project Page: https://mod-dpo.github.io/)
- arXiv:2603.03192 — https://arxiv.org/abs/2603.03192
- 本地 PDF:
CVPR2026-MoD-DPO Towards Mitigating Cross-modal Hallucinations in Omni LLMs using Modality Decoupled Preference Optimization.pdf - 一句话定位:在全模态(音+视+语言)偏好优化里加”模态解耦”正则与语言先验惩罚,抑制跨模态幻觉。
1. 中文摘要
本文面向全模态(omni)大模型——同时处理音频 a、视频/视觉 v 与语言文本 x 的模型——提出 MoD-DPO(Modality-Decoupled Direct Preference Optimization),用于缓解”跨模态幻觉”:既包括由音频诱发的、不存在的视觉事件(audio-driven video hallucination),也包括由画面诱发的、不存在的听觉内容(video-driven audio hallucination),其根源被作者归结为模态间的伪相关与语言先验主导。方法在 DPO 的响应偏好项与参考模型正则项之外,额外引入两个 KL 正则:对与 prompt 无关模态的扰动(如损坏音频 a′)保持不变性(invariance),对与 prompt 相关模态的扰动(如损坏视频 v′)产生敏感性(sensitivity),即 max E[r(a,v,x,y)] − βD_KL(π_θ‖π_ref) − β_inv D_KL(π_θ(·|a,v,x)‖π_θ(·|a′,v,x)) + β_sens D_KL(π_θ(·|a,v,x)‖π_θ(·|a,v′,x)),并用拉格朗日法给出闭式最优策略与对应奖励,再代入 Bradley-Terry 模型得到损失 L_MoD = L^v_MoD + L^a_MoD。为压制”只看文本也能答对”的捷径,又加语言先验去偏惩罚 r_LPD = −log π_text(y|x),得到 MoD-DPO++。配套数据由三阶段自动生成(音视频分别描述 → GPT-4o 造 QA → 用”无关模态信息”造难负例),共 18,112 条偏好样本、覆盖 10,854 个视频。在 Qwen 2.5 Omni 与 MiniCPM-O 2.6 上,AVHBench 与 CMM 的准确率与抗幻觉指标一致提升。
2. 方法图
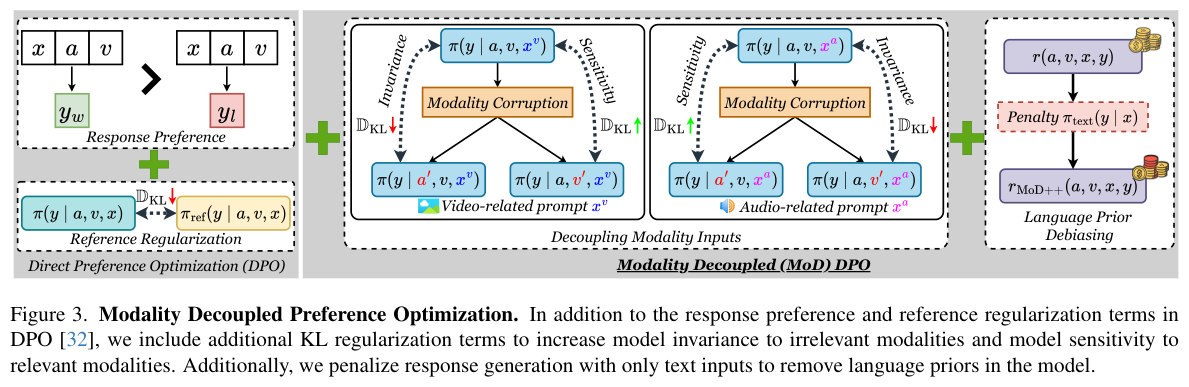
(另一张可作补充的是第 4 页 Figure 4 的偏好数据生成 pipeline(Stage 1 音视频解耦描述 → Stage 2 QA 生成 → Stage 3 偏好对生成),我已用 read_image 一并查看;若读者关心数据构造,建议对照该图。)
3. 研究动机
- 现有做法的缺陷:作者指出已有工作”neither decouple modality pathways during optimization nor penalize latent language-only shortcuts explicitly”——即虽有用偏好学习做多模态对齐的尝试(如 OmniDPO、mDPO、V-DPO),但既不在优化时解耦模态通路,也不显式惩罚”只靠语言”的捷径;而 VCD 及其音视频扩展这类解码期防御虽然免训练,却”operate post hoc and do not change the model’s internal decision boundaries”。
- 本文的关键观察/假设:全模态模型在音视频证据”subtle, asynchronous, or weakly correlated”时最容易出错,作者沿用既有分析把失败原因归为两点:(i) 对单模态先验(尤其是语言)的过度依赖,(ii) 预训练与对齐过程中学到的模态间伪相关。据此提出两条可优化的期望性质:对无关模态的扰动保持不变、对相关模态的扰动必须敏感。
- 一条反直觉的实证发现:作者发现”跨模态信息有时是有益的”,例如画面里的狗可以由音频中的吠声佐证,因此设计上刻意令 β_inv < β_sens(原文:”we set βinv lower than βsens, as cross-modal information is sometimes beneficial even if the prompts are specific to a particular modality”),避免把有益协同一起压掉;同理,直接在训练中加入联合音视频(AV)任务目标带来的增益并不显著。
4. 研究方法
- 总体流程:把 DPO 的目标从”文本条件”推广到”音视频条件”(式 4:max E[r(a,v,x,y)] − βD_KL(π_θ(·|a,v,x)‖π_ref)),再在其上加两类与模态相关的 KL 正则,最后叠加语言先验去偏惩罚,得到 MoD-DPO++;训练数据完全自动生成。
- 模块 A:Decoupling Modality Inputs(式 5–9):以视觉相关 prompt x_v 为例,目标为 max E[r] − βD_KL(π_θ‖π_ref) − β_inv D_KL(π_θ(·|a,v,x_v)‖π_θ(·|a′,v,x_v)) + β_sens D_KL(π_θ(·|a,v,x_v)‖π_θ(·|a,v′,x_v)):第一项 KL 要求”无关模态(音频)被损坏时输出分布不变”,第二项要求”相关模态(视觉)被损坏时分布发生偏移”。用拉格朗日乘子求得闭式最优策略 π*_θ ∝ exp(r/τ)·π_ref^{β/τ}·π′_θ(a′,v)^{β_inv/τ}·π′_θ(a,v′)^{−β_sens/τ}(τ = β+β_inv+β_sens),进而导出奖励 r_MoD(式 7)与损失 L^v_MoD(式 8),最终 L_MoD = L^v_MoD + L^a_MoD。音频相关 prompt x_a 有对称形式。
- 模块 B:Language-Prior Debiasing(式 10–12):惩罚 r_LPD(x_v,y) = −log π_text(y|x_v),其中 π_text 是”只吃文本输入”的冻结语言模型,理论上可以是任意强语言模型,出于效率直接取 π_ref;总奖励为 r_MoD++ = r_MoD + γ_LPD·r_LPD,最终目标 L_MoD++ = L_MoD − γ_LPD log[π_ref(y_w|x)/π_ref(y_l|x)],直接压低”仅凭文本输入时的 chosen 响应”的 log 概率。
- 模块 C:Preference Data Generation(Fig. 4,三阶段):Stage 1 解耦标注——视频用 GPT-4o 生成详细视觉 caption、RAM++ 生成视觉 tag,音频用 AudioFlamingo 3 生成音频 caption,原始音视频来自 MSR-VTT、VALOR32K(val)、AudioCaps(val),并且”in most cases”用不同文件拼接出不匹配(mismatched)的音视频上下文;Stage 2 用 GPT-4o 生成两类 QA——音/视 captioning 与音/视物体-事件存在性判断(数据构成为 Presence 54.4%、Captioning 45.6%);Stage 3 生成难负例:对视觉相关问题,用音频模态的信息构造 rejected 响应(反之亦然),而不是用完全无关的回答。共 18,112 条偏好样本、10,854 个独特视频。
- 训练/推理策略与实现要点:① 对损坏输入 a′/v′ 的前向做 stop-gradient,使 π′_θ 在一个迭代内保持固定目标分布;② 训练时在视觉相关与音频相关 prompt 之间交替批次而非混合批次;③ β_inv 取得比 β_sens 小;④ 只用”强绑定单一模态”的 query 做 DPO,联合音视频目标(L^{av}_MoD)增益不显著故未采用。实现基于 LLaMAFactory,两个参考模型为 Qwen 2.5 Omni(7B)与 MiniCPM-O 2.6(8B),学习率 3e-7、1 个 epoch、每卡 batch size 1、8 张 H100;超参 β = 0.1、β_sens = 0.05、β_inv = 0.02、γ_LPD = 0.05。由于额外前向(损坏输入与纯文本前向)都不需要梯度,作者让 MoD-DPO++ 只训练 1/4 的 epoch 以对齐基线训练预算(基线训练 4 个 epoch)。
5. 实验结果
- 基座模型(全模态参考模型):Qwen 2.5 Omni(7B params)、MiniCPM-O 2.6(8B params)。对比的其它全模态模型包括 VideoLLaMA 2、VITA-1.5、OmniVinci、Qwen 3 Omni;偏好优化基线为 DPO 与 OmniDPO。
- 数据集与基准:跨模态幻觉用 AVHBench(约 5k 样本 / 2k 视频,含 Audio-driven Video Hallucination、Video-driven Audio Hallucination、Audiovisual Matching 三类,报 Acc/Pre/Rec/F1)与 CMM(Curse of Multi-Modalities,2.4k 样本 / 1.2k 视频,含 Spurious Inter-modality Correlation 的 VL/AL/VAL 与 Uni-modality Over-reliance 的 Visual/Audio/Lang. Dom.,报 perception accuracy (pa) 与 hallucination resistance (hr));通用能力用 DailyOmni(联合音视频)、MVBench(视觉)、MMAU(音频),附录另报 OmniDialog 多轮对话。偏好数据源为 MSR-VTT、VALOR32K(val)、AudioCaps(val)。
- 关键结果:
- AVHBench(Qwen 2.5 Omni):Audio-driven Video Hallucination 准确率 84.15 → 88.19(MoD-DPO 87.66),F1 83.51 → 88.15;Video-driven Audio Hallucination 准确率 77.38 → 83.40(MoD-DPO 82.48);Audiovisual Matching 提升最猛,准确率 54.69 → 69.68、F1 17.85 → 59.71,论文表述为 “gains of up to 27% accuracy relative to the reference models on the audiovisual matching task”。MiniCPM-O 2.6 上三类任务同样提升(如 matching 准确率 54.26 → 60.66,ADVH 83.36 → 87.26)。
- CMM:Qwen 2.5 Omni 整体 pa 86.4 → 89.2、hr 84.6 → 87.2(MoD-DPO 为 88.8/86.2),论文称相较参考模型有”around 3-4 % overall performance gain”;MiniCPM-O 2.6 为 85.6/80.4 → 88.3/83.6。语言主导(Lang. Dom.)子任务上 MoD-DPO++ 相对 MoD-DPO 的增益明显更大(Qwen 2.5 Omni: 73.9/83.1 → 74.9/83.8,pa/hr),说明 LPD 在压语言先验上有效。
- 组件消融(Table 3,Qwen 2.5 Omni,MoD-DPO++):三组件全关为 AVHBench Acc 72.07、CMM pa/hr 86.4/84.6;只开 Sensitivity 77.02;只开 Invariance 76.04;只开 LPD 73.88(hr 升到 86.3);Sensitivity+Invariance 79.74(88.8/86.2);三者全开 80.42/74.50/86.34(89.2/87.2)。作者总结 LPD 显著提升 recall 与 hallucination resistance。
- 负例与损坏方式消融(Table 4):rejected 响应取”与 prompt 相反模态”的信息(Rel. Opp.)为 80.42/89.2/87.2,而取完全无关响应(Irrelevant)只有 77.91/88.1/85.4;损坏输入用 diffusion 加噪 500 步最好(80.42/89.2/87.2),全零最差(77.03/87.0/86.1),高斯随机噪声 79.93、随机音视频 79.03,diffusion 只用 10 步反而差(72.72,因为损坏太轻微、扰动不了 KL)。
- 数据构成消融(Table 6):只用匹配音视频上下文为 76.69/87.6/85.8,只用不匹配为 78.24/88.2/86.1,两者混用最好(80.42/89.2/87.2);再加入联合音视频任务无进一步增益(80.33/89.0/87.5)。
- 通用能力(Table 5):Qwen 2.5 Omni 的 DailyOmni 平均 47.34 → 53.82、MVBench 69.61 → 71.02、MMAU 平均 64.62 → 66.33;MiniCPM-O 2.6 为 30.55 → 36.60、62.56 → 64.32、66.75 → 68.30。OmniDialog 多轮对话上 MoD-DPO++ 为 85.86,高于基线 83.91 与 OmniDPO 84.18。
- 机制验证:Fig. 6 显示 MoD-DPO++ 显著提高模型分配给音视频 token 的注意力占比(占总输入注意力的百分比上升);Fig. 7 用核密度估计给出 AVHBench 上正确回答的 log-likelihood 位移——相关模态被损坏时 MoD-DPO++ 的位移更大(Shift −1.50 → −2.48,体现 sensitivity),无关模态被损坏时位移更小(Shift −1.09 → −0.25,体现 invariance)。
- 对比方法:偏好优化基线 DPO、OmniDPO;全模态模型 VideoLLaMA 2、VITA-1.5、OmniVinci、Qwen 3 Omni、Qwen 2.5 Omni、MiniCPM-O 2.6;附录还对比了解码期方法(Supp. D.2)。
6. 论文结论
- 作者自述贡献:① 提出 MoD-DPO,用”对无关模态不变、对相关模态敏感”的模态解耦偏好优化来缓解 omni LLM 的跨模态幻觉,并构造了 18.1k 条自动生成偏好样本、覆盖 10.8k 个视频的偏好数据集;② 引入语言先验去偏惩罚,进一步压低语言先验带来的幻觉;③ 在多基准上超过其它后训练方法。
- 局限与未来工作:作者在 Discussion 中明确说明 “the current framework does not explicitly promote beneficial cross-modal synergy for tasks requiring complementary audiovisual reasoning”,即本框架只压制伪相关、并不主动促进有益的跨模态协同,把”选择性促进有益跨模态交互、同时继续压制伪相关”列为未来工作。论文未设独立的 Limitation 小节;另外可核对到的代价是:MoD-DPO++ 每次迭代需要额外的损坏输入与纯文本前向,因此只用 1/4 的训练 epoch 以对齐基线预算;β_inv 或 γ_LPD 取值过大都会明显掉点(β_inv > 0.02 性能显著下降,过强的语言惩罚会连有益的语言先验一起压掉)。
[24] CVPR2026 — Prefill-Time Intervention for Mitigating Hallucination in Large Vision-Language Models
- 会议:CVPR 2026(arXiv 录用说明:Accepted by CVPR 2026)
- arXiv:2604.25642 — https://arxiv.org/abs/2604.25642
- 本地 PDF:
CVPR2026-Prefill-Time Intervention for Mitigating Hallucination in Large Vision-Language Models.pdf - 一句话定位:把干预从解码期挪到 prefill 期,一次性修正初始 KV cache 的键与值。
1. 中文摘要
本文指出解码期干预(Decoding-Time Intervention, DTI)虽然能降低幻觉频率,却会加重残余幻觉的严重程度:由于干预在解码阶段持续、被动地施加,一旦初始错误产生,误差会自回归累积,形成”雪球幻觉”(snowball hallucination)。作者把这一失效归因于 DTI 在”何时、如何、对什么”三个维度上的缺陷:只用文本状态导出的、与模态无关的统一 steering 向量;只作用于粗粒度隐状态;且只在错误已经形成后才介入。因此提出 Prefill-Time Intervention(PTI):只在 prefill 阶段介入一次,直接增强初始 KV cache。PTI 是模态感知的——Stage I 分别用对比样本抽取视觉与文本方向:视觉方向取”只含物体的图像 I⊙M_obj”与”只有背景的图像 I⊙(1−M_obj)”两次 prefill 的 KV 差分,物体/背景的最大对比被验证为最有效;文本方向取 MSCOCO caption 中锚点词(被提及物体)与非锚点词的 KV 差分,只作用于最后一个文本 token。随后对两部分分别做平均池化/索引、跨样本平均,并用 PCA(SVD)去噪。Stage II 把这些方向按模态注入下游输入初始 cache 的对应位置:K̃[I_img] += λ_k,img·S_k,img、Ṽ[I_img] += λ_v,img·S_v,img,文本侧同理;键被推向视觉扎根的物体、值被用来过滤背景噪声。方法免训练、即插即用,且与解码期方法正交。
2. 方法图
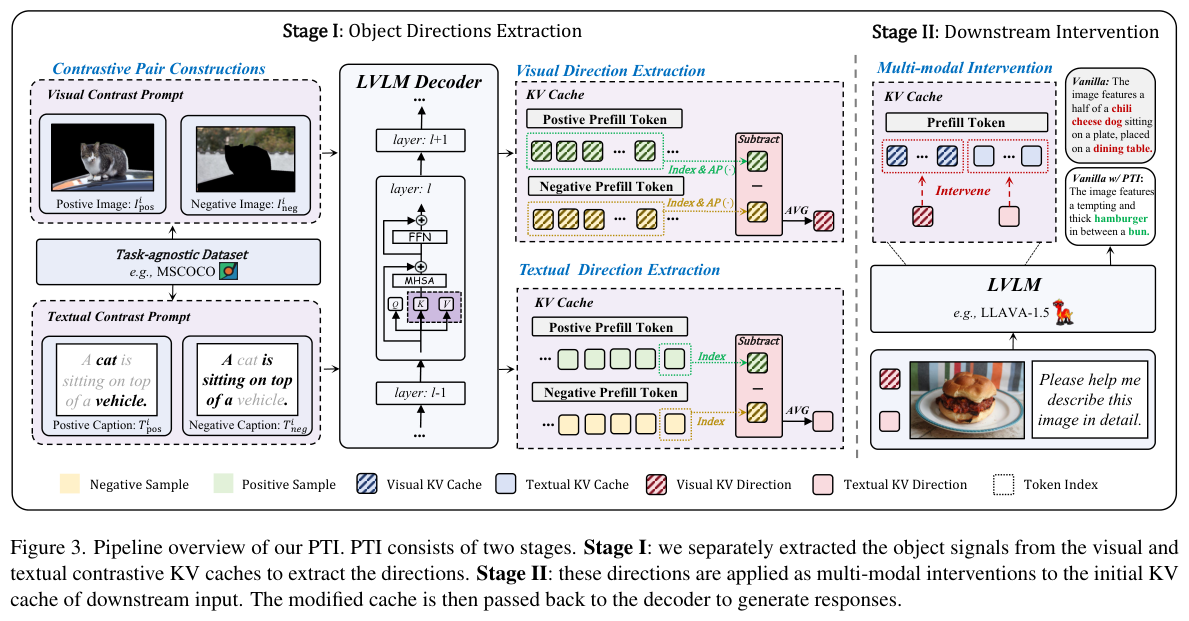
3. 研究动机
- 现有做法的缺陷:视觉对比解码类方法(VCD 等)”multi-round decoding significantly increases the inference latency”,且被指出”might discard beneficial language priors and compromise the coherence of generated content”;DTI 类方法(VISTA 等)的”key limitation is that they use a fixed steering vector across all token positions during the overall generation phase, which may exacerbate initial errors and worsen subsequent hallucinatory output”。即便是 VTI 这种额外在视觉编码器上干预的方法,”its intervention on the linguistically-dominant decoder remains undifferentiated, failing to distinguish between modalities and intervention timing”。
- 本文的关键观察/假设:作者用 CHAIR 上的 CHAIR_S/CHAIR_I 与 PSH(雪球幻觉占比 = Snowball Hallucinations / Overall Hallucinations × 100%)做定量分析,发现 DTI(VISTA)虽然把幻觉频率压下来了,却把 PSH 推高——即”一旦初始错误产生,持续的干预无法阻止其传播”。由此提出的假设是:问题不在解码阶段,而在于初始表示形成的那一刻;而初始表示在 Transformer 里就物化为 prefill 阶段的 KV cache,它不是被动存储,而是”actively shapes every subsequent decoding step”,因此是关键干预点。
- 三条设计原则:when(从被动的解码期改为主动的 prefill 期,一次介入)、how(模态感知,视觉与文本区别对待)、what(作用于细粒度的 KV cache 而非粗粒度隐状态,从而直接进入注意力机制——键决定”看哪里”、值决定”聚合什么”,天然构成解耦的控制量)。
4. 研究方法
- 总体流程(两阶段):Stage I 在任务无关数据(MSCOCO,含高质量 image-caption 与物体分割)上离线抽取”物体方向”,视觉与文本两条线独立并行;Stage II 在下游推理时把方向注入初始 KV cache,之后完全按标准解码进行。
- 模块 A:Visual Direction Extraction(式 3–4):以物体分割标签 M_obj 得到正样本 I_pos = I ⊙ M_obj(只留物体)与负样本 I_neg = I ⊙ (1 − M_obj)(只留背景);用同一固定文本 prompt 做两次 prefill 前向,得到 (K_pos,V_pos) 与 (K_neg,V_neg),在视觉 token 索引集 I_img 上取差分并平均池化 AP(·):ΔC^i,l_img = AP(C^i,l_pos − C^i,l_neg)[I_img],C ∈ {K,V};再跨 N 个样本平均得 S^l_k,img、S^l_v,img,最后用基于 SVD 的 PCA 去噪。
- 模块 B:Textual Direction Extraction(式 5–6):用 NLP 工具构造文本对比对——正样本 T_pos 为 caption 中的锚点词(被提及物体,如 “cat”、”vehicle”),负样本 T_neg 为掩掉锚点词后的其余上下文;保持图像不变做两次 prefill 前向,按前人做法只取输入序列最后一个文本 token 的索引 N_x − 1:ΔĈ^i,l_txt = (Ĉ^i,l_pos − Ĉ^i,l_neg)[N_x − 1];同样跨样本平均后做 PCA。
- 模块 C:Multi-modal Intervention(式 7–8):视觉与文本干预互相独立、与顺序无关。视觉侧 K̃^l[I_img] += λ_k,img·S^l_k,img,Ṽ^l[I_img] += λ_v,img·S^l_v,img(式 7,作用于所有视觉 token);文本侧 K̃^l[I_txt] += λ_k,txt·S^l_k,txt,Ṽ^l[I_txt] += λ_v,txt·S^l_v,txt(式 8,只作用于对应文本 token 位置,按 VISTA 的做法做归一化以保持稳定)。语义分工为:键被导向视觉扎根的物体(提高物体中心注意力),值用于过滤背景噪声。
- 训练/推理策略:完全免训练、不改参数、只改推理期的初始 cache;干预后不引入任何解码期修改,开销可忽略。方向在”holdout 训练集”上抽取——100 条随机选取的 MSCOCO VQA 样本;λ_k,img = λ_k,txt、λ_v,img = λ_v,txt,取值经 grid search 得到(详细超参见附录 B)。
5. 实验结果
- 基座模型:LLaVA-1.5、Qwen-VL-Chat、DeepSeek-VL-Chat(三种架构互不相同)。
- 数据集与基准:物体幻觉基准 CHAIR(MSCOCO 验证集随机 500 张图,prompt 为 “Please help me describe this image in detail.”,报 CHAIR_S/CHAIR_I,最大新 token 512)、POPE(Random/Popular/Adversarial 各 3000 条 VQA,报 Adversarial 与三 split 平均的 Acc/F1,nucleus sampling,最大新 token 32)、AMBER(生成任务 1,004 题、判别任务 14,216 题,报 C_I 与 Acc);综合基准 MMHal-Bench(96 组图问、8 个类别、用 GPT-5 评分)与 MME(聚焦 object-level 的 existence/count 与 attribute-level 的 position/color 等 cognition 子集)。解码策略覆盖 Greedy、Beam Search(beam size 5)、Nucleus Sampling(top-p = 1.0,temperature 固定 1.0)。
- 关键结果:
- CHAIR(Greedy,LLaVA-1.5):CHAIR_S 47.4 → 15.4、CHAIR_I 13.7 → 5.4;同设置下 PAI 为 22.8/7.0、VISTA 20.4/6.9、VTI 35.4/11.8。Qwen-VL-Chat 39.6/12.0 → 20.6/7.0,DeepSeek-VL-Chat 25.8/8.2 → 19.2/6.7。Beam Search 下 LLaVA-1.5 为 47.8/14.2 → 13.2/5.5;Nucleus Sampling 下为 50.2/16.2 → 25.8/9.2。论文强调 PTI 在三种解码策略下都稳定有效,而 VCD、OPERA 只在特定解码策略下有小幅改进。
- POPE(nucleus sampling):LLaVA-1.5 的 Adversarial Acc 75.40 → 77.40、F1 77.67 → 78.75,三 split 平均 Acc 79.88 → 82.21、F1 81.23 → 82.85;Qwen-VL-Chat Adversarial 80.26 → 83.37、平均 83.69 → 85.69;DeepSeek-VL-Chat Adversarial 82.73 → 83.77、平均 83.89 → 85.14。作者特别指出 VTI 在 Qwen-VL-Chat 上把 F1 从 82.92% 拉到 82.19%(−0.73%),VISTA 亦降 0.80%,说明”在语言主导的解码器里做模态无关干预”是有害的。
- AMBER:LLaVA-1.5 Greedy 下 C_I 6.1 → 3.8、Acc 81.5 → 82.0;Sampling 下 9.9 → 7.3、73.5 → 74.6。Qwen-VL-Chat 6.5 → 5.7、DeepSeek-VL-Chat 6.0 → 4.0(其余见 Table 3)。
- MME(greedy,总 Acc):LLaVA-1.5 611.6 → 651.6(+40.0)、Qwen-VL-Chat 598.3 → 638.3(+40.0)、DeepSeek-VL-Chat 651.6 → 671.6(+20.0);对比 VTI 分别为 +21.7/+28.3/+10.0,VISTA 在 DeepSeek 上甚至是 −5.0。
- MMHal-Bench:PTI 在平均分与幻觉率上同时优于 PAI 与 VTI,且在 COUNT、SPAT、ATTR 等需要细粒度物体细节的类别上提升最明显。
- 消融(Table 5,LLaVA-1.5,CHAIR/F1):不干预为 47.4/13.7/75.3;只做文本干预且仅末 token 为 40.8/12.0/76.5,文本干预作用于全部 token 为 45.2/14.3/75.6;只做视觉干预且仅末 token 为 41.2/12.4/76.4,视觉干预作用于全部视觉 token 为 16.8/6.2/70.3;PTI(文本末 token + 全部视觉 token)为 15.4/5.4/72.7。结论是”视觉干预对降幻觉最关键但会拉低 F1,精确的文本干预用来补回生成质量”,因此最终设计是两者的组合。
- 可解释性(Figure 5,LLaVA-1.5,300 张 MSCOCO 图):值缓存上,随机掩码的对比会显著加重幻觉,”物体 vs 背景”的最大对比取得最大的幻觉下降(论文记为 −9.7% CHAIR_I);键缓存上,干预既缓解了生成过程中对整体视觉 token 注意力的衰减,又把注意力更集中地导向物体级细节,且这种正向效果随推理推进而增强。
- 泛化性(Table 6,POPE Adversarial):跨模型迁移(LLaVA ⇐⇒ Qwen,因二者 KV cache 维度一致)在 LLaVA 上 +0.13、Qwen 上 +1.21;与其它阶段方法组合也有加成——PAI 结合 PTI 后 76.93 → 78.76(LLaVA)、81.63 → 82.30(Qwen)、84.03 → 84.60(DeepSeek),VISTA 结合 PTI 后 75.53 → 76.33、80.80 → 80.96、84.80 → 85.56,说明 PTI 与解码期方法机制正交。
- 对比方法:VCD、OPERA(优化解码策略类),PAI、VTI、VISTA(其它 decoding-time 方案)。作者说明为公平起见复现了全部基线,并剔除了缺乏官方代码实现或不支持特定解码策略的方法。
6. 论文结论
- 作者自述贡献:① 提出 PTI——一种免训练、即插即用的多模态 steering 范式,把干预从解码期移到 prefill 期;② 与既有 DTI 不同,PTI 从多模态 cache 中抽取不同模态各自的方向并解耦使用,同时增强物体中心注意力与对背景噪声的鲁棒性;③ 大量实验表明 PTI 在”如何、对什么、何时”干预这一三难问题上给出了通用且稳健的解法,且与已有解码期方法正交。
- 局限与未来工作:论文未设独立的 Limitation 或 Future Work 章节(正文与附录均未见相关小节)。可核对到的代价与前提是:① 视觉干预虽然最有效,但单独使用会明显拉低 F1(70.3 vs 基线 75.3),需要文本干预来补偿,属于权衡而非无损;② 干预强度 λ 通过 grid search 确定,方向抽取依赖 MSCOCO 的分割标注与 100 条 holdout VQA 样本;③ 跨模型迁移受限于”KV cache 维度必须一致”(作者只做了 LLaVA-1.5 与 Qwen-VL-Chat 之间的迁移)。
[25] CVPR2026 — Reallocating Attention Across Layers to Reduce Multimodal Hallucination
- 会议:CVPR 2026(arXiv 录用说明:Acceptted by CVPR2026)
- arXiv:2510.10285 — https://arxiv.org/abs/2510.10285
- 本地 PDF:
CVPR2026-Reallocating Attention Across Layers to Reduce Multimodal Hallucination.pdf - 一句话定位:免训练地识别感知头/推理头并对其输出加类条件增益,纠正跨层注意力错配。
1. 中文摘要
多模态大推理模型(MLRMs)的幻觉不只来自视觉定位不足,也来自”感知”与”推理”两类计算在层间分配失衡。作者承接”注意力随层数呈阶段性分工”的可解释性发现,把幻觉拆成两种互补失效模式:浅层的 Perceptual Bias(视觉注意力弥散、关键证据被稀释)与深层的 Reasoning Drift(注意力无法保持中间推理步骤,结论偏离前提)。据此提出 Functional Head Identification and Class-Conditioned Rescaling 这一轻量插件:先用可物化的注意力矩阵计算”模态注意力比例”,结合深度边界 ℓperc、ℓreas 与比例阈值 τperc、τreas,把注意力头划分为感知导向与推理导向两组;再只对这两组头的输出施加乘性增益 gperc、greas,其余头保持系数 1,从而在不改变注意力权重与 V 投影、不重训练、不改结构的前提下,让更有用的头成为主导头。该方法在 3 个 MLRM 与 5 个基准上平均提升 4.2 个百分点,额外计算 <1%,延迟仅为最强基线的 9%。
2. 方法图
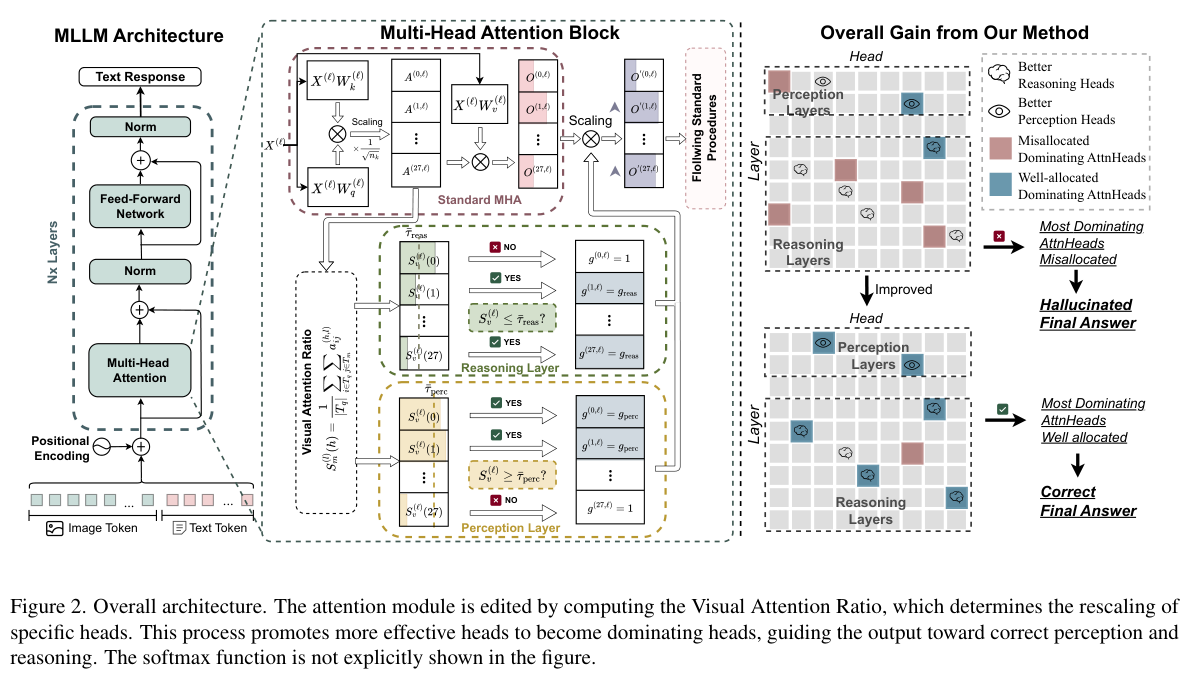
3. 研究动机
- 现有做法的缺陷:主流路线都默认”幻觉根因是视觉信息没被用够”,于是靠更强监督、更细粒度对齐或外部视觉先验去”补偿视觉”(stronger supervision / finer-grained alignment / external visual priors)。作者指出这些方法共享同一假设,忽略了模型内部跨层的分配动态。
- 本文的关键观察/假设:MLRMs 存在分阶段的注意力分工——浅层视觉注意力比例高但分散(广域扫描),中层比例仍高而集中度上升(聚焦与跨模态对齐),深层视觉比例下降、语言线索主导。因此幻觉不仅是”感知不足”,更是感知与推理的”使用错配”。
- 失败模式可量化:作者手工检查 200 个幻觉案例,发现知觉偏置约占 16%、推理漂移约占 20%、二者共现约占 10%;并给出感知偏差 E(ℓ)perc 与推理偏差 E(ℓ)reas 的定义以及总幻觉强度 I = λ1·E[Eperc] + λ2·E[Ereas],把幻觉写成跨阶段误差累积。
- 干预假设:模型内部已经存在有潜力支持感知/推理的头,只是当前不占主导地位(non-dominating),因此”识别并放大”比”新增模块”更划算。
4. 研究方法
- 总体流程:在标准 MHA 中旁路地物化注意力矩阵 A(h,ℓ),按”模态注意力比例 + 深度边界”筛出两组功能头,然后在 per-head 输出之后、输出投影 W_O 之前对这两组头乘增益,其余不变,保持最小编辑(minimal editing)原则:min_ΔΘ I(Θ+ΔΘ) 且 ‖ΔΘ‖ 尽量小。
- Functional Head Identification(功能头识别):对层 ℓ、头 h 计算 S(ℓ)m(h) = Σ _ {j∈Tm} a(h,ℓ) _ {i*j},即分配到视觉/文本 token 上的注意力质量(S_v + S_t = 1)。再用阈值分层:H(ℓ)perc = {h : ℓ ≤ ℓperc ∧ S_v(h) ≥ τperc},H(ℓ)reas = {h : ℓ ≥ ℓreas ∧ S_v(h) ≤ τreas},τreas < τperc;落在阈值之间或边界之外的头不标注、不干预。
- Class-Conditioned Rescaling(类条件重标定):g(h,ℓ) = gperc·1[h∈Hperc] + greas·1[h∈Hreas] + 1·1[其他],两个增益都 ≥1、与层无关(layer-agnostic),只做放大不做衰减。改写后的层输出为 Y(ℓ)out = Concat(g(1,ℓ)O(1,ℓ), …, g(H,ℓ)O(H,ℓ))·W(ℓ)O,替换残差通路里的标准输出,故影响会跨层累积。
- 免训练/推理期插件:实现只需改
eager_attention_forward(modeling_qwen2_5_vl.py / modeling_kimi_vl.py),权重冻结,并用缓存保存视觉 token 范围与超参;无损失函数、无训练步,纯粹是推理期干预。复杂度分析显示附加项 O(H·N²) 仍被标准注意力的 O(N²) 支配。
5. 实验结果
- 基座模型:Kimi-VL-A3B-Thinking、Ocean-R1-7B-Instruct、R1-Onevision 7B(逐字照抄论文表格中的写法)
- 数据集与基准:MathVistamini、MathVisionmini(数学推理)、HallusionBench(视觉推理)、MMStar、SEED-Bench(多模态整合)
- 关键结果:
- Ocean-R1 上 MathVisionmini 准确率 20.05 → 26.01;R1-Onevision 上 MathVisionmini 33.54 → 39.12;Kimi-VL 上 HallusionBench F1 64.97 → 68.32;论文称在近 95% 的任务上取得最优、相对 vanilla 平均提升 4.2%,最难任务上提升可达 7%。
- 消融(Table 2):R1-OneVision + MathVisionmini 上只增强单组反而 −3.91%,两组联合为 +5.58%;Kimi-VL + MMStar 上 w/o reasoning 得 +6.71%,而同样设置在 Ocean-R1 上是 −1.51%,说明不同架构对感知/推理的依赖不同、增益不可加。
- 效率(Table 4 / Figure 3):HallusionBench 200 样本上 vanilla 约 101s、本方法约 103s(+约 2s),而 VCD/CGD/AGLA 为 1.2×–6.6× 推理时间;超参默认 ℓperc=7、ℓreas=3(Ocean-R1),作者扫了 150 组边界配置(最好与最差相差 27.4%)与 24 种缩放策略(增益 1.14 附近折中最优)。
- 对比方法:VCD(视觉对比解码)、AGLA(全局+局部注意力融合)、CGD(CLIP 引导解码),均按推理期基线实现。
6. 论文结论
- 作者自述贡献:提出一个轻量可解释的插件,识别感知/推理导向的注意力头并在最小编辑原则下选择性放大;相对既有解码期或训练类方法即插即用,不需要重训练与结构改动,且不带来可察觉的推理开销。
- 局限与未来工作:论文在 Limitation 部分明确写:感知与推理的分界不是一个清晰阈值,实验显示性能峰值出现在”层带”中、最优 ℓperc/ℓreas 随任务变化,说明层角色混合、模型是从感知到推理的渐变;未来希望用更精细的可解释性研究刻画这种过渡,从一维边界走向更丰富的结构模式。作者还把”更自适应的头选择”列为方向:用深度、模态比例、一致性等多信号给每个头打分,并按输入 x 自适应决定增益集合 S(x),但要权衡方差与效率。
[26] CVPR2026 — Residual Decoding: Mitigating Hallucinations in Large Vision-Language Models via History-Aware Residual Guidance
- 会议:CVPR 2026(arXiv 录用说明:Accepted by CVPR 2026)
- arXiv:2602.01047 — https://arxiv.org/abs/2602.01047
- 本地 PDF:
CVPR2026-Residual Decoding Mitigating Hallucinations in Large Vision-Language Models via History-Aware Residual Guidance.pdf - 一句话定位:用历史时间步 logits 的 JSD 低谷区构造残差引导、单次前向修正语言先验幻觉。
1. 中文摘要
LVLM 在生成时会被语言先验牵引,产出语法通顺却与图像无关的内容,作者称之为 Language-Prior Hallucination。文章先做机制观察:正确答语的信号其实在解码答案之前就已出现在前面若干 token 的 logits 里(如 “The / answer / is” 阶段正确答案 D 的 logits 已偏高),但在生成 “:” 时幻觉 token C 的 logits 被异常抬高并反超 D,最终吐出错误答案。基于此提出训练无关的 Residual Decoding(ResDec):先用 Jensen–Shannon Divergence 在滑动窗口内刻画历史 logits 分布,发现其随时间的 U 型曲线,据此划分为 PSAP(语义未清)、SAP(语义锚定,JSD 接近 0)与 EDP(表达发散)三段;随后在 SAP+EDP 区间内按 token 级置信度 C_i = −(1/|Ω_t|)Σ log P_i(j) 对历史 logits 加权求和,得到历史残差信号,再以 (1−α)·当前 logits + α·残差 logits 融合,并用 β 做自适应可行域截断。方法只需一次前向、无需对比模型或外部编码器,在 11 个基准上超越 Regular 解码,POPE 平均提升 7.84% 准确率与 8.01% F1。
2. 方法图
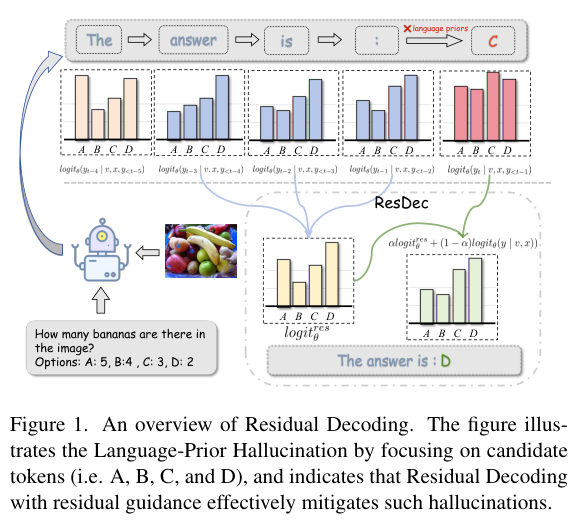
3. 研究动机
- 训练类方法的代价:数据去偏、模态对齐增强、偏好对齐等需要额外训练与昂贵标注,可扩展性受限。
- 免训练方法的两个通病:作者明确指出 (i) 对比解码一类方法需要 2× 甚至更多推理时间并带来更高显存开销;(ii) 另一类在注意力、FFN 或层级别改动模型内部组件,牺牲简洁性与通用性。
- 关键观察(论文最值钱的部分):正确答案的信号在模型”显式解码”之前就已经嵌在历史 token 的 logit 分布里;幻觉 token 是在某些时刻被异常抬高并逐渐逼近甚至超过真实 token,才导致最终错误输出。这被作者归纳为 LVLM 幻觉的本质机制。
- 现象刻画(RQ1/RQ2):随上下文逐步补全,模型对正确推理轨迹的前瞻性感知被激活(准确率上升并在待解码 token 附近达峰),但隐式表示不稳定,原因是在生成中累积了两类偏置——预训练阶段的自然语言语法偏好、指令微调阶段的对话模板偏好(如 “The answer is :”),因此必须找到”稳定的隐式表示阶段”。
- JSD 三分段的发现:在 200 条随机采样的 POPE-MSCOCO 样本上,候选 token 分布的 JSD 呈 U 型;PSAP 属不稳定表示阶段,SAP 最稳定,EDP 虽不如 SAP 稳定却仍含有效解码引导。
4. 研究方法
- 总体流程:不改权重、不加对比分支,只在解码循环里复用已经被算出来的历史 logits,聚合成 residual 信号后融合到当前步的 logits。
- Candidate Token Pool 与 JSD 分段:以当前步 top-k 构成候选池 Ω_t;在长度 W 的滑动历史窗内计算相邻步分布间的 JSD(JSD(P_t1‖P_t2) = ½D_KL(P_t1‖M) + ½D_KL(P_t2‖M),M 为均值分布),取 U 型最低点切分 PSAP / SAP / EDP,并把 SAP+EDP 拼成”半 U 型”历史聚合窗 Δ_t。默认 W = 8。
- Confidence-Weighted Aggregation(置信度加权聚合):用 token 级局部置信度 C_i = −(1/|Ω_t|)Σ _ {j=1}^{Ω_t} log P_i(j)(低熵=高置信),历史残差信号 logit^res_θ(y_t) = Σ _ {i∈Δ_t} (C_i / Σ_j C_j) · logit_θ(ŷ_i | T _ {<i});对最早生成、历史不足的 token,用 query x 对应位置的解码结果补历史区间。
- Assembly of History and Present(历史与当前融合):p_ResDec(y_t|v,x,y_<t) = Softmax[(1−α)·logit_θ(y_t|T _ {<t−1}) + α·logit^res_θ(y_t|T _ {<t−1})],α∈[0,1](α=0 退化为常规解码);再用 V_head(y_<t) = {y_t : p_θ ≥ β·max_w p_θ} 做自适应截断,域外 token 的 logits 置为 −∞,防止只校准整体分布时反而抬升不合理输出。默认 α = 0.5、β = 0.1。
5. 实验结果
- 基座模型:LLaVA-1.5 (7B)、Qwen2.5-VL-Instruct (7B)、InstructBLIP (Vicuna-7B)
- 数据集与基准:共 11 个——POPE(Random/Popular/Adversarial 三个子集)、CHAIR、HallusionBench、MME、MMBench、MMVP、ScienceQA、MMStar、MM-Vet、SEEDBench2 Plus、LLaVA-Bench (In-the-Wild)
- 关键结果:
- POPE:相对 Regular 解码在三个 LVLM 上平均提升 7.84% 准确率与 8.01% F1;Qwen2.5-VL 上 ResDec 平均准确率 90.16 / F1 89.56(对比 VISTA 88.83/88.99、ONLY 89.16/88.49),LLaVA-1.5 87.23/86.93(Regular 79.83/79.29)。
- HallusionBench 与 CHAIR:CHAIR 上相对 Regular 平均改善 16.57%(CHAIRS)与 26.44%(CHAIRI);Qwen2.5-VL 的 CHAIRS 30.6 → 25.8、CHAIRI 8.4 → 6.8,HallusionBench fACC 43.4 → 47.1、qACC 45.8 → 49.0、aACC 69.1 → 71.6。
- 综合基准:跨三模型比 Regular 分别提升 2.87%(MME)、2.99%(ScienceQA)、11.65%(MMVP);Qwen2.5-VL MME 2309.42 → 2348.40、MMVP 58.00 → 63.33、MM-Bench 81.05 → 82.64。
- 消融:候选池 |Ω_t| 在 64–512 之间最优(扫描 2–4096),过小无法刻画 JSD 变化、过大混入早期局部信息而破坏 SAP 定位;α 超过 0.5(0.75/1.0)反而有害、β = 0 次优,说明残差只是辅助修正;窗口选择上 SAP Only 可用但仍逊于完整 ResDec(Qwen2.5-VL POPE 88.82 vs 90.16),PSAP 会引入早期噪声导致退化,置信度加权也优于 Uniform Pooling 与 Distance Decay。
- 效率:ResDec 延迟 29.11 ms/token(Greedy 28.54、VCD 62.79、OPERA 104.46),显存 14296 MB,吞吐 34.35 token/s,是所有对比方法中延迟最低、仅比 Greedy 慢约 0.02×。
- 对比方法:VCD、ICD、DoLa、OPERA、AGLA、ONLY、MemVR、VISTA(8 个 SOTA 免训练解码/内部干预方法)。
6. 论文结论
- 作者自述贡献:揭示 LVLM 幻觉的本质是幻觉 token 在解码阶段出现并反超真实 token(Fig. 1);提出免训练、即插即用的 ResDec,用 JSD 分析历史 logits、聚合语义清晰 token 的 logits 构成残差流并融入当前解码,抑制 Language-Prior Hallucination,且推理开销可忽略。
- 局限与未来工作:论文正文没有独立的 Limitation / Future Work 章节,论文未明确说明。效率分析中提到该方法运行期间需要保存一段历史 logits 序列(因此额外显存来自这些缓存的 logits,实测与 Greedy 基本持平);作者在结论里只表示这为解码阶段的干预提供了思路,未列出后续工作计划。
[27] CVPR2026 — See It, Say It, Sorted: An Iterative Training-Free Framework for Visually-Grounded Multimodal Reasoning in LVLMs
- 会议:CVPR 2026(arXiv 录用说明:CVPR2026 Accepted)
- arXiv:2602.21497 — https://arxiv.org/abs/2602.21497
- 本地 PDF:
CVPR2026-See It, Say It, Sorted An Iterative Training-Free Framework for Visually-Grounded Multimodal Reasoning in LVLMs.pdf - 一句话定位:用文本证据池监督解码每步、按需调视觉判定器补证据,免训练治长链幻觉传播。
1. 中文摘要
LVLM 通过长链思维(CoT)展现推理能力,但多模态 CoT 极易发生”视觉幻觉传播”:一旦某个中间步骤与视觉证据不符,后续步骤即便逻辑自洽也会导向错误答案。现有做法靠强化学习训练模型”think with images”(学会何时 zoom/crop 并把裁剪区域重新注入推理上下文),代价高、模型专属、难以跨架构迁移。本文提出 ECRD(Evidence-Constrained Reweighting Decoding):一种迭代式、免训练、即插即用的解码框架,把解码视为”每个 token 都要有视觉证据支撑”的过程。它在测试时维护一个文本形式的视觉证据池,基础 VLM 每步给出 top-k 候选后,监督器(supervisor)用均摊前缀概率构造证据诱导分布,并与基础分布做质量匹配后的协商重加权;若协商后的概率间隔仍低于不确定度阈值 δ,就调用轻量视觉判定器(GRIT-3B)在当前推理上下文下读图,强制选定 token 并把一条简短微观察追加进证据池供后续步骤复用。因为证据是文本而非像素,无需反复编码裁剪图,额外计算受控。方法在 TreeBench 提升 16.5%–29.5%,在 RH-Bench 上 RH-AUC 提升 13.7%。
2. 方法图
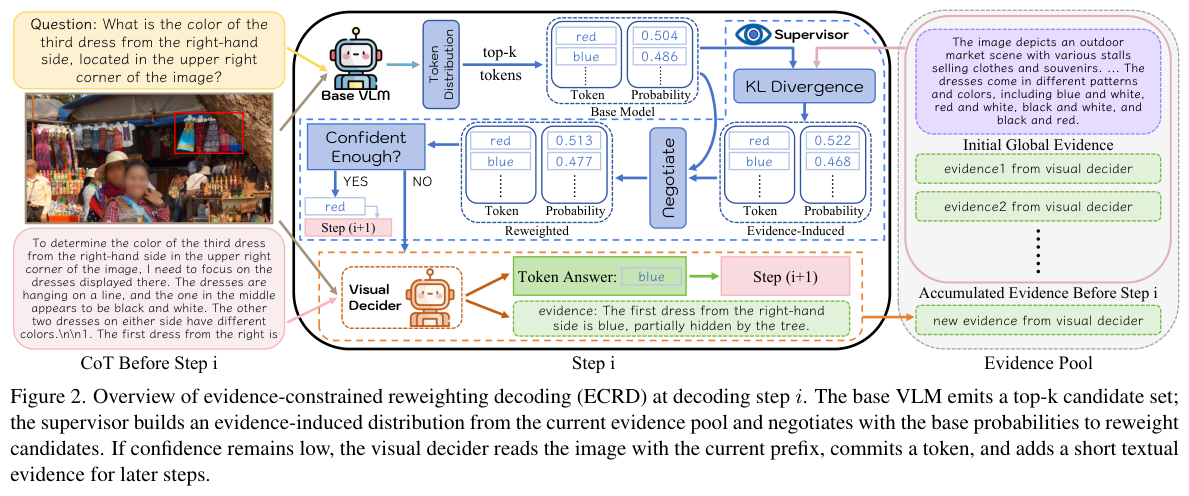
3. 研究动机
- RL”think with images”的代价:这类 RL / 偏好优化流水线依赖人工整理的数据、奖励设计与重算力,且与特定基座紧耦合;学到的策略把空间探索与 CoT 纠缠在一起,反复编码裁剪视图带来延迟;模型规模越大越不可负担。
- 关键观察:能力错配:”想得更多”往往伴随”看得更少”——解码时模型要在图像、不断增长的文本上下文与指令 token 三种上下文之间平衡,上下文一长,细微但关键的视觉线索容易被语言先验压过;一个偏离视觉证据的 token 就足以把整条推理链带向流畅但视觉不一致的轨迹。
- 问题源自解码时刻:这种 reasoning–perception drift 不是模型缺乏视觉理解,而是长程 token 生成逐步放大了语言先验,因此作者主张在测试时逐步监督(而不是训练时学习何时看)。
- 三项设计属性(对应上述缺陷):免训练且天然可迁移(冻结 LVLM 外挂轻量判定器);构造上就考虑成本(只有不确定时才调用判定器);证据用文本而非像素表示(后续 token 可直接引用先前的微观察,无需重复编码裁剪图)。
4. 研究方法
- 总体流程:把 ECRD 拆成”监督器协商重加权 + 不确定时按需调用视觉判定器”两个部件,环绕在冻结的基座 VLM 外层,只改测试期解码过程。
- 候选集与 VDGD 起点:用 knee truncation 取 top-k⋆(k⋆ = argmax_k (p(k) − p(k+1)))构成候选集 C_i;相比前置方法 VDGD 的”对固定 caption 做 min-over-prefix KL 并替换 logits”,ECRD 改为 mean-over-prefix 概率并做混合而非覆盖。
- Distribution Supervisor(证据诱导分布):q_E(w) = (1/L)Σ_j p_VLM(w | e_<j),对池中 N 条证据求平均得 S_i(w) = −log((1/N)Σ_E q_E(w)),再在 C_i 上归一化为 r_i(w),并做质量匹配缩放 r̃_i(w) = r_i(w)·(Σ _ {C_i}p_i/Σ _ {C_i}r_i),使 C_i 内的总概率质量与原分布一致。
- 协商与免超参权重:p_i^mix(w) = α_i p_i(w) + (1−α_i) r̃i(w)(w∈C_i;否则为 α_i p_i(w)),其中 α_i = p(1) 直接取基础模型 top-1 概率、无需调参:基础分布尖锐(自信步)时以原分布为主,弥散(幻觉临界步)时证据权重更高。
- 触发与视觉判定器:计算协商间隔 Δ_i = p^mix_(1) − p^mix_(2),当 k⋆ > 1 且 Δ_i ≤ δ 时判定为可能幻觉步,调用由 GRIT-3B(基于 Qwen2.5-VL-3B、面向视觉 grounding)实现的轻量判定器;它接收图像、文本前缀尾部与候选集 C_i(故意不给原问题,只解决当前步),输出选项 w⋆ 与一句人类可读证据 E_i,强制 w⋆ 并把句子并入池 E _ {i+1} ← E_i ∪ {E_i};坐标只作标注、不参与打分。证据池以全局描述 d_global 初始化,之后按需增长,默认 δ = 0.08。
5. 实验结果
- 基座模型:LLaVA-OneVision(7B、72B)、Qwen2.5-VL(7B、32B、72B)、InternVL3(8B、38B、78B);视觉判定器为 GRIT-3B(基于 Qwen2.5-VL-3B),消融时也用 Qwen2.5-VL-3B
- 数据集与基准:TreeBench、RH-Bench(Reasoning / Perception / RH-AUC)、V*Bench、MathVista、ChartQA、OCRBench、HallusionBench
- 关键结果:
- TreeBench:Qwen2.5-VL-7B 总体准确率 37.0% → 47.9%(+10.9);其他开源通用模型绝对提升多在 +4–8 点区间;对比同规模 RL 方法 DeepEyes-7B、Pixel-Reasoner-7B 均被超过,接近 TreeVGR-7B(50.4),同时超过 Gemini-2.5-Flash 与 GPT-4o,但仍落后 Gemini-2.5-Pro 与 o3。
- RH-Bench:Qwen2.5-VL-7B 上 Reasoning 39.6 → 46.4、Perception 50.2 → 57.1、RH-AUC 0.51 → 0.58。
- 综合基准(Qwen2.5-VL-7B):OCRBench 82.3 → 90.7,HallusionBench 61.3 → 72.5,V*Bench overall 71.2 → 74.9,MathVista 68.2 → 72.3,ChartQA 84.4 → 88.3;LLaVA-OneVision-7B 上 HallusionBench 55.1 → 63.7。
- 消融(Qwen2.5-VL-7B, TreeBench overall):只用 GRIT-3B 得 30.1,VDGD 39.5,仅 supervisor 40.7,判定器换成 Qwen2.5-VL-3B 的 ECRD 43.7,完整 ECRD 47.9——说明提升来自解码设计而非更强的感知模型;增益拆解为:判定器直接给出最终答案占 11.4%、判定器提供链中 grounding 解锁后续推理占 18.2%、其余来自 supervisor 协商与证据池的间接收益(70.4%)。
- 效率:δ 增大时判定器调用率 r 单调上升而准确率在 δ≈0.08 出现拐点;端到端时间近似 T(δ) ≈ t0 + l0·r(δ),各基准 t0 为 8.98/12.92/9.76/3.24/11.67 秒,单次调用约 1.12–1.46 秒(单张 H20-NVLink)。
- 对比方法:训练无关基线 Woodpecker、ViperGPT、ControlMLLM,以及 Beam Search / Self-Consistency / Diverse Sampling;RL 型视觉 grounding 系统 DeepEyes、Pixel-Reasoner、TreeVGR-7B。
6. 论文结论
- 作者自述贡献:提出免训练、即插即用的解码框架,用不断增长的文本证据池监督 token 选择并与基础模型协商概率,而非依赖学到的工具调用策略;用不确定度触发的视觉判定器仅在必要时产出可复用的简短微证据,取得良好的成本–精度折中;方法可跨 LVLM 基座迁移,在广泛基准上稳定降低幻觉并明显提升任务准确率。
- 局限与未来工作:论文未明确说明(正文第 4 节 Conclusion 只总结方法与效果,没有 Limitation 或 Future Work 章节)。可视为隐含约束的是:不确定度阈值 δ 需按部署预算选择(默认 0.08),判定器调用次数随 δ 上升而增加、超过拐点后收益递减。
[28] CVPR2026 — Tell Model Where to Look: Mitigating Hallucinations in MLLMs by Vision-Guided Attention
- 会议:CVPR 2026(arXiv 录用说明:CVPR 2026)
- arXiv:2511.20032 — https://arxiv.org/abs/2511.20032
- 本地 PDF:
CVPR2026-Tell Model Where to Look Mitigating Hallucinations in MLLMs by Vision-Guided Attention.pdf - 一句话定位:用视觉 token 自身 logits 推出 VSC 定位先验,直接给注意力加偏置引导看图。
1. 中文摘要
视觉注意力是 MLLM 解读图像信息的主要通道,但它的定位能力有限,常常导致幻觉。作者观察到一个矛盾现象:模型其实能从视觉 token 中准确抽出视觉语义,却没有在后续推理中充分利用这一优势。基于此提出 Vision-Guided Attention(VGA)——一种免训练方法:先从视觉 token 的 logits 中提取语义置信度,得到 token 级的视觉 grounding,再用它把模型的注意力导向真正相关的图像区域。核心概念是 Visual Semantic Confidence(VSC):某个词出现在某视觉 token 的 logits 中的分数,刻画该词与该局部视觉上下文的语义相关性;对全部视觉 token 做 max pooling 即得整图对该词(物体)的置信度,聚合后可构成 grounding 图。VQA 场景按问题中抽取的物体做 object-directed grounding;图像描述这类无明确物体的场景则用输出不确定度构造 Visual Semantic Salience(VSS)做 object-agnostic grounding。VGA 把 grounding 以加性偏置 β·G 注入注意力权重,并借助加法结合律写成 z + β·γ·Δz,因此不需要显式取得注意力权重,完全兼容 FlashAttention;每个 token 只前向一次。此外用注意力头平衡系数 γ 避免破坏模型固有的视觉头,用 Programmed Vision-Guidance(PVG)在描述生成时逐步抑制已被描述的区域。在 POPE / CHAIR / AMBER 上取得 SOTA 去幻觉效果,TTFT 仅增加 4.36%、TPOT 仅增加 6.01%。
2. 方法图
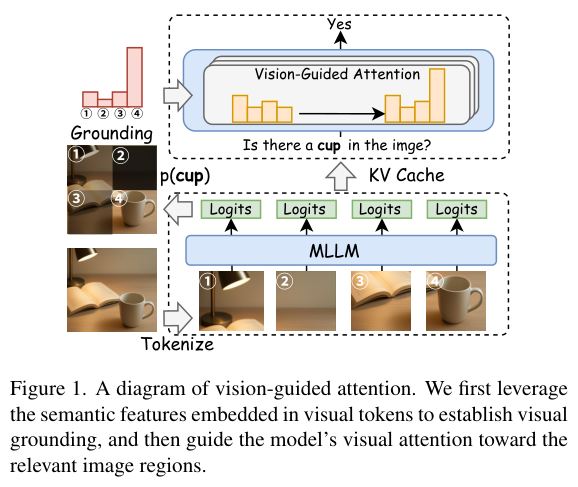
3. 研究动机
- 既有视觉注意力优化的根本局限:PAI/VAF/TARAC 一类方法依赖视觉注意力自身质量,而注意力本身就难以准确定位关键区域(存在 attention sink 现象,对大面积物体只盯局部),因此性能次优;用外部工具或额外前向又会增加开销、降低可用性。
- 与 FlashAttention 不兼容:这些方法基于注意力分布做优化,需要显式拿到注意力权重 α,而 FlashAttention 不暴露权重,可用性被进一步限制。
- 关键观察:模型能够从视觉 token 准确提取语义特征,并把它们实例化为视觉 logits 中的条件概率;这一”逐 token 的语义分布”足以做 token 级视觉定位(即 VSC)。作者进一步发现 VSC 与模型自身回答并不总一致——模型对同一样本可能”已经看见了但没说对”,说明视觉理解尚未被充分挖掘。
- 失效归因:作者把 MLLM 幻觉归为两点——(1) 已提取的视觉特征未被充分利用(即使该物体 VSC 很高也可能答错);(2) 视觉注意力次优(无法准确聚焦最相关区域)。VGA 正是针对第二点,用第一点提供的先验去修正。
- 对比解码与特征编辑的代价:对比解码类方法通常需要额外前向;嵌入空间的特征编辑在高维空间易引入噪声。
4. 研究方法
- Visual Semantic Confidence(VSC,物体导向 grounding):定义 c _ {v_i}(O) = softmax[logit _ {v_i}(O)],并用物体首个 token o0 近似(c _ {v_i}(O) ≈ c _ {v_i}(o0));整图置信度取 max pooling c(O) = max_i c _ {v_i}(o0);grounding 向量 G_O = Norm[{c _ {v_i}(o0)}] ∈ R^m。阈值 log[c(O)] > −2.5 由 COCO Random 子集上网格搜索 F1 得到。
- Visual Semantic Salience(VSS,无物体导向 grounding):面向图像描述这类 object-agnostic 任务,用输出不确定度度量语义显著度,c _ {v_i} = −Σ_k log c _ {v_i}(w_k) / log K({w_k} 为该 token 的 Top-K),显著度高的 token 对应明确物体、背景区域得分低。
- Vision-Guided Attention 注入:用 NLP 工具(Stanza)从问题中抽物体,多个物体时取 α̂ _ {h,−1,s:e} = α _ {h,−1,s:e} + β·G(G = max_j G _ {O_j},β 为超参);利用加法结合律得 ẑ = (α + β·G)V = z + β·Δz,无需显式注意力权重,因而兼容 FlashAttention;每个 token 只前向一次(预计算 VSC 后走 KV cache)。
- Attention Heads Balancing:多头天然分化出视觉头,为避免破坏其固有视觉能力,对视觉功能强的头给弱引导、非视觉头给强引导:γ’ = Norm(sim(z, Δz)),γ = ReLU(2 − H·γ’),更新式为 ẑ = z + β·γ·Δz。
- Programmed Vision-Guidance(PVG,用于图像描述):生成过程中动态抑制已描述区域,G _ {t+1} = (1+λ)G_t − λG_w(w 为当前步生成的 token),再做 G’ _ {t+1} = Norm(ReLU(G _ {t+1}));并按 ẑ = z + ‖G‖_0·γ·β·Δz 随生成推进逐步衰减引导强度。
5. 实验结果
- 基座模型:LLaVA-1.5-7B(表中作 LLaVA-7B)、LLaVA-1.5-13B(LLaVA-13B)、LLaVA-Next、Qwen2.5-VL
- 数据集与基准:POPE(报告 MSCOCO / A-OKVQA / GQA 上的平均,含 Random / Popular / Adversarial 三个子集)、CHAIR(CHAIRs、CHAIRi、F1)、AMBER(CHAIR / Cover / Hal / Cog / Acc / Prec / Rec / F1 / AMBER 综合分),附录另有 AMBER 属性与关系任务以及 MME 感知分
- 关键结果:
- POPE Random(LLaVA-7B):准确率 87.12 → 89.28、F1 87.94 → 89.41(PAI 86.20/87.20、VAF 84.88/86.34、TARAC 86.99/87.80);Adversarial 提升最明显:71.85 → 77.02 Acc、77.04 → 79.88 F1;Popular 79.38 → 83.51。Qwen2.5-VL Random 89.88 → 91.08,LLaVA-Next Random 87.36 → 89.91(表中最优)。
- CHAIR(LLaVA-7B):CHAIRs 52.2 → 29.8、CHAIRi 13.9 → 8.2,同时 F1 维持 76.1 → 76.3;LLaVA-13B CHAIRs 52.6 → 30.0、CHAIRi 14.1 → 8.2。
- AMBER(LLaVA-7B):CHAIR 7.1 → 4.5、Hal 32.5 → 21.6、F1 74.8 → 79.5、AMBER 34.35 → 38.00;Qwen2.5-VL AMBER 43.15 → 43.40。
- 消融:去掉 PVG 后 Cs 降到 22.2、Ci 5.6,但召回 R 从 70.4 掉到 65.0、F1 从 76.3 掉到 74.5,说明静态引导只是”少说少错”;反向着色(Reversed VSS,用 1−G)反而变差(Cs 30.6、Ci 8.6、R 69.5、F1 75.9)。头平衡与中途停止引导(early exit)两项设计均带来正向增益。
- 效率与额外发现:LLaVA-1.5-7B 上 AMBER 的 TTFT 仅增加 4.36%、CHAIR 的 TPOT 仅增加 6.01%;VSC 定位质量上,正样本平均 Informative Coefficient 0.64、负样本 0.42,误报 0.57、真负 0.41,IC 与误报的 Pearson 相关 r = 0.414 ± 0.019;即便 grounding 很差(DICE < 0.01),正样本准确率仍有 88.5%,高于均匀引导的 87.1%。MME 感知分 LLaVA-1.5-7B 1456.5 → 1465.7,Qwen2.5-VL-7B 1691.1 → 1719.7。
- 对比方法:PAI(含开启对比解码的 PAICD)、VAF(Clearsight)、TARAC 三个近期基于视觉注意力的免训练去幻觉方法。
6. 论文结论
- 作者自述贡献:提出 Visual Semantic Confidence,无需外部工具即可构建精确视觉 grounding;提出免训练且兼容 FlashAttention 的 Vision-Guided Attention,用 VSC grounding 引导视觉注意力聚焦最相关 token;实验与分析证明 VSC 定位准确、VGA 有效缓解幻觉。
- 局限与未来工作:论文没有独立的 Limitation / Future Work 章节,论文未明确说明未来计划。正文确实报告了失效情形:真阳性样本平均 DICE 为 0.0475,而假阴性样本仅 0.0006,这些失败源于模型未能有效提取视觉特征、由退化的视觉 logits 得出的 VSC 失效;作者也指出 VSC grounding 与特征 grounding 之间存在错位(视觉 hidden state 会吸收前序 token 特征),因此即便定位次优仍可能带来位置偏好上的收益。
[29] CVPR2026 — Understanding and Mitigating Hallucinations in Multimodal Chain-of-Thought Models
- 会议:CVPR 2026(arXiv 录用说明:CVPR 2026)
- arXiv:2603.27201 — https://arxiv.org/abs/2603.27201
- 本地 PDF:
CVPR2026-Understanding and Mitigating Hallucinations in Multimodal Chain-of-Thought Models.pdf - 一句话定位:发现多模态 CoT 的幻觉集中在”发散思维”步骤,用视觉熵定位并干预解码。
1. 中文摘要
多模态思维链(MCoT)模型在复杂视觉推理上表现亮眼,但近期研究发现它们在生成过程中视觉注意力衰减、幻觉严重。作者指出:视觉注意力衰减在传统 LVLM 中早已被充分研究,而 MCoT 与传统 LVLM 的推理过程有本质差异(前者显式推理、后者隐式推理),因此提出一个基本问题——MCoT 是否有其独特的幻觉成因?通过系统考察 thinking 与 answering 两个阶段的幻觉模式,作者发现:thinking 阶段的幻觉与 answer 阶段的幻觉强正相关(ρ > 0.96、R² > 0.92),且答案 token 对图像的注意力不足 0.04、对 thinking token 高达 0.968,说明幻觉源自思考过程并经自注意力传播到答案。进一步的细粒度分析显示,臆造文本主要集中在联想性推理步骤,作者称之为 divergent thinking(发散思维),该模式下幻觉率约为正常思考的 5 倍。为定位这类步骤,作者提出基于熵的 visual entropy 分数(对视觉 token 上预测概率的归一化熵),实验证明它能可靠区分两种思维模式(logistic 回归 McFadden’s pseudo-R² > 0.9);随后把它作为解码约束:p̂_t = p_t·e^(−α·E(·,v)),只在高熵(发散)步骤干预,抑制高熵 token、鼓励低熵 token。该策略免训练、可与其他缓解方法(DoLa、VCD)及其他解码策略叠加。
2. 方法图
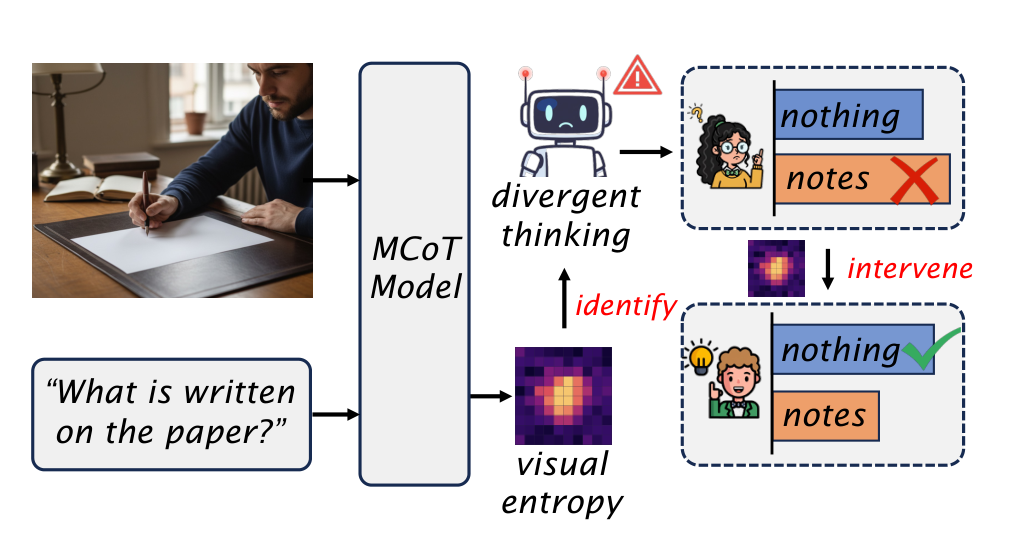
3. 研究动机
- 既有解释不够独特:Liu et al. 与 Tian et al. 把 MCoT 幻觉归因于推理链变长导致视觉注意力衰减,但视觉注意力衰减在 LVLM 中是被广泛研究的老问题;作者因此追问 MCoT 是否存在独特的幻觉成因。
- 发现 1(思考传播幻觉):用
/ 切分后计算成对幻觉率,thinking 与 answering 的幻觉率呈强正相关(ρ > 0.96、R² > 0.92);注意力可视化显示答案生成时模型注意力严重偏向 thinking 部分(对图像仅 0.032,对 thinking 高达 0.968),幻觉由思考过程经自注意力传播到答案。 - 发现 2(发散思维是独特成因):受认知科学中”发散思维 + 正常思维协同处理复杂任务”启发,作者把推理链按联想强度切分为 normal / divergent 两类片段(GPT-5 初标 + 三名研究生标注者校验),统计发现发散思维片段的幻觉率约为正常思考的 5 倍(R1-Onevision-7B 为 ×5.6、PixelReasoner-7B 为 ×4.9)。
- 待解难点:发散思维没有明确定义的标签,很难直接识别;即使识别出来,如何纠正这段推理也是开放问题。作者假设:发散思维时模型”重推理、轻感知”,对图像的不确定性会升高,因此可用图像侧的不确定度来指代它。
4. 研究方法
- Visual Entropy(视觉熵):把视觉 token 经语言头 + softmax 映射为词表分布 p_v ∈ R^{|V|×m},取预测 token y_t 对应的视觉激活概率 p_v(y_t) ∈ R^m,定义 E(y_t, v) = −Σ _ {i=1}^m p _ {v,i}(y_t)·log p _ {v,i}(y_t) / log m,用 log m 归一到 [0,1]。含义是”当前 token 在各视觉 token 上的激活分布有多不确定”。
- 用视觉熵识别发散思维(Application 1):按 Sec. 3.4 的片段标签分别统计两类片段的平均熵,正常思维明显低于发散思维;再用 logistic 回归做思维模式二分类,McFadden’s pseudo-R² 超过 0.9,说明高视觉熵能可靠预测发散思维步骤。
- 用视觉熵干预解码(Application 2):第 t 步若 E(y_t,v) > γ(判为发散思维步),则修正分布 p̂t(·|v,q,y<t) = p_t(·|v,q,y_<t)·e^(−α·E(·,v)),其中 α∈[0,1] 为干预强度;否则保持原分布。该式鼓励低视觉熵 token、惩罚高视觉熵 token,形式上是受约束解码;只在发散步骤生效,避免”全程干预”。
- 免训练与效率:干预只发生在解码阶段,不做二次推理(避免对比解码的双倍开销),也不做隐状态编辑或视觉注意力 steering;p_v 可在 prefilling 阶段预计算,解码期额外开销可忽略。超参 γ 与 α 经实验证明与模型无关(换 GRIT-3B、R1-Onevision-7B 仍适用),默认 γ = 0.5、α = 0.75。完整流程见论文 Algorithm 1。
5. 实验结果
- 基座模型:GRIT-3B、PixelReasoner-7B、R1-Onevision-7B(三个不同架构与规模的 MCoT 模型)
- 数据集与基准:Object HalBench(CHAIRS↓、CHAIRI↓)、MMhalBench(HalRate↓、Score↑)、POPE(Random / Adversarial / Popular 的 Acc、F1)、MathVista、MMStar、VSR(后三者评估通用感知与推理)
- 关键结果:
- GRIT-3B:CHAIRS 23.8 → 16.0、CHAIRI 10.5 → 5.5(相对 backbone 提升 47.6%),HalRate 0.51 → 0.42,MMhalBench Score 1.94 → 2.15;POPE Random 78.1 → 81.0 Acc / 72.2 → 76.7 F1,Adversarial 77.5 → 79.8,Popular 78.6 → 80.6。比前 SOTA(FlexAC)在 CHAIRS 上再低 3.0 点以上。
- PixelReasoner-7B:CHAIRS 22.0 → 15.4、CHAIRI 7.8 → 5.3,HalRate 0.37 → 0.26,Score 3.70 → 4.12,POPE Random 85.5 → 87.3;R1-Onevision-7B:CHAIRS 23.2 → 15.8、CHAIRI 9.4 → 5.7、Score 2.18 → 2.51。
- 通用能力不降反升(Table 2):GRIT-3B 的 VSR 72.9 → 76.1(+3.2);PixelReasoner-7B 的 MathVista 62.6 → 64.0、VSR 82.4 → 84.3;R1-Onevision-7B 的 MathVista 64.1 → 65.0、MMStar 52.8 → 54.2。
- 消融(PixelReasoner-7B):只干预发散步骤(Divergent-only)得 CHAIRS 15.4 / CHAIRI 5.3 / MathVista 64.0,优于”全程干预 All Thinking”(16.1 / 5.7 / 61.4)与”只调正常步骤 Normal-only”(21.8 / 7.7 / 62.7);把干预手段换成 PAI(19.6/7.0/63.2)或 MemVR(19.1/6.8/63.4)都不如视觉熵。
- 兼容性:与 DoLa 叠加得 17.9/6.0/63.4、与 VCD 叠加得 16.1/5.3/63.5(而单独 DoLa/VCD 会把 MathVista 拉低,例如 VCD 降 0.7 点);在 greedy、nucleus sampling、beam search 下均稳定有效,如 beam search 下 CHAIRS 20.8 → 15.1、CHAIRI 7.4 → 4.9;视觉熵使 backbone 的 CHAIRS 降低 30%;相比 FlexAC 不仅幻觉率更低、速度还快 1.2×。
- 对比方法:DoLa、VCD、MemVR、FlexAC 四个 SOTA 幻觉缓解方法;消融中还对比了 PAI 与 MemVR 作为替代干预手段。
6. 论文结论
- 作者自述贡献:系统分析 MCoT 模型的幻觉成因,发现发散思维是幻觉出现的关键因素;把模型的外部幻觉行为与内部视觉熵联系起来,证明该分数可用于定位并缓解幻觉;大量实验显示方法不仅缓解幻觉,还提升了通用感知与推理能力。
- 局限与未来工作:论文没有独立的 Limitation 或 Future Work 章节,论文未明确说明。可视为已明确的前提与约束的是:方法依赖 γ 与 α 两个超参(默认 γ = 0.5、α = 0.75,作者实验论证其与模型无关);发散思维片段的监督标签是半自动构造的(GPT-5 初标 + 三名研究生标注者校验),并非自动可得;案例研究阶段只以 R1-Onevision-7B 为主并重复三次随机种子。
[30] CVPR2026 — Understanding the Role of Hallucination in Reinforcement Post-Training of Multimodal Reasoning Models
- 会议:CVPR 2026(arXiv 录用说明:CVPR 2026)
- arXiv:2604.03179 — https://arxiv.org/abs/2604.03179
- 本地 PDF:
CVPR2026-Understanding the Role of Hallucination in Reinforcement Post-Training of Multimodal Reasoning Models.pdf - 一句话定位:用”致幻损坏”当探针,检验 RL 后训练究竟是否真的在用视觉信息。
1. 中文摘要
RL 已被广泛用于多模态大模型(MLLM)的后训练以增强视觉推理,性能提升被反复报道,但”RL 训练是否真的让模型从视觉信息中学习”仍不清楚。本文提出 Hallucination-as-Cue 分析框架,从模型幻觉的角度切入研究 RL 后训练的作用:设计三类”致幻的、模态特异的数据损坏”——Blank Image Replacement(把图换成空白图,抹掉全部视觉信息)、Random Image Replacement(换成数据集中的随机图,制造图文错配)、Textual Information Removal(用规则匹配删除文本条件与问题,必要时只留模板)。这些损坏会移除或替换推导正确答案所必需的信息,从而强迫模型”靠幻觉推理”;由于规则型奖励只看最终答案是否正确,少数被幻觉却答对的轨迹会得到正奖励(hallucination-inductive reward)并被强化。框架在训练与评测两侧同时施加损坏,并设置 S1–S8 共八种对比情景。结论出乎意料:在纯致幻条件下做 RL 后训练仍能显著提升推理性能,某些情况甚至超过干净数据上的标准 GRPO;越大的模型从幻觉轨迹中获益越多;而损坏式推理分析显示,对较小的模型,视觉信息有时反而会拖累表现。
2. 方法图
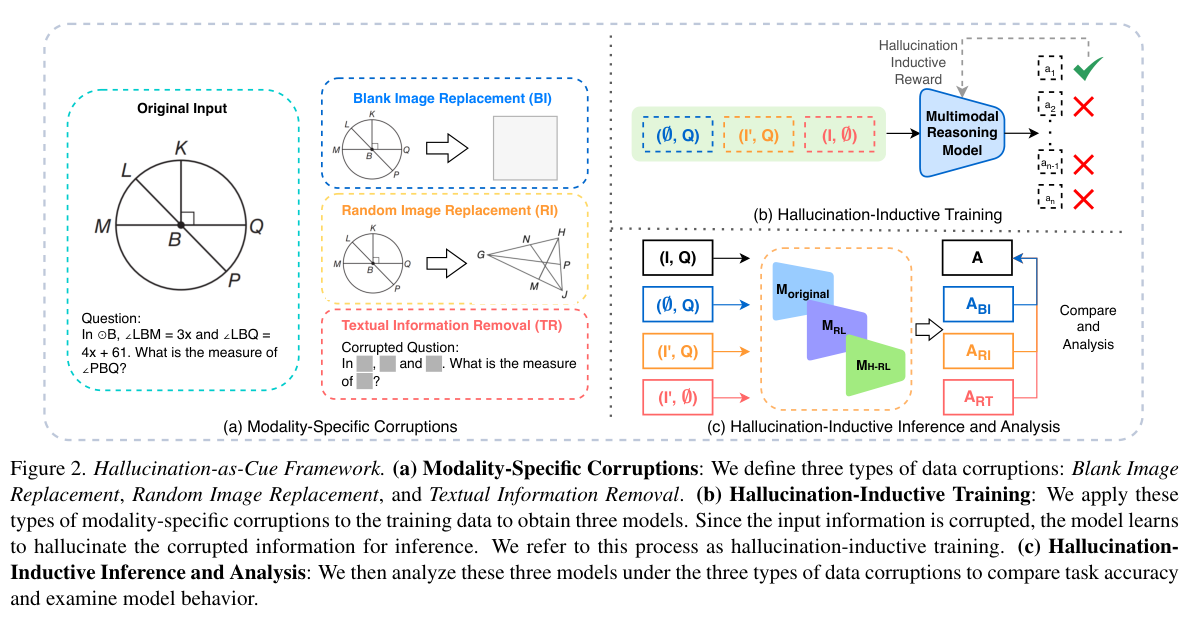
3. 研究动机
- 核心疑问:给定最终答案式奖励本身是”模态无关”的,作者提出必须先回答一个问题——RL 后训练是真的利用视觉信息教会模型”看并推理”,还是只是在强化 LLM 内部原有的文本推理模式?这决定了多模态推理能否走向真正 modality-grounded 的智能。
- 关键观察:随推理链变长,MLLM 越来越依赖自生成的文本先验而非视觉依据,幻觉概率上升;但如图 1 案例所示,幻觉并不总导致错误答案——在移除视觉信息后,RL 训练过的模型只看问题本身反而给出正确答案。这一”幻觉有时无害甚至有益”的现象,使作者把幻觉从”要抑制的缺陷”改写为”可用于诊断视觉推理训练的信号”。
- 奖励设计带来的后果:规则型奖励只依据答案正确性,因此被幻觉但偶然答对的轨迹会被正强化,模型因此可能学到来自幻觉的推理模式。
- 既有研究的空白:已有工作多关注幻觉缓解或基准评测(把准确率下降当作幻觉的隐式指标),据作者所知,此前没有工作系统研究幻觉在推理 MLLM 训练过程中的作用;近期并行工作 Mirage 也只说明模型在无图时仍可保持高准确率。
4. 研究方法(分析实验设计)
- 总体设计:以”致幻损坏”为自变量、以 GRPO 为研究载体的对照实验框架。损坏分三种:Blank Image Replacement(BI,抹掉视觉信息)、Random Image Replacement(RI,错配图文)、Textual Information Removal(TR,删除文本条件/问题,匹配失败即整体删掉只留模板);分别在训练侧与评测侧施加,得到 M_RL(正常 GRPO)、M_H-RL(致幻训练)、M_original(base)三类模型做对比(对应 Fig. 2(a)(b)(c))。
- 训练设置:RL 算法为 GRPO(组内归一化优势 A_i = (R_i − μ_group)/(σ_group + ε),配合 PPO 式 clip 与 KL 惩罚),实现基于 EasyR1 框架;每个数据集训练 15 个 episode,AdamW、恒定学习率 1×10⁻⁶、权重衰减 1×10⁻²、梯度裁剪 1.0,rollout 数 5、采样温度 0.7、KL 权重 0.01。
- 八个评测情景(S1–S8):S1/S2 为正常模型在正常训练/测试集上的标准表现;S3/S4 为正常训练模型在损坏训练/测试集上的表现;S5/S6 为致幻训练模型在正常训练/测试集上的表现;S7/S8 为致幻训练模型在损坏训练/测试集上的表现。S1–S2 作为基线,S3–S4 看推理模型面对损坏输入的行为,S5–S6 看致幻训练是否损害干净数据上的能力,S7–S8 看致幻训练是否在损坏输入下也能多一些正确样本。
- 模型与数据:主实验用 Qwen2.5-VL-3B,另用 Qwen2.5-VL-7B 研究规模效应;训练数据用 Geometry3K、MMR1-V0、CLEVR 三个性质不同的数据集;评测除 Geometry3K 测试集外,还使用 MathVision、MathVerse、MathVista、WeMath 四个多模态数学推理基准,并利用 MathVerse 的细粒度题型标注(Text Dominant / Text Lite / Vision Intensive / Vision Dominant)做分类型分析。
- 探测手段:一是追踪训练过程中训练集与测试集准确率曲线(Fig. 3 正常推理、Fig. 4 损坏推理);二是跨基准平均分对比(Table 1–2);三是把 BI 损坏施加到评测数据上,观察各基准的准确率变化幅度以反推基准自身的”视觉依赖性”(Table 3–4)。
5. 实验结果
- 基座模型:Qwen2.5-VL-3B、Qwen2.5-VL-7B
- 训练数据集:Geometry3K、MMR1-V0、CLEVR
- 评测基准:Geometry3K 测试集、MathVision、MathVerse、MathVista、WeMath(MathVerse 另按 Text Dominant / Text Lite / Vision Intensive / Vision Dominant 四类细分)
- 关键结果:
- Geometry3K 上训练后的四基准平均分(Table 1):3B 从 base 39.72 提升到标准 GRPO 44.74(最优),致幻变体 GRPO-BI 42.25、GRPO-RI 42.45、GRPO-TR 42.34;7B 从 base 50.89 提升到 GRPO 53.52,而 GRPO-RI 54.23 反超标准 GRPO,GRPO-BI 53.15、GRPO-TR 53.51。MathVista 上 3B 的 GRPO-TR 达 58.50(略高于标准 GRPO 的 58.40),MathVerse 上 7B 的 GRPO-RI 达 49.90(标准 GRPO 47.56)。
- 规模效应:在 Geometry3K-BI 上,7B 从 9.7% 提升到 14.1%(+4.4),3B 从 7.6% 提升到 10.4%(+2.8),说明容量更大的模型更擅长生成并利用”正向幻觉轨迹”。
- 训练数据影响(Table 2):BI 损坏的增益不限于 Geometry3K,在 MMR1-V0(7B:GRPO 55.31 vs GRPO-BI 54.79)与 CLEVR(7B:GRPO 51.93 vs GRPO-BI 52.37,BI 更优)上都保持”接近甚至反超”的规律。
- 损坏式推理分析(Table 3,评测端施加 BI):多数情况准确率大幅下降,如 7B MathVista 67.00 → 30.70(−36.30)、平均 50.89 → 29.20(−21.69);但 3B 在 MathVision 上 18.19 → 18.91(+0.72),即去掉图像反而更准,作者归因于该基准来自真实数学竞赛、视觉信息有时是干扰,此现象在更大的 7B 或经过 RL 后训练后消失。
- 题型细分(Table 4,7B,MathVerse + BI 评测):下降幅度随文本信息减少而增大——Text Dominant −4.31、Text Lite −20.56、Vision Intensive −25.89、Vision Dominant −21.95;RL 训练带来的增益也集中在 Text Dominant(54.82 → GRPO 59.77);BI 训练在 Vision Dominant 与 Text Dominant 上的退化均小于标准 RL 后训练,说明它能减少对单一模态的过度依赖。
- 讨论给出的解释:损坏训练不会”损坏”模型,因为多数幻觉轨迹是负样本、会被忽略或抑制;RL 相比 SFT 更抗遗忘、不会剧烈偏移基座;少量正向幻觉轨迹确实包含正确的文本推理模式,值得被奖励。
- 对比方法:本文是分析型论文,对比对象是训练制度本身而非前作方法——即 base Qwen2.5-VL、标准 GRPO,以及 GRPO-BI / GRPO-RI / GRPO-TR 三种致幻训练变体;相关工作层面讨论了 Vision-R1、VLM-R1、R1-Onevision 等 RL 后训练工作与 Mirage。
6. 论文结论
- 作者自述贡献:给出首个从幻觉视角系统分析多模态推理模型 RL 后训练的工作;提出 Hallucination-as-Cue 框架,可在致幻条件下诊断训练算法、推理模型与推理数据集的行为;通过大量分析说明幻觉在多模态推理训练中的作用远比此前认识的重要,从而推动更 principled 的 RL 后训练设计。
- 局限与未来工作(作者原文表述):虽然提供了初步分析,但驱动这些现象的内在机制复杂且多维,仍需进一步研究;此外本研究主要聚焦主流的 RL 类训练,其他推理范式(如 latent-space reasoning)留作未来工作。
[31] CVPR2026 — ZINA: Multimodal Fine-grained Hallucination Detection and Editing
- 会议:CVPR 2026(arXiv 录用说明:CVPR 2026 Main Conference)
- arXiv:2506.13130 — https://arxiv.org/abs/2506.13130
- 本地 PDF:
CVPR2026-Zina Multimodal Fine-grained Hallucination Detection and Editing.pdf - 一句话定位:把 MLLM 幻觉检测从”粗粒度/整句”推进到”词级片段 + 六类错误 + 给出改写建议”,用检测器+审查器两段式 MLLM 实现。
1. 中文摘要
论文指出多模态大模型(MLLM)在图像描述中产生的幻觉形态多样,而既有检测工作多停留在粗粒度(如只处理物体幻觉)或句级、长跨度级别,无法支撑细粒度错误分析。为此作者提出一个新任务:多模态细粒度幻觉检测与编辑——给定某 MLLM 生成的描述 x_desc、图像 x_img 以及人工撰写的参考描述 x_ref,模型需定位被幻觉污染的词语片段、按六类分类法(Object / Attribute / Number / Text / Relation / Fact,外加一个无幻觉类,共七类)判定错误类型,并给出恰当的修正建议;任务被形式化为打标签(tagging)问题,输出为 ŷ = {Ŷ_text, Ŷ_edit, Ŷ_type}。方法 ZINA 采用两阶段结构:detector MLLM(M_det) 负责找出幻觉片段及其错误类型,随后用一个确定性函数 T 把标签插入到原句对应片段(把”逐词复制原文”从语言模型职责中剥离),再由 reviewer MLLM(M_rev) 结合图像与参考描述判断标签是否打得恰当,并在编辑设定下为每个片段生成 refinement。为训练与评测,作者构建 VisionHall:检测子集含 12 个 MLLM 生成的 6,854 条描述(4,759 张图,211 名标注者人工标注);编辑子集含用”错误注入 + 图增强”合成的 20k 样本(o3-mini 注入错误并显式建模错误依赖,DAG 剪枝生成多样样本)。ZINA 在检测与编辑两项任务上均超过 GPT-4o、Llama-3.2-90B-Vision 等基线,并在域外 MHaluBench 上取得优势。
2. 方法图
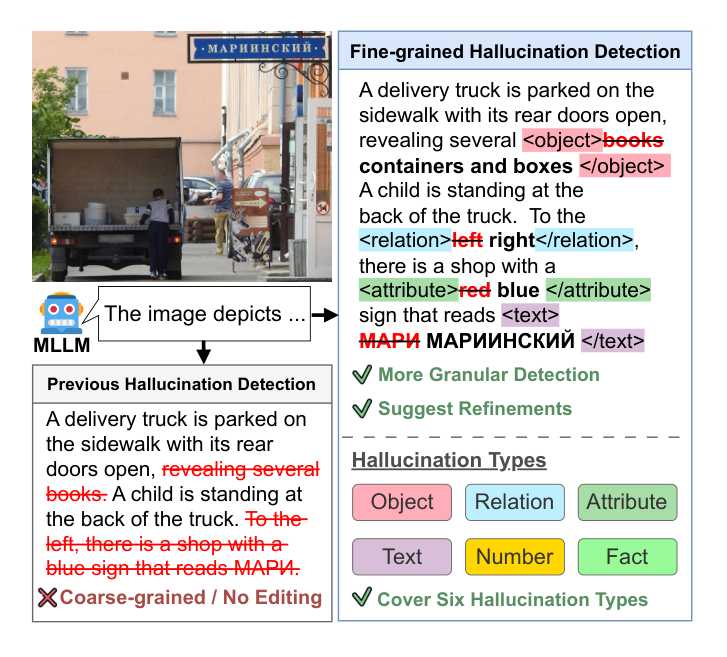
选图说明:该论文全文只有 4 张图(Fig.1 任务总览 p1、Fig.2 图式合成数据生成流程 p4、Fig.3 定性结果 p7、Fig.4 标注界面 p12),没有单独画出 detector/reviewer 两阶段网络结构图。因此这里选用 Fig.1 作为”整体系统图”:它给出了整条系统链路(图像 + MLLM 生成描述 → 细粒度检测面板 → 六类错误类型调色板 → refinement 建议),并与左上角”Previous Hallucination Detection(粗粒度、无编辑)”对照;Fig.2 则是数据侧的 Error Insertion / Graph-based Augmentation 流程。
3. 研究动机
- 现有做法的缺陷:作者明确批评已有 MLLM 幻觉检测”primarily focused on coarse-grained detection”,往往只分几大类(如只关注物体幻觉,见 POPE、AMBER 一类工作),并且”typically detect hallucinations at the sentence level or across relatively long spans”,这限制了细粒度错误分析的能力。论文举了 Fig.1 的卡车图为例:粗粒度方法最多把”revealing several books”整段标为幻觉,而真正有用的分析需要指出错在
books这个词、属于object类型、应改成”containers and boxes”。 - 本文的关键观察/假设:一是检测任务应当为后续编辑服务——“replacing the detected spans should be sufficient to correct the hallucination”,而已有的 token 级定位方法(如 HalLocalizer)不保证只改被检测到的 token 就能纠正句子。二是既有单阶段打标签范式(FAVA 等)让模型逐词复制原句并同时决定开/闭标签位置,存在三重困难:必须逐字复现原句、必须逐 token 同时判断标签位置、以及自回归的 exposure bias 使”a single mistake can compromise the structural consistency of the entire output”。
- 指标缺陷:作者指出 CLIP-S、FactScore 这类句级指标把编辑后文本与未编辑内容编进同一个句嵌入,”often overlook the impact of small edits, as unchanged portions dominate”,因此本文另提出基于片段嵌入相似度的 BERT-F1 与 CLIP-F1(用 BERTScore / CLIPScore 作为相似度函数计算 precision/recall 的调和平均)。
- 数据缺口:AMBER、M-HalDetect 等只有粗粒度(二/三分类)标注,UniHD 等缺少片段级 ground-truth refinement,而文本域细粒度数据集又”do not cover image-grounded hallucinations”。
4. 研究方法
- 总体流程(两阶段解耦):由 detector MLLM M_det 与 reviewer MLLM M_rev 组成。先用 {x_desc, x_img, x_ref} 构造 prompt p_det(few-shot 时再加 n 个示例),送入 M_det 得到幻觉片段 {h_text} 与错误类型 {h_error};随后对每个片段用确定性函数 T 生成带标签序列 z_i = T(x_desc, h_text, h_type),即”把 token copying 交给确定性函数”,使语言模型只需专注检测本身;最后 z_i 连同图像、参考描述送入 M_rev,输出最终的 ŷ_text 与 ŷ_type,编辑设定下再额外产生 ŷ_edit,即 ŷ = M_rev(z_i, x_img, x_ref)。作者的”central strategy”就是显式分离 token 复制与幻觉检测/编辑两种职责,”reducing the complexity of each reasoning task”。
- 训练细节:detector 与 reviewer 均用 Qwen2.5-VL-72B-Instruct 初始化,损失函数为 cross-entropy(微调,非免训练)。few-shot 采用 3-shot,prompt 设计沿用 FAVA 一脉(附录 H 给出完整模板)。
- 合成数据:Error Insertion(EI)模块:由于图像描述领域缺少”保证事实正确”的 seed 文本,作者改用 VisionHall 中被标注者判定为无幻觉的 MLLM 描述作为 seed,再用 o3-mini 按六类注入错误,并显式输出 XML 以表达错误之间的层级依赖。论文把”inter-error dependency”定义为两个及以上幻觉片段之间的因果/指代关系——例如 MLLM 先提到了图里并不存在的 “apples”,随后因自回归特性就会连带产生关于这些苹果的错误关系(引用 snowballing 工作 [58]);注入后还会再校验依赖一致性,因为作者发现注入的错误常挂到不存在的片段上。
- 合成数据:Graph-based Augmentation(GraphAug)模块:为插入的错误构建有向图,检测并删除环(删除后代节点)得到 DAG,再以概率 p 随机选节点并连同其后代一起剪枝,从而生成类型与组合各异的训练样本。附录 Table 6/7 给出图结构与剪枝策略(degree-based 剪枝 d<2、随机剪枝 p=0.25、原始 ZINA)的消融。
- 评测指标:检测用 F1;编辑用句级 CLIP-S、PAC-S;并自提片段级 BERT-F1(DeBERTa 嵌入)与 CLIP-F1。
5. 实验结果
- 基座模型(VisionHall 上的 baseline,均按论文原样列举):LLaVA-1.5-7B、LLaVA-1.5-13B、Qwen2-VL-7B、LLaVA-OV-Qwen2-7B、LLaVA-NeXT-Qwen-32B、LLaVA-OV-Qwen2-72B、Llama-3.2-90B-Vision-Instruct、Qwen2.5-VL-72B-Instruct、GPT-4o(含 w/o images 版本);ZINA 自身用 Qwen2.5-VL-72B-Instruct / Qwen2.5-VL-32B / LLaVA-OV-72B 作 backbone 消融。数据生成侧另用 o3-mini。MHaluBench 评测沿用 Chen et al. 的 Gemini-based Self-Check、GPT-based Self-Check、Gemini-based UniHD、GPT-based UniHD。
- 数据集与基准:VisionHall(自建:检测子集 6,854 条描述 / 4,759 图 / 211 标注者,编辑子集 20k 合成样本)、域外 MHaluBench 的 Image-to-Text 子集、以及 HalLoc(附录 Table 10);参考描述取自 DCI dataset,生成描述来自 12 个 MLLM(GPT-4o、Qwen2.5-VL 7B/72B、LLaVA-NeXT、LLaVA-1.5、MultimodalGPT、Qwen-VL-Chat、ShareGPT4V、InstructBLIP、InternVL、BLIP2、GIT)。
- 关键结果:
- VisionHall 检测 F1:45.15 vs GPT-4o 29.37(+15.78 点);相比 Llama-3.2-90B-Vision-Instruct 的 16.92 高出 28.2 点(论文原话 “achieving gains of 28.2 and 15.8 points”)。编辑:BERT-F1 44.02、CLIP-F1 50.39、CLIP-S 66.08、PAC-S 74.36,较最优基线分别提升 19.14 / 19.33 / 0.34 / 0.37 点。
- 域外 MHaluBench(Image-to-Text):claim-level Hijacking 类 Micro-F1 87.15、Accuracy 85.39、Macro-F1 83.07;segment-level 分别为 91.46 / 88.06 / 85.80,在 claim-level 的 10 项指标中赢 9 项、segment-level 赢 8 项。最强基线 GPT-based UniHD 在 claim-level 为 83.89 / 81.63 / 81.52。
- 消融(Table 5):去掉 reviewer、退化为单 MLLM 联合生成(Model (i))时检测 F1 掉 23.24 点,编辑任务 BERT-F1 / CLIP-F1 / CLIP-S / PAC-S 分别掉 28.48 / 32.51 / 2.76 / 2.67 点;换 backbone 为 Qwen2.5-VL-32B 掉 12.60 点 F1,LLaVA-OV-72B 只有 34.41;few-shot 从 n=2 提到 n=3 再涨 0.94 点 F1。作者结论是性能提升主要来自”合成数据 + 两阶段生成策略”的组合,而非单一组件。
- 对比方法:POPE、AMBER、MHalDetect、UniHD、HalLocalizer / Halloc、FAVA(prompt 被改造后作为统一 baseline)、SelfCheckGPT,以及上表所列 9 个通用 MLLM 与 GPT-4o。
6. 论文结论
- 作者自述贡献:(i) 提出面向 MLLM 的细粒度幻觉检测与编辑新任务;(ii) 提出 ZINA 方法;(iii) 构建 VisionHall 半合成数据集(12 个 MLLM 生成、人工按分类法标注片段);(iv) ZINA 在 VisionHall 与 MHaluBench 上均超过现有方法。
- 局限与未来工作:论文 Limitation 原文承认两点:其一”the two-stage architecture results in relatively high inference time, which may hinder deployment in real-time or resource-constrained settings”;其二”our method often underdetects hallucinations. This may stem from limitations in the reviewer MLLM, which tends to be overly conservative in generating tags.”(即漏检、审查器过于保守)。论文未明确给出未来工作方向。
[32] ICLR2026 — Dynamic Multimodal Activation Steering for Hallucination Mitigation in Large Vision-Language Models
- 会议:ICLR 2026(arXiv 录用说明:Accepted by ICLR 2026)
- arXiv:2602.21704 — https://arxiv.org/abs/2602.21704
- 本地 PDF:
ICLR2026-Dynamic Multimodal Activation Steering for Hallucination Mitigation in Large Vision-Language Models.pdf - 一句话定位:发现”真实性”与”视觉感知”由不同注意力头承担、且真实性引导向量随语义漂移,于是免训练地在推理时按语义检索向量并只干预 top-K 头。
1. 中文摘要
论文对 LVLM 的激活模式做系统分析,得到两个关键发现:其一,真实性(truthfulness)与视觉感知(visual perception)能力主要激活模型中不同的注意力头子集——在 LLaVAv1.5 上分析 3,000 条来自 SEED 与 AMBER 的样本后发现,真实性相关激活差异集中在 layer 30,而视觉感知差异集中在 layer 31;其二,真实性引导向量(steering vector)在不同语义语境下差异显著,把数据分成四个语义簇后用 t-SNE 可视化可见清晰分离,说明静态干预不足。基于此作者提出 DMAS(Dynamic Multimodal Activation Steering),一种免训练方法:第一步构造”基于语义的真实性引导向量数据库”——在语义簇内构造同图的有幻觉/无幻觉答案对,用 A_pos − A_neg 的簇内均值(经 PCA 去噪)得到每个簇的向量,以簇中心句嵌入为 key、向量为 value 存入 key-value 数据库;第二步计算视觉感知引导向量——把原图与加噪图(前向扩散过程扰动)分别配以 YOLOv11 检出物体/随机替换物体的模板描述,取激活差 A_v − A_v′ 并经 PCA;第三步在推理时用输入问句嵌入与各 key 的余弦相似度动态检索最相关的真实性向量,再把它与视觉感知向量按 α/β 加权、通过二值掩码只施加到激活差异最大的 top-K 个注意力头上(改写注意力输出在 W_o 之前的拼接结果)。实验在 LLaVAv1.5 与 QwenVL 上覆盖 MME、POPE、CHAIR 等判别式与开放式基准,MME 总分提升 94.66,CHAIR 句级幻觉下降 20.2。
2. 方法图
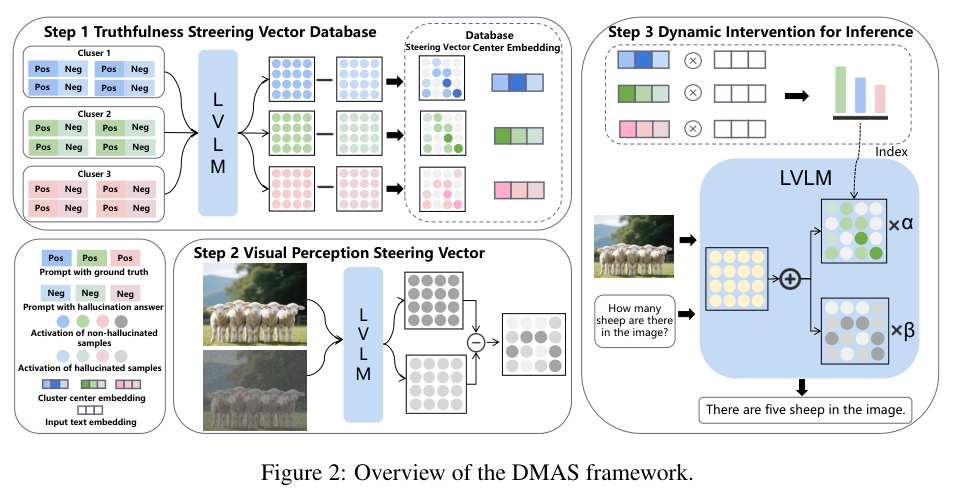
选图说明:captions.json 中只有 Fig.1(激活差异可视化)、Fig.2(框架总览)、Fig.3(超参数影响)三张候选;我逐一查看后确认 Fig.2(第 4 页) 是真正的方法总览图——它用三个面板分别画出 Step 1 真实性引导向量数据库(Pos/Neg 成对样本 → LVLM → 数据库)、Step 2 视觉感知引导向量(羊群原图 vs 加噪图 → 差向量)、Step 3 推理时动态干预(向量检索 index → LVLM 注意力头 ×α/×β → 输出”There are five sheep in the image.”),含模块框、箭头与数据流,且完整未截断。Fig.1 是热力图/散点图,Fig.3 是超参曲线,均非方法图。
3. 研究动机
- 现有做法的缺陷:作者把已有方法分三类并逐一指出问题——(a) 训练类(LRV 的高质量指令微调数据、RLHF-V 的强化学习)”requirements for carefully curated data and substantial computational resources, as well as the need to retrain models separately for different architectures”;(b) 解码类(VCD、ICD)虽免训练,但”often compromise the quality of the generated content”;(c) 激活干预类中,ICT 只做图像—物体跨层干预,”primarily focuses on visual-level interventions, neglecting the multimodal characteristics of LVLMs”,而 VTI 虽同时干预视觉编码器与 LLM 隐状态,却”employs fixed steering vectors regardless of input variation”,忽略不同输入的语义差异。
- 本文的关键观察/假设 1(头级分工):真实性头与视觉感知头基本不重叠——Fig.1a 中真实性激活差异”appear predominantly in layer 30”,Fig.1b 中视觉感知差异”concentrate in layer 31”,因此可以对两类能力做互不干扰的定向干预。
- 本文的关键观察/假设 2(向量随语义变化):把数据切成 4 个语义簇分别算激活差并用 t-SNE 投影,观察到”a clear separation between clusters”,说明真实性方向向量随语境显著变化,”a static intervention approach would be insufficient”。
- 任务背景:真实性与视觉感知两类能力需同时处理,作者据此设计”真实性向量(纠偏语言先验)+ 视觉感知向量(增强看图的注意力)”的双干预。
4. 研究方法
- Step 1 真实性引导向量数据库(Truthfulness Steering Vector Database):数据源为 AMBER 与 SEED,按语义分成 4 个簇。因两数据集的题目是判别式/选择题,构造幻觉答案很方便(判别题取反、选择题随机选错误选项),每个簇 C_i 内含 (T, V, Y_pos, Y_neg)。把 (V, T+Y_pos) 与 (V, T+Y_neg) 分别喂入 LVLM,取每层最后一个 token 的注意力头激活 A_pos、A_neg,簇级向量为 D_i = (1/|C_i|) Σ _ {j∈C_i} (A_pos,j − A_neg,j)(式 1),再用 PCA 去噪、提取影响真实性的主成分。数据库以各簇问题的平均嵌入为 key、D_i 为 value;key 与输入文本嵌入均由 sentence transformer(all-mpnet-base-v2)得到。
- Step 2 视觉感知引导向量(Visual Perception Steering Vector):对图像 V 加噪(按前向扩散过程)得到失真图 V′;用 YOLOv11 检出图中物体 O,填入模板 “The image depicts {objects}” 得 Y_O;再从预定义物体库中随机选同类别但不存在的物体 O′ 填入得 Y_O′,提示词固定为 “Please describe this image.”。把 (V, T+Y_O) 与 (V′, T+Y_O′) 分别输入模型取末 token 激活,定义 D_v = A_v − A_v′(式 2),同样用 PCA 提取与视觉感知最相关的主成分。
- Step 3 推理期动态干预:用输入文本嵌入与数据库各 key 的余弦相似度做检索,D_f = D_î, î = argmax_i sim(E(T), Key_i)(式 3)。随后用二值掩码 M_f、M_v 只对 D_f、D_v 中差异最大的 top-K 个注意力头置 1(式 4),并把式 5 改写为:x^(l+1) = x^(l) + Concat _ {0∼H}[ Attn^(l,h)(x^(l)) + α·M_f^(l,h)·D_f^(l,h) + β·M_v^(l,h)·D_v^(l,h) ] · W_o^(l),其中 α、β 分别控制真实性与视觉感知的干预强度。全流程免训练,仅在推理时改注意力输出。
- 超参与实现:α、β ∈ {0.5,1,2,…,10},K ∈ {32,64,128,256,512,1024},网格搜索;temperature=0、top_p=1;实验在 NVIDIA RTX 4090(48GB) 上完成。簇数量在 {2,3,4,5} 中搜索,最终 4 个簇最优。
5. 实验结果
- 基座模型:LLaVAv1.5 7B(Liu et al., 2024c)与 QwenVL 7B(Bai et al., 2023)。附录另报告”more models”与不同解码策略(beam search / nucleus sampling / greedy)下的结果。
- 数据集与基准:判别式任务 MME(取 existence / count / position / attribute 四个幻觉子集,指标为 accuracy + accuracy+ 之和)、POPE(MSCOCO 与 GQA,random / popular / adversarial 三种采样,报告 Accuracy/Precision/Recall/F1 的三设置平均)、开放式生成 CHAIR(MSCOCO 500 张图,句级 CHAIRS 与图级 CHAIRI);泛化性实验用 ScienceQA、ViQuAE;附录另用 MMVP、MM-Vet、IllusionVQA、HallusionBench(multimodal subset)、AMBER、PHD。构建引导向量所用数据为 AMBER + SEED。
- 关键结果:
- MME:LLaVAv1.5 总分 565.33 → 659.99(+94.66),QwenVL 587.33 → 633.33(+46);LLaVAv1.5 上比 SOTA 方法 ICT(649.10)高 10.89 分,QwenVL 上比 VAF(628.33)高 5 分。
- CHAIR:CHAIRS 51.0 → 30.8(下降 20.2),CHAIRI 15.2 → 11.4;句级比 SOTA 的 VTI(35.8)再低 5 点,图级与 VTI(11.1)持平。
- POPE:MSCOCO 上 LLaVAv1.5 准确率 81.38 → 86.81(+5.43)、F1 79.65 → 86.79(+7.14);QwenVL 83.71 → 87.63、F1 81.70 → 87.65;GQA 上 LLaVAv1.5 78.33 → 85.27、F1 79.13 → 85.63,QwenVL 77.47 → 84.40、F1 76.06 → 84.32。
- 消融(Table 4,LLaVAv1.5):两个向量缺一不可——只用真实性向量(w/o visual vector)CHAIRS 34.2 / CHAIRI 11.7、POPE 81.67 / 82.42;只用视觉感知向量(w/o truthfulness vector)CHAIRS 42.4 / CHAIRI 13.2、POPE 81.40 / 82.01;两者都不用(w/o both)CHAIRS 51.0 / CHAIRI 15.2、POPE 75.08 / 76.06;全用为 CHAIRS 30.8 / CHAIRI 11.4、POPE 81.70 / 82.47。
- 动态 vs 静态(Fig.4):把所有真实性向量合并成单一固定向量时提升更小,甚至在 QwenVL 的 Position 子任务上低于原模型,说明动态检索的必要性。
- 泛化性(Table 5):ScienceQA 准确率 LLaVAv1.5 52.75 → 62.27、QwenVL 46.41 → 48.04;ViQuAE 43.38 → 56.00、50.09 → 54.08。更多基准(Table 9):MMVP 30.3 → 54.3、HallusionBench 50.2 → 53.7、IllusionVQA 32.6 → 35.2、MM-Vet 38.9 → 39.3(QwenVL MMVP 41.0 → 43.3)。
- 对比方法:ICT、AGLA、VAF、VTI、DECO、DAMO、VCD、OPERA。
6. 论文结论
- 作者自述贡献:(1) 系统分析 LVLM 激活差异,证明真实性与视觉感知作用于不同注意力头子集,并用可视化说明真实性向量随语义显著变化,从而论证动态干预的必要性;(2) 提出免训练的 DMAS——语义化真实性向量数据库 + 视觉感知向量 + 推理期按语义相似度动态选择并施加于最关键注意力头;(3) 在多模型、多基准(判别式 + 开放式生成)上验证有效性:MME 总分提升 94.66、CHAIR 幻觉下降 20.2%,优于现有 SOTA。
- 局限与未来工作:论文没有独立的 Limitation / Future Work 章节,未明确说明自身局限。可核查的相关表述来自超参分析:α、β 或 K 取值过小时几乎无提升,过大时”F1 score shows a precipitous decline, indicating that the model’s fundamental capabilities become impaired”,即方法对干预强度敏感、需网格搜索;此外论文报告在 25%~100% 数据规模下性能几乎不变(Table 10),说明对数据量不敏感。
[33] ICLR2026 — Hallucination Begins Where Saliency Drops
- 会议:ICLR 2026(arXiv 录用说明:Accepted in ICLR 2026)
- arXiv:2601.20279 — https://arxiv.org/abs/2601.20279
- 本地 PDF:
ICLR2026-Hallucination Begins Where Saliency Drops.pdf - 一句话定位:用”注意力×梯度”的 saliency 指标发现幻觉发生在”前序输出 token 对下一个 token 显著性骤降”时,并用拒绝采样 + 局部一致性强化在推理期修补。
1. 中文摘要
论文指出既有基于注意力动态的幻觉检测方法只依赖前向传播的注意力图,”without capturing how changes in input tokens influence the final output”,因而难以稳定区分正确与幻觉输出——从 Figure 1 的注意力图里几乎看不出正确 token(wallpaper)与幻觉 token(blue)的差别。受”Label Words”信息流视角启发,作者提出 LVLMs-Saliency:把每一层每个注意力头的注意力权重与其对损失的梯度做 Hadamard 积、再保留下三角(tril)以维持因果结构,并按头平均后做 ℓ2 归一化,从而量化”每个已生成输出 token 对下一个 token 预测的影响力”。分析得到一个决定性模式(Pattern 1):当前序输出 token 对下一个 token 的显著性很低时,幻觉就会出现,意味着上下文记忆保持失效;作者还报告在 500 个样本上提示词(prompt)显著性虽有差异但并不显著影响预测准确率,因此不是幻觉主因。基于此提出双机制推理期框架:SGRS(Saliency-Guided Rejection Sampling) 在自回归解码时对 top-K 候选逐个算显著性,若低于由最近 W 个输出 token 均值缩放得到的自适应阈值 τ(P) = α·mean 就丢弃并重采样,全部被拒时回退到显著性最高的候选,从入口挡住”破坏连贯性”的 token;LocoRE(Local Coherence Reinforcement) 是即插即用的前向模块,对当前 query 到最近 w_s 个输出 token 的注意力权重乘以距离感知增益 γ = 1 + β·I((P−j) ≤ w_s),强化对近期输出的依赖。二者在每一步解码中顺序执行构成闭环。实验在 LLaVA-1.5、Qwen2-VL、Qwen2.5-VL、InternVL 等多个模型上验证了幻觉下降与通用能力保持。
2. 方法图
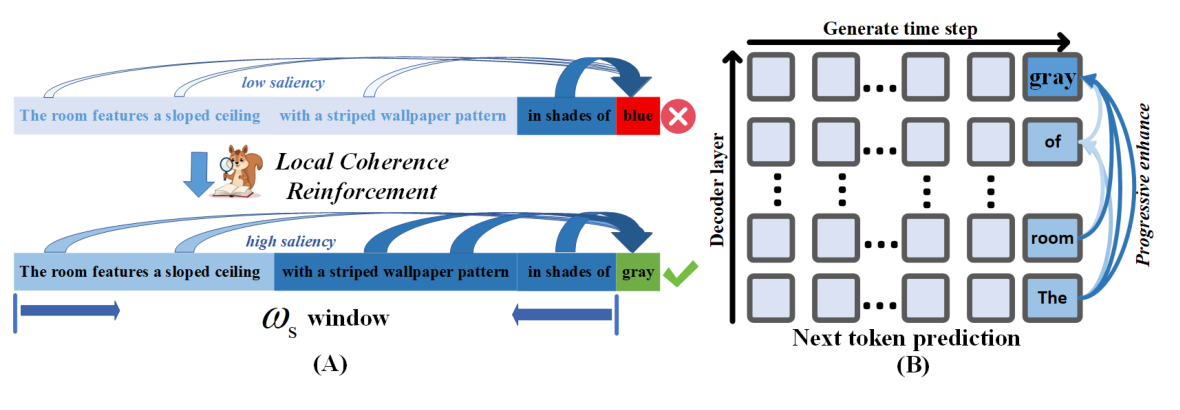
选图说明:三张候选图我逐一用 read_image 看过——Fig.1(p2)是”注意力图 vs 显著性图”的四张三角热力图对照,Fig.2(p3)是显著性随距离衰减的曲线/热力图,Fig.3(p8)是加 LocoRE 前后的显著性热力图,全部属于热力图/现象图,不含模块框与算法流程,按说明书要求换图。本文正文没有框架总览图,唯一的模块结构图是附录第 15 页的 Figure 7(LocoRE 结构,含 (A) 低显著性导致 blue 幻觉 token → Local Coherence Reinforcement → 高显著性输出 gray,(B) 解码层 × 生成时间步的网格与 “Progressive enhance” 箭头),我用 PyMuPDF 从 PDF 第 15 页重新裁剪并亲眼确认图像完整、含 (A)(B) 两个面板、未截断且不含正文。注意该图只覆盖 LocoRE 这一支,SGRS 在原文中以 Algorithm 1 形式给出、没有配图。
3. 研究动机
- 现有做法的缺陷:作者认为注意力分析类工作(OPERA、DOPRA、PAI、FastV、EAH、TAME、Farsight 等)虽然揭示了”注意力汇(attention sink)”与幻觉的关系,但”the relationship between attention maps and hallucinated tokens remains inadequately explained”,原因是”attention maps only reflect the model’s decision-making in the forward pass, without capturing how changes in input tokens influence the final output”,并且”existing methods often overlook gradient information, which is essential for understanding the interdependencies among different tokens”。作者同时指出该领域的可解释性不足——缺少对自回归生成中幻觉成因的清楚解释。
- 本文的关键观察/假设(Pattern 1):”Hallucinations occur when prior output tokens shows low saliency to the next token.” 生成正确 token 时模型对前面相关 token 保持高显著性、上下文连贯;幻觉则发生在模型”忘掉”了过去上下文、token 之间依赖变弱时。作者进一步用统计验证支撑:在约 12,000 个 token 上,正确 token 的平均显著性显著高于幻觉 token(如 LLaVA-v1.5-7B 0.472±0.136 vs 0.193±0.087),且按显著性分箱后”幻觉率随显著性升高单调下降”(最低区间 [0.0,0.1) 的幻觉率 68%–76%,最高区间 [0.9,1.0] 降到 18%–28%)。
- 排除项:作者特别说明提示词与图像 token 的显著性也有差异,但 500 样本分析显示”these saliency scores do not significantly affect the model’s predictive accuracy”,故不算幻觉主因——这也是他们与”干预图像注意力”路线(EAH、PAI 等)的分野:本文”focus exclusively on the dynamics of output token saliency”。
- 任务背景:目标是给出既有效又可解释、且免训练的推理期方案,且不改变模型内部表示以免损伤输出多样性。
4. 研究方法
- 诊断指标 LVLMs-Saliency:对输入序列 x 取模型输出 (y, {A^(l,h)}, s),以交叉熵损失 L(y,s) 对注意力矩阵求梯度 ∇_A^(l,h),再做逐元素积并保留下三角:S^(l,h) = tril(|A^(l,h) ⊙ ∇_A^(l,h)|)(式 4),层内跨头平均后 ℓ2 归一化得 S̄^(l)(式 5)。它是无监督、token 级的”接地强度”度量,量化前序输出对下一个 token 的影响。
- SGRS(Saliency-Guided Rejection Sampling):位置 P 上取 top-K 候选 C^(P),对每个候选 c_i 计算显著性 S(c_i) = (1/(|L_target|·|J|)) Σ _ {l∈L_target} Σ _ {j∈J} S̄^(l) _ {P,j}(式 6),其中 L_target 是选定的中深层,J = {j | SysL + ImgL ≤ j < P} 只覆盖”已生成的输出 token”位置(LLaVA-1.5 取 SysL=35、ImgL=576)。接受条件为 S(c_i) ≥ τ(P),自适应阈值 τ(P) = α · (1/|H|) Σ _ {j∈H} S(x_j),H 为最近 W 个输出 token(式 7),α∈(0,1) 控制”当前候选显著性要达到历史平均的多少倍”。若 R 轮内全部候选被拒,则回退选择原候选中显著性最高者。SGRS 在 token 进入序列之前就把低显著性候选拦下,防止级联幻觉。
- LocoRE(Local Coherence Reinforcement):在位置 P 预测 P+1 时,对 J_P = {j | SysL + ImgL ≤ j < P}(历史输出位置)定义距离加权增益 γ_j^(P) = 1 + β·I((P−j) ≤ w_s)(式 8),并把注意力矩阵从 query P+1 到这些 key 的子块整体乘以该增益(式 9/10),再进入 softmax 与加权求和。它”operates purely on the attention structure — no gradient computation or model parameter modification is required”,是前向、即插即用、免训练的模块。
- 协同工作流:每一步解码中 SGRS 先按对前序输出的显著性筛出当前 token x_P,LocoRE 再修改下一次前向(位置 P+1)的注意力权重以强化对近期 token 的依赖,形成”入口把关 + 事后稳定”的闭环。超参:α 控制 SGRS 敏感度、W 为历史窗口、w_s 为局部窗口、β 为强化强度;推荐 α=0.6(LLaVA-1.5 用 β=0.15、Qwen2-VL 用 β=0.20)。
5. 实验结果
- 基座模型:LLaVA-v1.5-7B / 13B、Qwen2-VL-7B、Qwen2.5-VL-7B / 32B、Intern-VL-7B / 13B(表 1 的 baseline 为 LLaVA-1.5-7B)。
- 数据集与基准:幻觉基准 POPE、CHAIR;综合基准 LLaVAW(LLaVA-Bench in the Wild)、MM-Vet、MME;通用 VQA 基准 VizWiz、ScienceQA。统计验证用 POPE 与 CHAIR(人工标注幻觉标签)。
- 关键结果:
- LLaVA-1.5-7B 上(Table 2,相对自身 baseline):CHAIRS 48.0 → 38.4(+LocoRE)→ 35.6(+SGRS+LocoRE,+12.4),CHAIRI 13.9 → 10.2 → 8.2(+5.7);POPE-R 87.0 → 89.5 → 89.8,POPE-F1 85.4 → 86.9 → 87.0,POPE-A 84.0 → 87.3 → 87.5;通用能力同时上升:LLaVAW 72.5 → 76.7(+4.2)、MM-Vet 30.5 → 36.0(+5.5)、VizWiz 48.5 → 54.9(+6.4)、SQA 65.5 → 67.8(+2.3)。
- 与 SOTA 同表比较(Table 1,LLaVA-1.5-7B,beam search baseline 为 CHAIRS 51.0 / CHAIRI 15.2 / POPE F1 85.4 / Acc 84.0 / MME total 565.34):SGRS+LocoRE 达到 CHAIRS 35.6、CHAIRI 8.2、POPE F1 87.0、Acc 87.5、MME total 668.33;相较之下 EAH 为 36.4 / 9.9 / 85.7 / 86.0 / 603.99,TAME 41.3 / 12.2,MemVR 46.6 / 13.0、POPE F1 87.1 / Acc 87.4、MME 648.30,Reverse-VLM 35.3 / 9.3。作者称其在 POPE 上达到 SOTA,在 CHAIR 类描述性数据集上仅次于 EAH。
- 跨模型泛化(Table 2):LLaVA-1.5-13B CHAIRS 47.2 → 39.8、CHAIRI 13.6 → 8.8、MM-Vet 36.1 → 42.0;Intern-VL-7B CHAIRS 46.6 → 34.4、CHAIRI 12.4 → 7.5、MM-Vet 31.2 → 35.0;Qwen2-VL-7B CHAIRS 25.0 → 19.3、CHAIRI 7.3 → 5.1、MM-Vet 63.2 → 67.7;Qwen2.5-VL-7B CHAIRS 27.2 → 21.0、CHAIRI 9.0 → 6.5。
- 超参消融(Table 3):完整设置(α=0.6,β=0.15)相比 baseline 使 CHAIR 幻觉率下降 28.3%(LLaVA-1.5)与 22.8%(Qwen2-VL);SGRS 单独(α=0.6,β=0.0)贡献了大部分提升,LocoRE 再带来增量(如 POPE F1 85.4% → 86.9%);α 提到 0.9 只能再小幅下降(CHAIRS 35.6 → 30.0)却要多付 33% 延迟(30.8 ms/token → 41.2 ms/token)并可能因过度拒绝损伤流畅度;β=1.0 时崩溃(CHAIRS 50.2、POPE F1 60.3)。
- ⚠️ 原文内部不一致(阅读时需留意):正文写 “We recommend α = 0.6, β = 1.2 as the optimal balance”,但 Table 3 的 caption 与表格数据显示 β=0.15(LLaVA-1.5)/ 0.20(Qwen2-VL)才是最优,而 β=1.0 时性能崩塌(CHAIRS 50.2、POPE F1 60.3)。我按表格数据(0.15/0.20)记录,β=1.2 疑为正文章节笔误。
- 统计与因果验证:正确 vs 幻觉 token 平均显著性 LLaVA-v1.5-7B 0.472 vs 0.193、Qwen2-VL-7B 0.664 vs 0.355、InternVL-7B 0.508 vs 0.224;人为按 r ∈ {1.0,0.8,0.6,0.4,0.2} 衰减正确 token 的显著性后,CHAIRs 从 35.6 单调升到 56.0,POPE-F1 从 87.0 降到 83.0,说明显著性下降会”诱发”幻觉。
- 对比方法:OPERA、DOPRA、DoLa、VCD、HALC、ICD、RITUAL、AGLA、SID、ONLY、CCA-LLaVA、Reverse-VLM、Vissink、EAH、TAME、MemVR、Farsight 等(Table 1 按”改解码 / 调 EOS 的 SFT / 调注意力头”三类归纳)。
6. 论文结论
- 作者自述贡献:(1) 提出无监督、基于梯度的 token 级指标 LVLMs-Saliency,并通过系统分析建立”低输出显著性 ↔ 幻觉”的直接因果联系(用显著性干预实验佐证);(2) 提出 SGRS——第一个按”候选 token 相对前序输出上下文的显著性”动态过滤的推理期机制,在被提交前就拒绝破坏连贯性的 token;(3) 提出 LocoRE——轻量即插即用模块,只在输出流内部强化当前 token 对最近 w_s 个前驱的注意力,不改跨模态注意力、不需梯度与参数更新。结论段还强调方法”without requiring model retraining”且”dynamically boosts visual attention and reinforces local coherence”。
- 局限与未来工作:论文明确报告两类局限。(1) 时延:完整框架(SGRS+LocoRE)因 SGRS 需要反向传播计算显著性,”typically adding 30–40% overhead per token compared to standard greedy decoding”,因此”less suitable for real-time applications”;作者建议实践中单独使用 LocoRE 作为折中(前向模块、延迟增加 <2%)。(2) 失败案例:存在高显著性的幻觉 token,原因有二——上下文无关的生成内容(”if the context itself is ambiguous or the input information is insufficient, the model may generate irrelevant content, which may not pass the SGRS filter”)与模型对错误答案过度自信(引用 Kalai et al. 2025 的 “The model will make mistakes with confidence”)。论文未给出专门的未来工作章节。
[34] ICLR2026 — Look Carefully: Adaptive Visual Reinforcements in Multimodal Large Language Models for Hallucination Mitigation
- 会议:ICLR 2026(arXiv 录用说明:ICLR 2026)
- arXiv:2602.24041 — https://arxiv.org/abs/2602.24041
- 本地 PDF:
ICLR2026-Look Carefully Adaptive Visual Reinforcements in Multimodal Large Language Models for Hallucination Mitigation.pdf - 一句话定位:指出”把全部视觉 token 塞回 FFN”会引入背景干扰,改用原型筛选 + 最优传输挑出真正对齐的图像块再注入。
1. 中文摘要
论文认为现有一类”视觉增强”式幻觉缓解方法(把视觉 token 重新注入解码器的 FFN)虽然免训练、开销小,但”typically inject all tokens indiscriminately”,会把背景区域里冗余或干扰性的语义一并带进来,使模型偏离关键线索。作者先用 LLaVA-1.5-7B 在 MSCOCO 上分析”隐状态与不同视觉 token 的相似度随解码层变化”,发现有效目标区域(patch 1、patch 2)的相似度始终更高,背景区域(patch 3)始终偏低,而原始图像 token 的相似度夹在两者之间,说明它会稀释显著线索。据此提出 AIR(Adaptive vIsual Reinforcement),一个免训练框架,包含两个组件:(1) prototype-based token reduction——以隐状态的均值作为视觉语义”原型” h_p,按到原型的 ℓ2 距离排序并只保留 TopQ 个 token,压掉冗余;(2) OT-guided patch reinforcement——把图像裁成多个 patch,将压缩后的隐状态与每个 patch 的 token 建模为离散分布,以 C_m(k,n) = 1 − cos(z_k, ẑ^m_n) 为代价矩阵、用 Sinkhorn-Knopp 求解熵正则最优传输,得到每个 patch 的聚合 OT 距离 d_OT(m),只把 d_OT(m) ≤ τ 的 patch 融合进 FFN 的视觉注入项。作者还证明 OT 选择比余弦距离选择具有严格更高的区分灵敏度。实验在 LLaVA-1.5-7B、Qwen-VL-Chat、GLM-4V-9B 上验证:CHAIR 幻觉率下降,POPE 在三种设置下准确率/F1 提升,MME/MMBench/LLaVA-Bench 等通用能力基本保持。
2. 方法图
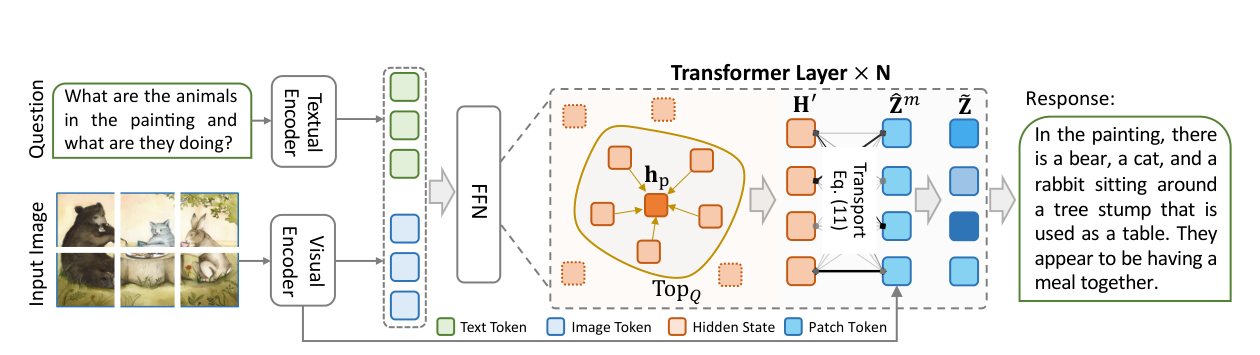
选图说明:候选图中 Fig.1(p2)是分析型多面板图(答案对比 / 层级相似度曲线 / 注意力热图 / 柱状图),Fig.3–5(p8)是超参曲线,均非框架图;Fig.2(p4) 是唯一的方法总览图,含完整数据流(Question/Input Image → Textual/Visual Encoder → FFN → Transformer Layer ×N 内的 h_p 原型与 TopQ 选择 → Transport Eq.(11) → Z̃ → Response)以及四类 token 图例,因此选它。该图由我用 PyMuPDF 从 PDF 第 4 页裁剪(去掉下方 caption 正文)并亲眼确认模块框、箭头、图例完整无截断。
3. 研究动机
- 现有做法的缺陷:作者把已有方法分为三类并逐一指出代价——训练类(用额外标注微调、跨模态对齐、偏好优化)”require costly annotations and heavy computation”;后处理类(如 LURE 一类轻量修订器)”increase flexibility but add system complexity”;推理期干预(logit shifting、对比解码)”providing efficiency but sometimes reducing stability”。而最近兴起的”解码期重注入视觉 token”路线(MemVR 等)虽然免标注、开销小,却被作者批评为”they typically inject all tokens indiscriminately”。
- 本文的关键观察/假设:视觉输入里存在大量干扰(背景区域含冗余物体或分散注意力的语义),把全部视觉 token 融合进解码过程会”distract the model’s attention from critical regions”。作者用 Fig.1 给出三重证据:(a) 对比两种注入策略——原始 token 注入(MemVR 式)导致模型关注无关背景而幻觉,只注入相关 token 则给出忠实答案;(b) 在 LLaVA-1.5-7B + MSCOCO 上分析隐状态与视觉 token 的逐层相似度,”effective target regions (e.g., patch 1 and patch 2) consistently yield higher similarity, whereas background regions (patch 3) remain low. The similarity of the original image tokens lies between, suggesting that they dilute the importance of salient cues.”;(c) 注意力热图显示既有重注入方法把注意力扩散到无关区域,而 AIR 聚焦在语义关键区。
- 任务背景/定位:目标是做一个既免训练、又不引额外模型与延迟的”即插即用”框架;论文同时强调 OT 相对余弦等逐点相似度能刻画分布的全局几何结构,因而更适合做 patch 级对齐判定。
4. 研究方法
- 总体流程:AIR 作用在每个 Transformer block 的 FFN 里,先把视觉 token 压缩成紧凑子集,再用 patch 级 OT 对齐挑出对齐良好的 patch,最后只把这些 patch 注入 FFN。作者依据”mid-to-deep 层对视觉—语言融合更关键”的既有结论,把操作层范围定在中深层(消融显示 24–32 与 26–32 最合适)。
- Prototype-based token reduction:标准 FFN 为 FFN(H) = φ(H W1) W2^⊤(式 5),全量重注入为 FFN(H|Z) = φ(H Z^⊤) Z(式 6),但视觉 token 长度 K 很大(LLaVA 中 K=576)带来冗余与噪声。作者计算原型 h_p = (1/K) Σ_k h_k 作为视觉语义的粗略概括,按 d(h_k, h_p) = ‖h_k − h_p‖₂(式 7)排序,”Tokens with larger distances encode more distinctive cues not captured by the global prototype”,只保留 TopQ 个 token 得到 H′(式 8)。
- OT-guided patch reinforcement:把图像裁成 M 个 patch {v̂_m} 与其嵌入 {Ẑ_m}(每个含 N 个细粒度 token)。将压缩后的隐状态与某 patch 的 token 视为离散分布 P(h) = Σ _ {k=1}^{Q} a_k δ(h_k − h) 与 Q_m(ẑ) = Σ _ {n=1}^{N} b^m_n δ(ẑ^m_n − ẑ)(式 9),其中权重取均匀 a=[1/Q,…]、b^m=[1/N,…],代价矩阵 C_m(k,n) = 1 − cos(z_k, ẑ^m_n)。用 OT 距离 d_OT(P, Q_m; C_m) = min _ {T_m≥0} ⟨T_m, C_m⟩(式 10)并用 Sinkhorn-Knopp 高效求解传输计划 T_m;聚合得到 d_OT(m) = Σ_k Σ_n T_m(k,n) C_m(k,n)(式 11)。OT 距离越小表示与原始图像对齐越强、patch 越关键,据此以阈值 τ 选择 M = {m | d_OT(m) ≤ τ}(式 12),把选中 patch 的嵌入拼接为 Z̃(式 13),最终注入形式为 FFN(H|Z̃) = φ(H W1) W2^⊤ + φ(H′ Z̃^⊤) Z̃(式 14)。
- 理论分析:作者把 OT 距离与均匀加权的余弦基线 d_cos(m) = (1/KN) Σ_k Σ_n C_m(k,n) 对比,证明 |d_OT(m1) − d_OT(m2)| > |d_cos(m1) − d_cos(m2)|(式 15,除 C_m1 = C_m2 的退化情形),原因是 OT 的自适应传输计划会优先匹配低成本(高余弦相似)对,从而放大语义对齐差异,而余弦的均匀平均会”dilute discriminative features”。
- 训练/推理策略:完全免训练(training-free)、不引入辅助模型,只在推理时修改 FFN 的视觉注入项;超参为保留 token 数 TopQ、OT 距离阈值 τ、参与 patch 数与熵正则强度 ϵ。
5. 实验结果
- 基座模型:LLaVA-1.5-7B、Qwen-VL-Chat、GLM-4V-9B。
- 数据集与基准:幻觉侧为 CHAIR(在 500 张随机采样的 MSCOCO 图上,主表最大生成长度 64)、POPE(MSCOCO / A-OKVQA / GQA,Random / Popular / Adversarial 三设置);通用侧为 MME(Hallucination 子集:Object-Level、Attribute-Level、Cognition)、MMBench、LLaVA-Bench(GPT-4V 辅助评测,10 分制);附录另有 HallusionBench、V* Bench、MMHal-Bench、MM-Vet 等。
- 关键结果:
- CHAIR(Table 1,64 token):LLaVA-1.5-7B CHAIRS 22.0 → 18.4(↓3.6)、CHAIRI 6.7 → 5.7(↓1.0);Qwen-VL-Chat 20.0 → 18.6、6.2 → 5.9;GLM-4V-9B 13.0 → 11.6、5.6 → 5.3,BLEU 基本持平。对比 VCD(CHAIRS 24.6,反而比 baseline 高 2.6)、MemVR 21.6、VAF 20.4。
- POPE(Table 2,LLaVA-1.5-7B):最难的低设置 Adversarial 准确率 75.0 → 83.9(+8.9)、F1 76.0 → 83.6(+7.6);Random 83.7 → 89.0、F1 83.0 → 88.2;Popular 78.2 → 87.1(+8.9)、F1 78.4 → 86.4(+8.0)。在 MSCOCO/A-OKVQA/GQA 上”achieves the best or near-best accuracy and F1-score”。
- 通用能力(Table 3/4):MME-Hall 总分 LLaVA-1.5 643.3 → 638.3(略降,MemVR 为 648.3),Cognition 357.8 → 372.5,MMBench 64.6 → 64.7;LLaVA-Bench GPT-4V 评分 Accuracy 5.59 → 5.83、Detailedness 4.72 → 5.12(Qwen-VL-Chat 5.85 → 6.18;GLM-4V-9B 6.76 → 6.93)。
- 层范围消融(Table 5):16-32 为 19.6、18-32 为 19.2、24-32 为 18.8、26-32 为 18.4、28-32 为 19.4、30-32 为 22.0(等于不干预),说明分层太窄(过晚)或跨度过大都变差。
- 组件消融(Table 6,LLaVA-1.5-7B,CHAIRS/CHAIRI):两者都不用 22.7 / 6.7;只开 OT 22.3 / 6.5;只开原型压缩 20.2 / 6.2;两者同开 19.8 / 5.8。⚠️ 注意正文叙述与表格行标签对不上(正文称”prototype-based token reduction reduces CHAIRs from 22.7 to 22.3”而”OT-based patch reinforcement alone achieves a larger improvement (22.7 to 20.2)”,恰好与 Table 6 的 ✗✓/✓✗ 两行互换),此处以表格数值为准并保留疑问。
- OT vs 余弦(Fig.6):OT 的边缘差分布更大(多数点位于 y=x 之上),定性上 OT 选出的 patch 更集中在与图像语义一致的关键区域。
- 效率(Table 7,单张 A100):AIR 平均延迟 2.07s(LLaVA-1.5-7B 为 1.68s、VAF 1.69s、MemVR 2.05s),显存 13.7G(baseline 13.5G),同时把 CHAIRS 从 22.0 降到 18.4、CHAIRi 从 6.7 降到 5.7。
- 对比方法:VCD(视觉对比解码)、MemVR(memory-space visual retracing,即”全量 token 重注入”的代表)、VAF。原文引言与相关工作另提到 LURE、ICD/logit shifting 等路线,但主实验直接对比的是以上三种。
6. 论文结论
- 作者自述贡献:提出 AIR(Adaptive vIsual Reinforcement)——把 prototype-based token reduction 与 OT-based patch reinforcement 结合,选择性地强化显著视觉线索、抑制冗余;在 LLaVA-1.5-7B、Qwen-VL、GLM-4V-9B 上验证可在保持多模态性能的同时显著降低幻觉;定位为”training-free and independent solution for building reliable MLLMs”。理论侧给出 OT 选择灵敏度严格优于余弦选择的命题。
- 局限与未来工作(论文有独立的 Limitations & Future Discussion 段落,照抄原意):(1) “its application to reasoning multimodal models and agents has not yet been explored”,即尚未在推理型 MLLM 与智能体场景验证,未来可把 AIR 扩展到这些更复杂推理的设置;(2) 由于 OT 在刻画分布差异上的优势,作者认为把 OT-based reinforcement 用于跨模态 grounding 与 alignment 是”a promising direction for future research”。此外论文提示主表在 MME-Hall 总分上相对 baseline 略有下降(638.3 vs 643.3),说明通用指标上的收益并非全面。
[35] ICLR2026 — SHIELD: Suppressing Hallucinations In LVLM Encoders via Bias and Vulnerability Defense
- 会议:ICLR 2026(arXiv 录用说明:ICLR 2026)
- arXiv:2510.16596 — https://arxiv.org/abs/2510.16596
- 本地 PDF:
ICLR2026-SHIELD Suppressing Hallucinations In LVLM Encoders via Bias and Vulnerability Defense.pdf - 一句话定位:把幻觉溯源到”视觉编码器”而非 LLM,用免训练的三招(token 重加权、噪声 token 相减、对抗扰动+对比解码)分别治统计偏置、固有偏置与脆弱性。
1. 中文摘要
论文指出以往工作大多盯着 LVLM 的 LLM 部分,而”this paper is the first to trace LVLM hallucinations to visual encoders”,并归纳出视觉编码器的三个问题:statistical bias(编码器过度强调预训练数据里高频的视觉模式,对应 token 的 L2 激活值异常高,从而扭曲细粒度感知)、inherent bias(对预训练数据中的”主导物体”产生与输入无关的错误表征,即便喂入无意义图像也会误报这些物体)、vulnerability(对噪声与微小扰动鲁棒性不足,轻微扰动就会产生不可靠特征)。为此提出 SHIELD,一个免训练框架,用三条策略对治:token re-weighting 先让原始 LVLM 生成一句 naive caption,用配对的 CLIP 文本编码器编码后与视觉 token 计算相似度矩阵,取每行最大值并归一化得权重 W_v,再以残差形式 x_v′ = x_v + x_v ⊙ W_v 重加权,把注意力分摊到更多与真值物体相关的 token 上以缓解统计偏置;token subtraction 用 K 个随机噪声(与图同尺寸)过同一视觉编码器取平均,估计出”主导物体的错误表征”并从 token 中减去,即 x_v″ = x_v′ − (1/K)Σ E(n_i),从而削弱固有偏置(该估计只依赖编码器参数,可预先算好);contrastive decoding 针对脆弱性:以可学习扰动 δ 优化 l_adv = cos(E(v+δ), E_t(c_naive)) 得到攻击张量 δ*,用 E(v+δ*) 产生”易致幻”的对抗 logits,再按 p = softmax[(1+α)·logit(x_v″) − α·logit(x̄_v)] 做对比解码,并加自适应合理性约束过滤低概率候选。实验在 LLaVA-1.5、InstructBLIP、Qwen-VL 三个模型族、CHAIR/POPE/MME/AMBER/LLaVA-Bench 等基准上验证降幻觉与通用能力提升。
2. 方法图
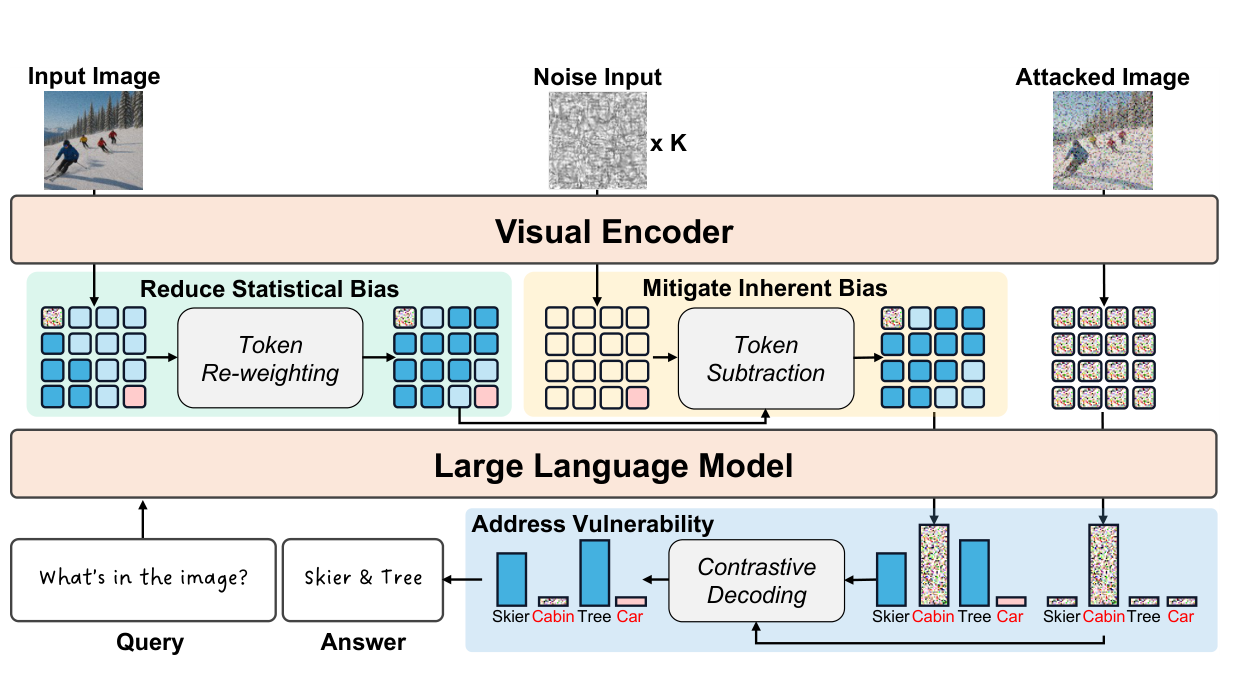
选图说明:候选 5 张中,Fig.1(p1,三种问题的示意)、Fig.4(p5,Token Re-weighting 单模块)、Fig.5(p5,Token Subtraction 单模块)、Fig.6(p6,Address Vulnerability 单模块)都只是局部示意,只有 Fig.3(p4)是把三路输入(Input Image / Noise Input ×K / Attacked Image)→ Visual Encoder → 三个治疗模块 → Large Language Model → Query/Answer 串起来的完整框架图,含模块框、箭头、token 颜色图例。我用 PyMuPDF 从 PDF 第 4 页重新裁剪(去掉下方 caption 正文)并亲眼确认三条支路、模块框与图例完整无截断。
3. 研究动机
- 现有做法的缺陷:作者把既有工作分为两类——训练类(CLIP-DPO 偏好优化、LURE 事后修订器、LLaVA-RLHF 强化学习)”demand substantial human and computational resources”;免训练类(VCD 对比自然/模糊图输出、OPERA 过信任惩罚、HALC 焦点对比解码、MARINE 借助外部视觉模型、VTI 隐空间引导)虽然高效,但”these approaches primarily focus on the LLM component, leaving the role of visual encoders underexplored”。
- 本文的关键观察(三条实证,对应 Figure 1/2):(a) 统计偏置:在 LLaVA-1.5 + POPE COCO 子集上统计,视觉 token 的 peak-to-average L2 ratio(最大范数 token 相对均值的偏离)越大,幻觉样本比例越高——“Stronger overemphasis leads to higher hallucination rates”;(b) 固有偏置:把无意义图像(随机噪声)喂给 LLaVA-1.5 并问 POPE COCO random split 的问题,模型频繁误报 car、chair、dining table 等预训练主导物体——“Dominant objects are more likely to be falsely perceived as present”;(c) 脆弱性:仅几步对抗攻击就使 LLaVA-1.5 在 POPE COCO 上的 F1 从 78.5 掉到 61.6,说明微小扰动即可产生不可靠特征。
- 任务背景/动机:作者主张幻觉的”源头”在编码器特征,因此干预点应放在视觉 token 上,并且要求方法免训练、可跨模型族使用。
4. 研究方法
- 推理形式化:视觉编码器 E(·) 把图像 v 编码为 N 个 token x_v = E(v)(式 1);LLM 依 logit(y_i | x_v, t, y _ {<i}) = LLM(x_v, t, y _ {<i})(式 2)产生 logits,softmax 后按解码策略取 token(式 3)。
- Mitigating Statistical Bias(Token Re-weighting):先用 vanilla LVLM 生成 naive caption c_naive = VanillaLVLM(v, “Please describe this image”)(式 4),用与 E(·) 配对的 CLIP 文本编码器 E_t(·) 得到 P 个 caption token(式 5);计算相似度矩阵 M = x_v c^⊤ / (‖x_v‖₂·‖c‖₂)(式 6),沿 caption 维取最大并归一化到 [0,1] 得权重 W_v = norm(max_j M _ {i,j})(式 7),最后以残差方式重加权 x_v′ = x_v + x_v ⊙ W_v(式 8)。作者强调即使 naive caption 本身含幻觉也不影响重加权,因为幻觉物体在相似度矩阵里匹配不到高相似度的视觉 token。
- Reducing Inherent Bias(Token Subtraction):取 K 个与图同尺寸的随机噪声 n_i 过编码器,平均后从统计偏置修正过的 token 中减去:x_v″ = x_v′ − (1/K)Σ _ {i=1}^{K} E(n_i)(式 9);由于固有偏置只取决于编码器参数,”the estimation of erroneous representations from noise inputs can be pre-calculated for each model to improve efficiency”。修正后的 token 与 query 一起送入 LLM 得 logit(y_i | x_v″, t, y _ {<i})(式 10)。
- Address Vulnerability(对抗攻击 + 对比解码):在图上加可学习扰动 δ,用对抗损失 l_adv = cos(E(v+δ), E_t(c_naive))(式 11)由梯度下降(学习率 l)最小化得到攻击张量 δ*(式 12)——注意是最小化余弦相似度以破坏图文一致性;推理时把 δ* 加到图上得易致幻表征 x̄_v = E(v+δ*)(式 13)与对抗 logits(式 14);再在每个解码步用 α 控制对比强度:p_shield(y_i) = softmax[(1+α)·logit(y_i | x_v″, t, y _ {<i}) − α·logit(y_i | x̄_v, t, y _ {<i})](式 15)。此外引入自适应合理性约束(式 16),只保留概率不低于最大概率 β 倍的 token,其余置零。
- 训练/推理策略:完全免训练;默认 α=2、β=0.35、K=32、l=0.02,跨三个 LVLM 通用;SHIELD 用基于采样的解码(从修改后的 post-softmax 分布采样),vanilla 与 VCD 也按各自原文采用采样解码、OPERA 用 beam search + logit 惩罚;全部实验在单张 RTX A6000 上完成。
5. 实验结果
- 基座模型:LLaVA-1.5、InstructBLIP、Qwen-VL(三个不同架构族)。
- 数据集与基准:CHAIR(COCO 2014 val 随机 500 张图,提示 “Please describe this image in detail.”,caption 截断至 512 token,报句级 CS 与实例级 CI);POPE(COCO / A-OKVQA / GQA × random / popular / adversarial);MME 幻觉子集与 MME 全集(10 个感知子任务 + 4 个认知子任务);AMBER(生成式 + 判别式,覆盖存在/属性/关系幻觉);LLaVA-Bench 的 GPT-4o 辅助评测(correctness C 与 detailedness D,0–10 分);另有 MMHal-Bench 与 GQA 等通用基准。
- 关键结果:
- CHAIR(Table 1):LLaVA-1.5 CS 48.8 → 36.6、CI 14.2 → 10.3;InstructBLIP 54.6 → 40.4、24.8 → 10.9;Qwen-VL 49.2 → 28.9、13.1 → 9.2,均优于 VCD(46.8/44.0/46.4)与 OPERA(44.6/46.4/34.6)。作者称在 LLaVA-1.5 上相对次优方法 OPERA “achieving up to 18% improvement”(44.6 → 36.6,约 17.9%)。
- POPE COCO(Table 3):LLaVA-1.5 平均 准确率 81.3 → 87.0、F1 79.6 → 87.4(Random 83.2 → 91.3、F1 81.3 → 91.1;Popular 81.8 → 87.4;Adversarial 78.9 → 82.5、F1 77.5 → 83.6);Qwen-VL 平均 83.6 → 87.0、81.6 → 86.6;InstructBLIP 平均 78.2 → 85.0、78.4 → 84.8,但作者说明其提升有限,因为”its Q-Former module constrains the use of modified visual features”。
- MME 幻觉子集(Table 4):LLaVA-1.5 总分 565.3 → 668.3,InstructBLIP 380.3 → 461.6,Qwen-VL 587.3 → 668.3(对应 VCD/OPERA 均低于该值)。
- AMBER(Table 5,LLaVA-1.5 7B):Amber Score 82.0 → 88.0(VCD 82.9、OPERA 86.5);CHAIR 9.2 → 6.4;Cover 41.3 → 46.1;Hallucination 29.2 → 25.1;Cognition 3.7 → 1.8;Accuracy 65.7 → 78.3、F1 73.2 → 82.4。
- MME 全集(Table 6,LLaVA-1.5):总分 1632.1 → 1810.8(Perception 1279.2 → 1473.0;Cognition 352.9 → 337.8,略降)。
- GPT-4o 辅助评测(Table 2):LLaVA-1.5 C 4.9 → 6.2、D 5.0 → 6.1;InstructBLIP 4.2 → 5.6 / 4.2 → 5.3;Qwen-VL 6.2 → 6.9 / 4.6 → 5.8。作者说明 detailedness 提升有限,因为方法治的是编码器偏置而非增强描述覆盖度。
- 模块消融(Table 7,CHAIR,LLaVA-1.5,CS/CI):Vanilla 48.8/14.2;仅加 adaptive plausibility constraint 反而 50.2/13.8(CS 变差,作者称其单独作用有限);+ address vulnerability 46.4/12.8;+ mitigate statistical bias 40.4/11.0;+ reduce inherent bias 36.6/10.3。作者特别指出”after addressing vulnerability, adding the statistical bias mitigation module yielded a further 13% reduction”。
- 效率(Table 8,CHAIR,单卡):Ours 36.6 的 CS、7.34 s/sample、18.17GB;Vanilla 48.8 / 2.59s / 15.69GB;VCD 46.8 / 4.89s / 16.52GB;OPERA 44.6 / 24.01s / 34.88GB。模块级(Table 9):Mitigate Statistical Bias 4.64s/16.56GB、Reduce Inherent Bias 仅 +0.04s/+0.81GB、Address Vulnerability 7.30s/18.17GB;caption 生成本身就要 2.05s。
- 对比方法:VCD、OPERA(主表直接对比);相关工作另提到 CLIP-DPO、LURE、LLaVA-RLHF、HALC、MARINE、VTI。
6. 论文结论
- 作者自述贡献:(1) 首次分析视觉编码器在 LVLM 物体幻觉中的角色,提出统计偏置、固有偏置、脆弱性三个问题;(2) 提出免训练的 SHIELD,用 token re-weighting 降统计偏置、token subtraction 减固有偏置、对比解码治脆弱性;(3) 在多基准、多 LVLM 族上验证降幻觉效果,并在通用基准(MME 全集)上也有提升,说明适用面广。
- 局限与未来工作:论文没有独立的 Limitation 章节,但明确写了两点未来工作:”Future work could explore the design of more robust visual encoders to further reduce bias and vulnerability, as well as the optimization of adversarial attack mechanisms to lower computational costs for real-time applications.”。此外正文与附录明确承认三类不足:InstructBLIP 因 Q-Former 限制导致增益有限;detailedness 提升有限;在需要图像之外外部知识的任务(Celebrity、Scene、Landmark、Artwork)以及简单视觉任务(Numerical Calculation、Text Translation、Code Reasoning)上改善有限甚至变差,作者归因于”contrastive decoding in SHIELD, which directs the LVLM to prioritize visual inputs over leveraging prior knowledge embedded in the LLM”。
[36] ICML2026 — Adaptive Residual-Update Steering for Low-Overhead Hallucination Mitigation in Large Vision Language Models
- 会议:ICML 2026(arXiv 录用说明:Accepted by ICML 2026; Code available at: https://github.com/Akko000/RUDDER-Residual-Update-Directed-DEcoding-Regulation-)
- arXiv:2511.10292 — https://arxiv.org/abs/2511.10292
- 本地 PDF:
ICML2026-Adaptive Residual-Update Steering for Low-Overhead Hallucination Mitigation in Large Vision Language Models.pdf - 一句话定位:从”必做的 prefill 前向”里零成本抽出视觉证据方向 CARD,再用 Beta 分布门控在解码时按 token 自适应地把它注回残差流,单次前向即降幻觉。
1. 中文摘要
论文从 LVLM 的生成机制出发:视觉输入是语言解码器的前缀,而随自回归生成推进,这份初始视觉信息会不可避免地”稀释(dilution / visual fading / attention decay)”,使模型转向依赖内部语言先验并产生物体幻觉——文中给出 LLaVA-1.5-7B 的典型例子:模型因 “surface” 的语言联想而凭空生成 “cup”。作者指出既有推理期干预(对比解码、迭代精修)的致命瓶颈是”typically require multiple forward passes (extra FWD) or external classifiers, incurring prohibitive latency costs”。RUDDER 的思路是”不去事后纠正漂移,而是结构性地防止视觉信息被稀释”:因为在必需的 prefill 阶段视觉信号在残差流中保留得最完整,所以用一个只读 hook 在目标层缓存每个 prefill token 的自注意力输出 Δ_i^l = A_i^l,池化后 L2 归一化得到每样本的视觉证据方向 CARD(Contextual Activation Residual Direction)向量 v_CARD,这个过程不需要任何额外前向。解码阶段则用 Beta Gate 做自适应门控:先算当前隐状态与 v_CARD 的余弦相似度 s_t,再由 Beta-Bernoulli 共轭后验形式给出 α_t = softplus(k·s_t + c)、β_t = softplus(−k·s_t + c)、g_t = α_t/(α_t+β_t),并 clamp 到 [g_min, g_max];最终注入 v_steer_t = (α_max·g_t)·v_CARD,加在自注意力子层输出之后、且只作用于答案 span。作者把这一门控理解为”信任机制”而非纠错器:与视觉证据一致的 token 加强注入,处理句法/非视觉 token 时抑制注入以保流畅。论文另给出去掉门控的静态变体 RUDDER-Add 作对照。实验在 LLaVA-1.5(7B/13B)、Idefics2、InstructBLIP、Qwen2.5-VL 上跨 greedy / beam search / nucleus sampling 三种解码验证:CHAIR 幻觉相对下降约 33.2%(句级)与 28.6%(实例级,作者在正文中报告的三模型平均),同时保持 96.0% 吞吐。
2. 方法图
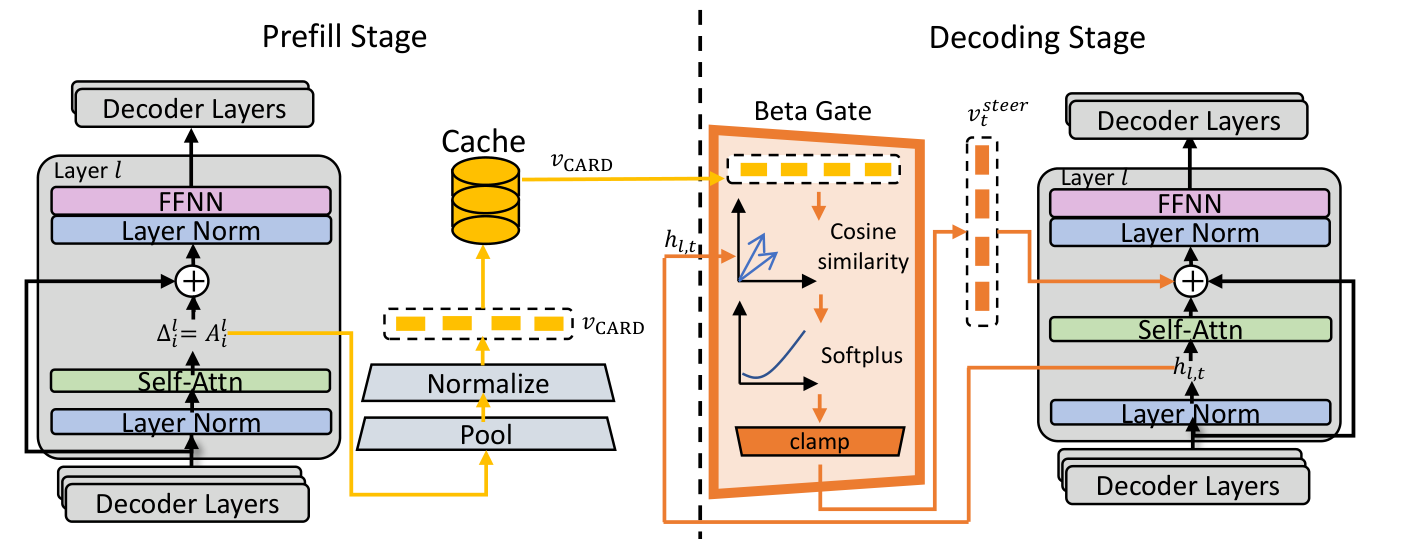
选图说明:候选 Fig.1(p2)左图是幻觉文本对照、右图是方法能力对比表;Fig.3(p8)是层数消融的柱状图;只有 Fig.2(p5)是完整的框架流程图——左侧 Prefill Stage 画出 Layer l 内 Δ_i^l = A_i^l → Pool → Normalize → Cache 的 v_CARD 抽取链路,右侧 Decoding Stage 画出 Beta Gate(Cosine similarity → Softplus → clamp)产出 v^steer_t 并注入残差流,含模块框与箭头。我用 PyMuPDF 从 PDF 第 5 页重新裁剪(保留 “Prefill Stage / Decoding Stage” 标题、去掉下方 caption 正文)并亲眼确认完整无截断。
3. 研究动机
- 现有做法的缺陷:作者把推理期干预(ITI)分成两类并分别指出代价。(a) 非 steering 类(作用于输出 logits 或解码策略):VCD 用扰动图构造负上下文、PAI 减去纯文本(unconditional)logits、MARINE 用 classifier-free guidance 风格、HALC 自适应焦点对比、AGLA 拼接全局与局部注意力、DeGF 用生成反馈自纠正——“often at the cost of significant latency due to extra forward passes”,其中迭代精修类开销更高;DoLa 对比深浅层 logits 抑制泛化文本;约束解码/事后编辑虽更省算力但”typically less adaptive”。(b) steering 类(直接改隐表示):ASD 远离预定义幻觉方向、VISTA 注入由激活差算出的信号向量,也”incur high computational costs on-the-fly”;VTI 试图把开销挪到离线预计算。
- 本文的关键观察/假设:在 prefill 这一步视觉与文本的融合处于峰值,”the residual update from the self-attention sublayer, therefore, encodes the net effect of the visual context on the representation of each text token”;把这些更新在 prefill span(图像 token + 文本提示 token)上聚合,就能得到该样本专属的、稳健的视觉证据方向。作者报告实证支持:抽出的 CARD 向量相对纯文本(语言先验)方向形成系统性的、以图像为条件的旋转,且该旋转与下游 steering 机制方向一致,说明聚合得到的是有意义的定向信号而非随机噪声(细节在附录 A.4)。作者还分析了 LLaVA-1.5-7B 的内部动态,发现干预越靠后的解码层对最终输出影响越大。
- 任务背景/定位:作者明确界定干预范围——RUDDER 作用在隐残差流而非最终 logit 分布,”its objective is therefore not to provide a formal guarantee on the token-level likelihood, but to preserve and reassert an input-specific visual evidence direction during decoding”,正好对应”生成轨迹从视觉前缀漂向语言先验”这一失效模式。
4. 研究方法
- CARD 向量(零成本样本级证据方向):在一次标准的 prefill 前向中,在目标解码层 l 放只读 hook 缓存每个 prefill token i 的自注意力输出 A_i^l;pre-norm 解码器中残差更新即 Δ_i^l = A_i^l(式 1);随后池化并 L2 归一化:v_CARD = Pool({Δ_i^l} _ {i∈T_pre}) / ‖Pool({Δ_i^l})‖₂(式 2),其中 Pool(·) 可取均值或按 ‖Δ_i^l‖ 加权均值。由于自注意力更新在信息量大的 token 上幅度大、在功能/syntax token 上轻,加权池化天然过滤噪声,蒸馏出该输入专属的视觉影响方向;”The entire process occurs within the single prefill pass and introduces negligible overhead, as no additional forward pass or calibration is required.”
- Beta Gate(基于 Beta 分布的自适应门控):令 h _ {l,t} 为目标层生成第 t 个 token 时的隐状态,用 s_t = cos(h _ {l,t}, v_CARD) 度量其与视觉证据的对齐度;再用 Beta-Bernoulli 共轭后验形式把 s_t 视作”视觉接地概率”的伪计数:α_t = softplus(k·s_t + c)、β_t = softplus(−k·s_t + c)、g_t = α_t/(α_t+β_t)(式 3),并把 g_t clamp 到 [g_min, g_max] 以防止门控完全关闭或过早饱和。作者刻意采用单调设计——s_t 高说明当前隐状态已与视觉证据相容,加强注入不易破坏生成;s_t 低或为负说明在生成非视觉功能词或轨迹不稳,此时抑制注入以免伤流畅度或物体召回。这不是”误差探测器”而是”对当前视觉对齐程度的信任度量”。
- 注入方式:每个答案 token 的 steering 更新为 v_steer_t = (α_max · g_t) · v_CARD(式 4),即在自适应门控之外再乘一个全局上限 α_max;注入位置在 Self-Attention(SA) 之后:h_new _ {l,t} = (h _ {l,t} + SA(h _ {l,t})) + v_steer_t(式 5),且注入限定在答案 span 内。
- 变体与训练性:主配置称 RUDDER-Beta(自适应门控),对照配置 RUDDER-Add 以固定强度注入 CARD、不含门控。方法免训练(training-free):少量部署超参只在 100 张 held-out MSCOCO 图像(与评测子集不相交)上做一次轻量校准,用来选层与调参,不是训练过程,也不使用任务监督。校准两步:Step 1 层选择 L(线性扫描最大化 CARD 对齐)→ LLaVA-1.5 取中层偏后 L=30、Idefics2 取 L=28、InstructBLIP 取较早的 L=1;Step 2 网格搜索 α_max 与门控灵敏度 k,目标是最小化 CHAIR 同时保持 ≥95% 的原模型 recall,其余参数固定为 c=1、g∈[0.05,1]。最终 (α_max, k) 为 LLaVA-1.5 (20, 5.0)、Idefics2 (8.0, 5.0)、InstructBLIP (6.5, 8.0)。
- 评测设置:CHAIR 用 500 张 MSCOCO 验证集样本,提示 “Please help me describe the image in detail”,最长 512 token,报句级 CHAIR_S 与物体级 CHAIR_I;POPE 用 “Is there a
5. 实验结果
- 基座模型:LLaVA-1.5-7B、Idefics2-8B、InstructBLIP(三种融合机制:线性投影 / 线性投影 / Q-Former);可扩展性与泛化另测 LLaVA-1.5-13B 与 Qwen2.5-VL-7B。
- 数据集与基准:CHAIR(MSCOCO 开放描述)、POPE(物体探测,三拆分平均)、MME(通用能力)。
- 关键结果:
- CHAIR(Table 1):greedy 下 LLaVA-1.5 48.6/13.6 → 39.5/10.5、Idefics2 46.6/14.9 → 28.4/10.9、InstructBLIP 39.2/12.8 → 27.1/8.5;beam search 下 52.8/15.6 → 33.1/9.3、48.6/14.5 → 29.2/10.1、38.2/12.7 → 26.2/9.5;nucleus 下 55.6/16.0 → 39.9/11.0、53.8/16.7 → 34.1/11.3、46.0/16.2 → 28.9/13.7。正文总结为”average relative reductions of 33.2% in sentence-level (CHAIRS) and 28.6% in object-level (CHAIRI) hallucination across these three models”(我把 Table 1 的 9 组数字平均后得到 33.3% 与 28.7%,与正文一致)。作者还强调 RUDDER-Beta 在 CHAIR_I 上的下降幅度大于 CHAIR_S,”highlights its precision”,归因于 token 级门控只放大视觉不匹配/内容名词处的修正。
- ⚠️ 原文内部不一致(阅读时需留意):摘要写”with greedy decoding, RUDDER reduces CHAIR_S by an average of 24.4% and CHAIR_i by 23.6% relative”,但按 Table 1 的 greedy 三模型自行计算,CHAIR_S 相对下降为 18.7% / 39.1% / 30.9%(平均 29.6%),CHAIR_I 为 22.8% / 26.8% / 33.6%(平均 27.7%),都对不上摘要的 24.4/23.6;而正文的 33.2%/28.6% 与 Table 1 全部 9 组(三种解码 × 三模型)的平均值吻合。摘要口径无法复现,此处以表格与正文为准。
- POPE(Table 2):greedy 下提升 准确率 1.0 / 0.7 / 0.5 个百分点、F1 1.6 / 1.3 / 0.14 个百分点(LLaVA-1.5 / Idefics2 / InstructBLIP);LLaVA-1.5 greedy 85.34/84.91 → 86.53/86.03,beam 85.46/84.98 → 86.51/86.19,nucleus 83.00/81.08 → 84.02/83.57;Idefics2 nucleus 74.84/67.78 → 75.89/69.69。作者称在 LLaVA-1.5 与 Idefics2 上取得最高 F1/准确率,超过 VISTA;InstructBLIP 在 greedy 与 nucleus 下略逊于 VISTA。
- 自适应 vs 静态:长文本自由生成(CHAIR)上 RUDDER-Beta 一致更优;二选一的 POPE 上差异更微妙,InstructBLIP 上 RUDDER-Add 反而更好,作者推测因 Q-Former 提供了高度压缩的视觉表示、对均匀 steering 信号响应良好;结论是复杂任务用 Beta、受限任务/特定架构可用 Add。
- MME(Table 3,greedy):LLaVA-1.5 1745.87 → 1724.17(略降),Idefics2 1518.84 → 1540.56,InstructBLIP 1566.77 → 1592.07。
- 效率(Table 4,greedy,tokens/s):Vanilla 56.7/47.8/62.3,RUDDER-Beta 54.9/45.8/59.5(平均为 vanilla 的 96.0%),RUDDER-Add 55.8/46.5/60.8;对比 VCD 30.1、PAI 29.5、VISTA 36.1/31.9/28.9(VISTA 平均仅 58.1%)。作者称 RUDDER 延迟增量 <4%,”operates within a single forward pass”,而 DeGF 等迭代方法延迟 >3×。
- 层与超参消融(Figure 3,Idefics2,固定 α_max=8.0、k=5.0):L=26 37.2/12.1、L=27 44.6/11.8、L=28 28.4/10.9、L=29 29.4/10.2、L=30 35.0/11.8,即中层偏后最有效;热图显示 α_max 增大降 CHAIR 但牺牲 recall,k 的作用非线性。最佳平衡为 α_max=8.0、k=5.0。
- 可扩展性与架构泛化(Table 5,greedy):LLaVA-1.5-13B vanilla 44.2/11.8、POPE 85.7/85.0 → RUDDER 39.9/10.8、86.3/85.5(VISTA 40.1/10.6、86.0/85.2);Qwen2.5-VL-7B vanilla 35.2/9.5、88.8/87.8 → RUDDER 26.9/7.0、89.0/88.1(VISTA CHAIR_S 更低 25.1 但 POPE 反而退步到 88.6/87.4),作者据此强调 RUDDER 在降幻觉的同时不损伤基础物体识别。
- 对比方法:DoLa、VCD、PAI、HALC、AGLA、DeGF(迭代式,标注 † 表示延迟 >3×)、VISTA(steering 类代表)。
6. 论文结论
- 作者自述贡献:(1) 提出 CARD——从 prefill 残差更新中抽取持续存在的视觉锚点,使模型在整段解码中保持视觉接地;(2) 设计 Beta Gate——基于 Beta 分布、免训练的自适应门控,在接地与流畅之间取得平衡;(3) 证明方法的通用性与可扩展性,覆盖 LLaVA-1.5-13B 等更大模型以及 Qwen2.5-VL、InstructBLIP 等融合策略不同的现代架构;(4) 开销极小——单次前向、延迟 <4%,显著优于多趟方法(保持 96.0% 吞吐)。
- 局限与未来工作(论文第 5 节 “Conclusion and Limitations” 原文):”RUDDER’s primary limitation is its sensitivity to hyperparameters, which need be tuned for each model architecture. Future work could focus on automated hyperparameter optimization to improve its robustness and ease of deployment.”;即对超参(注入层 L、α_max、k)敏感、需按架构逐个调参,未来想自动化调参。作者同时承认在 LLaVA-1.5 的 MME 上分数略低于 vanilla(”the difference is still acceptable”)。
[37] ICML2026 — Capturing Gaze Shifts for Guidance: Cross-Modal Fusion Enhancement for VLM Hallucination Mitigation
- 会议:ICML 2026(arXiv 录用说明:ICML 2026)
- arXiv:2510.22067 — https://arxiv.org/abs/2510.22067
- 本地 PDF:
ICML2026-Capturing Gaze Shifts for Guidance Cross-Modal Fusion Enhancement for VLM Hallucination Mitigation.pdf - 一句话定位:用 query 处理过程中的”注视转移”预计算视觉显著性图,解码时同时增强视觉与 query 注意力以治幻觉。
1. 中文摘要
论文指出 VLM 幻觉源于视觉贡献不足与语言先验主导,而已有按注意力分数放大视觉 token 的做法忽略两点:visual attention sink 会把无关区域一并放大,且只增视觉、不调 query 注意力会造成跨模态融合失衡。作者提出免训练的 GIFT:预填充阶段用 POS 标注挑出 query 中的信息密集词,只在注意力变化最大的峰值层跟踪这些 token 对视觉 token 注意力的正向增量(gaze shift),得到对注意力汇鲁棒的视觉显著性图;解码阶段在视觉与 query 注意力都高的层,用 exp(α·Ŝ_j) 放大显著视觉 token,并按视觉注意力整体放大比例同步缩放 query token 注意力以维持融合平衡。峰值层是模型固有属性,方法即插即用、开销低。
2. 方法图
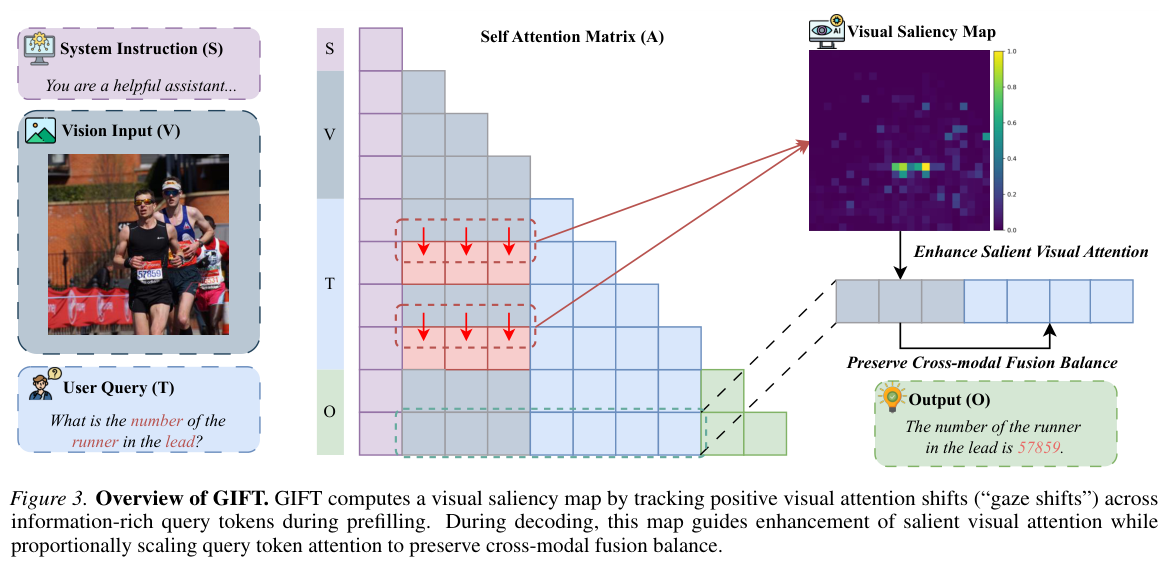
3. 研究动机
- 现有做法的缺陷:引言指出,Yin et al. (2025)(VAF)按注意力分数等比放大视觉 token,”does not account for the balance between visual and query signals during cross-modal fusion”,模型可能”attend to relevant regions but misinterpret the query”;同时它不处理 visual attention sink,”potentially amplifying incorrect regions throughout generation”。而专门做 attention sink 矫正的方法(Kang et al. 2025 的 VAR 等)虽然重分配了视觉注意力,”fail to address the broader problem of insufficient overall visual contribution during decoding”。对比解码(VCD)则要生成两路输出、开销大;改图类方法需要额外前向。
- 本文的关键观察/假设:作者假设 VLM 像人一样,在理解 query 中的信息密集词时会动态移动”视觉注视”;因此把 query token→视觉 token 注意力的正向变化累加,就能得到感兴趣区域,而无关注意区域”exhibit minimal or no change in attention”,天然抑制 attention sink。第二个观察来自 Figure 4:输出 token 对视觉 token 与 query token 的注意力在层间走势”broadly aligned”、且绝对值都偏低,说明有效融合需要同时增强两种模态。
- 显著性图的量化证据:在 MSCOCO 2014 的 1,000 个单实例样本上,用”框内显著性占比/框相对面积”衡量,gaze-shift 图得分 11.92,静态平均图只有 5.40,超过两倍。
4. 研究方法
- 总体流程(免训练、推理期):输入 X = [X_S; X_V; X_T](system instruction / 视觉 token / query token)。先在预填充阶段算出视觉显著性图 Ŝ,再在解码阶段用 Ŝ 做注意力引导,不训练任何参数。
- Gaze shift 显著性图:在每层取对视觉 token 累计注意力最高的前 50% 注意力头 H^l_TV;只用 POS 标注出的信息密集 query token X_Tr,计算 ΔA^l _ {h,i,j} = max(A^l _ {h,i,j} − A^l _ {h,i−1,j}, 0),即相邻 query token 间视觉注意力的正向增量,再对头与 token 求平均得到 Ŝ^l(Eq. 3)。负增量被置零,因为负增量只表示”移开视线”、会抵消有意义的新增。Ŝ 在 min-max 归一化前按三倍标准差裁剪,避免过度强化单一区域。
- 峰值层选择:以未归一化的 Ŝ^l 之和最大者作为提取层,Figure 2 显示峰值落在早中期层;实现中为 LLaVA-1.5 7B 第 11 层、13B 第 10 层、Qwen2-VL 7B 第 14 层、Qwen3-VL 8B 第 18 层。
- 跨模态融合增强(解码):先用输出 token 对视觉/query 的注意力比例 R^l_V、R^l_T 选出两者都高的层 L(实现中分别为 12-22、14-20、5-18、13-23)。对 h∈H^l_OV 的视觉 token 做 Â = A · exp(α·Ŝ_j)(等价于在 softmax logits 上加偏置 B = αŜ_j);对 h∈H^l_OT 的 query token 做 Â = A · β·r^l,其中 r^l 是本层视觉注意力的整体放大倍数,α 取 5.0(LLaVA)/4.0(Qwen),β 固定 1.0 以保持原平衡,最后按行重新归一化。
- 信息密集词抽取:默认 spaCy POS 标注(NOUN/PROPN/VERB/ADJ/ADV/NUM),成本可忽略;另提供用 Qwen3-VL 8B 提示词挑词的 LLM 版本,效果更强但更贵。
5. 实验结果
- 基座模型:LLaVA-1.5 7B、LLaVA-1.5 13B、Qwen2-VL 7B、Qwen3-VL 8B。
- 数据集与基准:幻觉类 POPE(F1 / Acc)、CHAIR(CHAIRs / CHAIRi)、MMHal-Bench(Hallucination rate / Score);通用能力 MME、SEED-Bench;机制分析另用 TextVQA、MathVista(峰值层稳定性)与 MSCOCO 2014(显著性图定位评测)。
- 关键结果:
- LLaVA-1.5 7B:CHAIRs 从 greedy 的 50.2 降到 39.8、CHAIRi 15.4 → 10.6;POPE F1 82.4 → 83.8、Acc 79.5 → 81.9;MMHal-Bench 幻觉率 65.2 → 57.3、Score 2.22 → 2.48。作者概括为”up to 20.7% on CHAIR, 15.9% on MMHal-Bench, and 3.0% on POPE”,MMHal 信息量分提升 11.7%。
- 全部四个模型上 GIFT 都优于 greedy:Qwen2-VL 7B MMHal 幻觉率 32.7 → 27.5、CHAIRs 24.8 → 21.2;Qwen3-VL 8B 幻觉率 28.3 → 26.4。基线只在 LLaVA-1.5 7B/13B 上有可比实现(VAF、VAR、MLLMs know (Rel-Attn)、VCD),在 LLaVA-1.5 7B 上 GIFT 的 CHAIRs 最低(39.8 vs VCD 52.2 / VAR 54.0)。
- 通用能力基本不退化:LLaVA-1.5 7B SEED 65.5 → 65.6、MME 1751.6 → 1750.5;Qwen3-VL 8B MME 2403.5 → 2418.5,而 Rel-Attn 在 LLaVA-1.5 13B 上 MME 降到 1758.5、VCD 的 SEED 降到 66.3。
- 效率:以 LLaVA-1.5 7B 在 MMHal-Bench 上生成 32 token 计,GIFT 相对 greedy 为 1.13×,低于 Rel-Attn 1.56×、VCD 1.99×、VAR 11.10×(VAF 1.01× 更快但效果差)。
- 消融:Table 5 中只增视觉不保平衡(Inc. V.)与只重分配视觉(Cal. V.)都明显不如 GIFT,最好情况下差 25.4%(Qwen3-VL 8B 幻觉率 35.4 → 26.4);Table 6 显示层范围 12-22 与更窄区间都强,范围过宽(10-24 起)会掉 SEED;Table 7 显示 LLM 挑词比 POS 标注更强(LLaVA-1.5 7B 幻觉率 57.3 → 52.6),但默认仍用 POS。
- 对比方法:greedy decoding、VAF (Yin et al. 2025)、VAR (Kang et al. 2025)、MLLMs know 的最佳变体 Rel-Attn (Zhang et al. 2025)、VCD (Leng et al. 2024)。论文说明这些基线未提供 Qwen 系列实现,故仅在 LLaVA 两档上直接比较。
6. 论文结论
- 作者自述贡献:① 提出通过跟踪信息密集 query 词上的”gaze shift”预计算整体视觉显著性图、并同时抑制 visual attention sink 的新机制;② 提出轻量推理期方法 GIFT,用该图增强显著视觉注意力并按比例缩放 query token 注意力以保持跨模态融合平衡;③ 跨架构、跨规模验证有效(CHAIR 最多提升 20.7%、MMHal-Bench 15.9%、POPE 3.0%),且不损通用视觉语言能力、开销低。
- 局限与未来工作:作者明确写”a primary limitation is GIFT’s reliance on the query to identify relevant visual regions”——当回答不依赖视觉信息、或 query 中大段内容与图像无关时,显著性图会算错、导致关注错误区域。未来工作提出用 LLM 提示或轻量分类器来更好地识别与视觉相关的 token,让 token 分数加权其显著性贡献,并在完全没有相关 token 时直接跳过显著性计算。附录 G 另列出延迟优化的未来方向。
[38] ICML2026 — Finding the Correct Visual Evidence Without Forgetting: Mitigating Hallucination in LVLMs via Inter-Layer Visual Attention Discrepancy
- 会议:ICML 2026(arXiv 录用说明:Accepted by ICML 2026)
- arXiv:2605.20965 — https://arxiv.org/abs/2605.20965
- 本地 PDF:
ICML2026-Finding the Correct Visual Evidence Without Forgetting Mitigating Hallucination in LVLMs via Inter-Layer Visual Attention Discrepancy.pdf - 一句话定位:利用层间视觉注意力差异定位”视觉证据”,抑制视觉遗忘与语言先验。
1. 中文摘要
论文先作诊断:LVLM 幻觉的一个直接原因是对正确视觉证据关注不足,并在长文本生成中逐步遗忘它;层级上模型只在某些层对证据敏感,相邻层差异显著(Inter-Layer Visual Attention Discrepancy),而视觉注意力汇几乎每层都被判为显著,故单看相对注意力无法剔除 sink。方法免训练、分两步:先用前 T 个生成 token 的注意力按头平均、阈值二值化,再对相邻层做只保留正增量的逐层相减,得到视觉证据显著性图;随后在证据敏感头上用 A·exp(α·Ŝ_j) 增强视觉证据注意力以抗遗忘,并用证据加权分强化强接地的文本 token、压制语言先验。只改注意力权重,即插即用。
2. 方法图
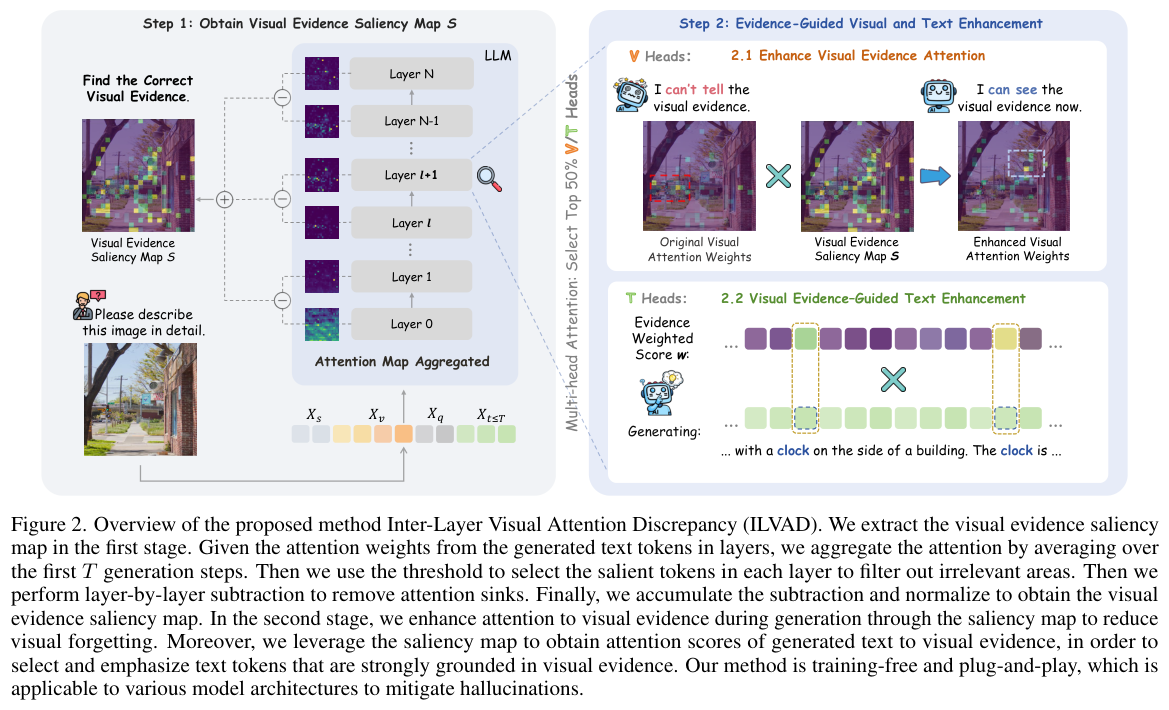
3. 研究动机
- 现有做法的缺陷:① 需要外部知识库或微调的方案”incur significant computational and storage overhead”;② 对比解码类方法(VCD/CODE/AGLA/ONLY)”operate primarily on the logits rather than the internal visual attention, thus failing to effectively promote LVLMs to focus on visual information”;③ 注意力重分配类方法(VAR 等视觉注意力汇矫正)”remains limited when language priors remain dominant, as it does not genuinely increase the model’s reliance on visual information”;④ 与本文最接近的注意力干预工作(SPARC 用时间步注意力差、VHR 用视觉敏感头)共同的缺陷是”they do not effectively guide the model to maintain sustained attention to visual evidence relevant to the current query during generation”。
- 本文的关键观察/假设:三点经验发现——(i) 样本级:幻觉样本对视觉证据的平均注意力低于正确样本;(ii) 步级:生成过程中对视觉证据的注意力逐渐下降、幻觉频率上升,即”visual forgetting”;(iii) 层级:模型在某些层对视觉证据的注意力高于层均值且与 non-evidence 更可区分,但视觉注意力汇几乎每层都被高关注,因此单看相对注意力无法剔除 sink,必须用**层间差分的”新增激活”**来区分真证据与 sink。
- 指标/方法背景:证据图的有效性用定性可视化(Figure 3 的 τ 扫描)与下游基准数字间接验证;作者用 τ=5 在 CHAIR 与 POPE 之间取平衡。
4. 研究方法
- 总体流程:推理期两阶段注意力改造,全部在内部注意力上完成,不训练、不改架构(仅调整 attention weights)。
- Step 1 — 视觉证据显著性图(Inter-Layer Visual Attention Discrepancy):对生成的前 T=10 个 token 的注意力,在每层按视觉注意力总和对 head 排序取前 50%(H^l_v),求平均得 Ā^l_j(Eq. 4);用 Ā^l_j > τ·mean(Ā^l) 二值化得 Ã^l(Eq. 5,τ=5);再做层间差分累积 S = Σ _ {l=1}^{L−1} max(Ã^{l+1} − Ã^l, 0)(Eq. 6),从而剔除”每层都显著”的 attention sink,只保留新激活的证据 token,最后归一化得到 Ŝ ∈ [0,1]^{|Xv|}。
- Step 2.1 — 增强视觉证据注意力:对每个生成文本 token 定义 evidence ratio e^l,h_i = Σ _ {j∈Xv} Ŝ_j·A^l,h _ {i,j} / Σ _ {j∈Xv} A^l,h _ {i,j}(Eq. 7),据此选前 50% 的”证据敏感头” H^l_e,按注意力引导公式 Â = A·exp(α·Ŝ_j) 增强视觉证据注意力(Eq. 8),α 控制强度;作用在每一步解码上以对抗视觉遗忘。
- Step 2.2 — 证据引导的文本增强:用证据加权分 w_i = (1/(L·|H^l_t|))·Σ_h Σ _ {j∈Xv} Σ_l Ŝ_j·A^l,h _ {i,j}(Eq. 9)度量每个已生成文本 token 对视觉证据的依赖,归一化为 ŵ 后按 Â = A·(ŵ_i + β) 强化(Eq. 10),其中 H^l_t 为文本敏感头(前 50%),X _ {<t} 是此前生成的文本 token;β 调节文本增强/抑制程度,最后对每行重新归一化。
- 超参数选择:τ=5 全局;α=5(LLaVA-1.5-7B、Qwen2-VL-7B、Qwen3-VL-8B、InternVL3-8B),LLaVA-NeXT-7B 用 α=3;判别式基准(POPE/MME)β=1,描述式基准(CHAIR,长序列)β∈[0.2, 0.5];显著性图固定用前 10 个生成 token 提取,head 比例 ρ=0.5。
5. 实验结果
- 基座模型:LLaVA-1.5-7B、LLaVA-NeXT-7B、Qwen2-VL-7B、Qwen3-VL-8B、InternVL3-8B(五个近期模型)。
- 数据集与基准:CHAIR(MSCOCO 验证集随机 500 图,CHAIR_S / CHAIR_I)、POPE(Accuracy / F1)、MMHal-Bench(Hal. / Score,由 GPT-4o 打分)、MME 子集(Exist./Count/Pos./Color/Total,用 LLaVA-1.5-7B)、LLaVA-Bench (In-the-Wild)(Accuracy/Detailedness/Naturalness,GPT-4o 成对比较)。
- 关键结果:
- LLaVA-1.5-7B:CHAIR_S 48.6 → 32.6、CHAIR_I 13.52 → 9.42;POPE Acc 84.50 → 85.76、F1 85.22 → 86.12;MMHal-Bench 幻觉率 67.0 → 61.5、Score 2.01 → 2.22。作者原文概括为”reduces the CHAIR score by 31.6% and improves POPE and MMHal-Bench by 1.27% and 9.12%”。
- 跨模型一致有效:LLaVA-NeXT-7B 幻觉率 64.3 → 56.8(Score 2.14 → 2.57);Qwen2-VL-7B CHAIR_S 20.8 → 17.8、CHAIR_I 7.58 → 5.14、幻觉率 29.7 → 25.3;Qwen3-VL-8B CHAIR_S 51.6 → 45.2、幻觉率 35.4 → 32.6;InternVL3-8B CHAIR_S 21.2 → 16.8。
- 与 10 个对比方法相比,本文在 6 个幻觉指标中取得 5 个最佳、1 个第二;唯一落后的是 POPE F1(AGLA 86.38 > 本文 86.12)。VHR 的 CHAIR_S 也做到 34.5,但仍高于本文 32.6。
- MME 子集总分最高:Greedy 631.66 → 本文 641.66(VAR 636.66 次之);LLaVA-Bench 上 LLaVA-1.5-7B Accuracy 5.450 → 5.833。
- 消融(Table 4,LLaVA-1.5-7B):基线 48.6/13.52;只做文本增强(w/o Visual)49.4/13.44(几乎无效);只做视觉增强(w/o Text)34.8/9.73;两者结合 32.6/9.42(POPE-A 85.76、F1 86.12),说明文本增强模块带来增量但视觉证据增强是主力。
- 超参与效率:τ 从 1 增到 10 时 CHAIR_S 由 44.6 降到 25.3(τ=3)再回升,POPE-F1 在 τ=10 最高(86.28),故取 τ=5 折中;β=0 会抑制所有文本、损害正常输出;推理时间与 greedy 几乎相同(Figure 5)。
- 对比方法:Greedy、Beam search、VCD、CODE、AGLA、ONLY(解码调整)、VAF、VAR、SPARC、VHR(注意力干预)。
6. 论文结论
- 作者自述贡献:① 系统分析视觉证据与幻觉的关系,指出幻觉源于对相关视觉证据注意力不足、并在生成中逐渐遗忘;② 发现 LVLM 对视觉证据的注意力存在显著层间差异(ILVAD),据此提出免训练方法构造视觉证据显著性图并增强接地生成;③ 在五类模型与多个基准上验证能持续缓解幻觉并提升视觉理解(含 Qwen3-VL-8B、InternVL3-8B 等最新模型)。
- 局限与未来工作:论文正文与结论未设 Limitation/Future Work 章节(全文仅在第 2 节用”limitation”描述前作的缺陷),故作者自述局限为”论文未明确说明”。可读出的隐含代价是:方法对超参敏感——β=0 时”suppresses attention to all text, which harms normal output”,需要逐任务挑最优 β;τ 的取值在 CHAIR 与 POPE 上偏好相反(τ=3 利于 CHAIR、τ=10 利于 POPE F1),本文靠经验取 5 折中,论文未给出自适应选取方案。
[39] ICML2026 — Instruction Lens Score: Your Instruction Contributes a Powerful Object Hallucination Detector for Multimodal Large Language Models
- 会议:ICML 2026(arXiv 录用说明:Accepted by ICML-2026)
- arXiv:2605.12258 — https://arxiv.org/abs/2605.12258
- 本地 PDF:
ICML2026-Instruction Lens Score Your Instruction Contributes a Powerful Object Hallucination Detector for Multimodal Large Language Models.pdf - 一句话定位:发现 instruction embedding 能滤掉误导性视觉信息,据此做免训练物体幻觉检测器。
1. 中文摘要
本文做的是物体幻觉检测而非消除。作者用 Logit Lens 把指令与图像的中间嵌入分别投影到词表,发现指令嵌入隐含编码了图像接地的视觉信息,还能过滤误导性视觉嵌入引入的错误,用它算出的内部置信度区分真假物体的 AUROC 比图像嵌入高 8% 以上。据此提出 InsLen:一是校准局部分数,用指令嵌入对物体词的最大置信度 Cafe 以乘法方式校准原有视觉局部分数;二是上下文一致性分数,取对物体词置信度最高的 top-m 个指令嵌入求平均作为物体级上下文,用距离度量答案物体嵌入与它的一致性并按平均置信度加权。两者按权重 ω 相加,免训练、即插即用。
2. 方法图
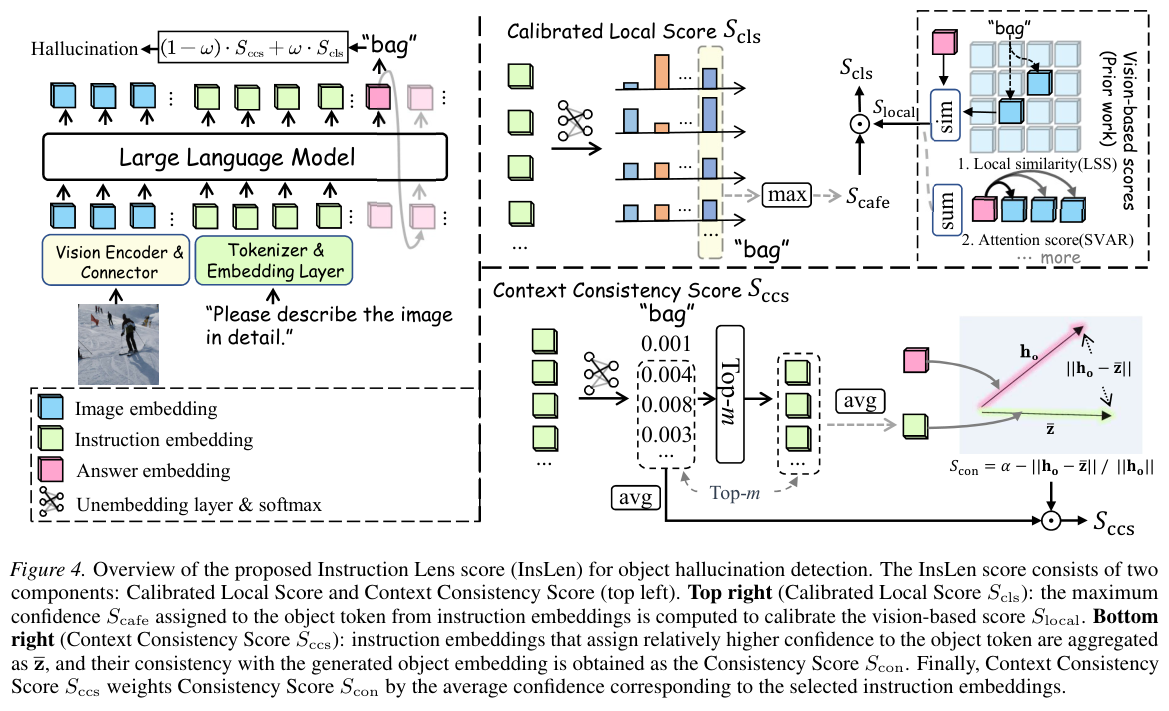
3. 研究动机
- 现有做法的缺陷:① 用 GPT-4 等辅助模型检测(GAVIE)或训练专用检测器(HalLoc)”incur substantial computational overhead”;② 以视觉信息为核心的内部信号检测(视觉 token 注意力、patch 级图像 embedding 与答案 embedding 的相似度)”can be adversely affected by misleading visual information introduced by the visual encoder(如 Gong et al. 2024)or during cross-modal interactions within the language model”,会让幻觉物体得到虚高置信度;③ patch 级图像 embedding 只有局部视图,”local visual patterns may overlap between real and hallucinated objects (e.g., similar silver materials for spoons and knives)”,难以区分外观相似的幻觉物体。
- 本文的关键观察/假设:instruction embedding 在跨模态注意力下以全部图像 embedding 为条件计算,既隐式携带物体级视觉证据,又能过滤误导性视觉信息。Figure 2 显示:用 image embedding 时真/假物体的置信度分布明显重叠,用 instruction embedding 时分离更清晰;Figure 3 显示在 LLaVA、LLaVA-OneVision1.5、Qwen3-VL、mPLUG-Owl3 上 instruction embedding 的 AUROC 比 image embedding 高 +8.07%、+11.78%、+9.39%、+9.00%。
- 任务定位:把物体幻觉检测形式化为对答案中每个物体 token 的二分类(S(o) ≤ µ 判为幻觉),并用 AUROC/AUPR 评价。
4. 研究方法
- 总体流程:给定图像 I 与指令 X,MLLM 生成答案 Y;对答案中每个物体 token o,从语言模型倒数第二层(LLaVA 为第 31 层、Qwen3-VL 为第 35 层)取 instruction embeddings {z_j} 与答案 token embedding h_o,计算 InsLen 分数 S_Ins(o) = ω·S_cls(o) + (1−ω)·S_ccs(o),与阈值 µ 比较得到检测结果。免训练、无辅助模型。
- Calibrated Local Score(S_cls):先用 Logit Lens 计算 Calibration Confidence S_cafe(o) = max_j softmax{W_u·z_j/τ}[o](Eq. 4),即所有 instruction embedding 对物体 token 的最大置信度;再与视觉分数相乘:S_cls(o) = S_cafe(o) · (1/K)Σ_k cos(h_o, v_k)(Eq. 5),其中 v_k 是 Logit Lens 下对 o 置信度最高的 K 个图像 embedding。采用乘法而非加法是为了不引入额外缩放系数、可直接兼容 SVAR / Internal Confidence 等不同视觉分数。
- Context Consistency Score(S_ccs):选对 o 概率最高的 top-m 个 instruction embedding {ẑ_n},取平均 z̄ = (1/m)Σẑ_n 作为物体级全局上下文;一致性分数 S_con(o) = α − ‖h_o − z̄‖/‖h_o‖(Eq. 6,用 ℓ2 同时捕捉方向与幅度差异,α 保证非负);再用这些 embedding 的平均置信度 p(o|{ẑ_1..ẑ_m}) 加权得到 S_ccs(o) = S_con(o)·p(o|{ẑ_1,…,ẑ_m})(Eq. 7)。
- 关键超参:ω = 0.4、α = 2、τ = 10、m = 4;最大生成长度 512 token;视觉分数沿用原论文设置。
5. 实验结果
- 基座模型:LLaVA-1.5-7B、InstructBLIP-7B、mPLUG-Owl3-8B、LLaVA-OneVision1.5-8B(论文写作 LLaVA-OneVision-Instruct-8B / LLaVA-OneVision1.5-8B)、Qwen3-VL-8B;另在 post-trained 的 LLaVA-RLHF-7B 与 LLaVA-RLAIF-V-7B 上验证。
- 数据集与基准:MSCOCO(80 类,固定指令 “Please describe the image in detail.”)、Objects365(365 类)、POPE(是/否提问,三种采样策略取平均)、CLEVR(颜色/材质/空间关系等属性与关系幻觉);每个基准随机抽 5,000 张图、三个随机种子取平均;指标为 AUROC 与 AUPR。
- 关键结果:
- MSCOCO(LLaVA-1.5-7B):AUROC 86.93 / AUPR 96.38,优于最强基线 GLSIM 的 83.24 / 93.81;Objects365(LLaVA-1.5-7B)76.32 / 78.49 vs GLSIM 72.16 / 76.04。
- 跨模型增益:Qwen3-VL-8B 在 MSCOCO 上比 GLSIM 高 7.70% AUROC(81.02 vs 73.32)、3.29% AUPR;在 Objects365 上比 SVAR 高 6.60% AUROC(77.44 vs 70.84)、1.49% AUPR。
- POPE(三策略平均):LLaVA-1.5-7B AUROC 83.94 / AUPR 96.14,比 GLSIM 高最多 13.81% AUROC;CLEVR:Qwen3-VL-8B AUROC 77.72 vs SVAR 73.01。
- 消融(MSCOCO):只用 S_local 74.20;加 S_cafe 后 84.31(+10.11 AUROC);只用 S_con 80.69;S_con+Conf 82.72;全部组合 86.93(LLaVA-1.5)/ 81.02(Qwen3-VL)——说明校准项与上下文一致性项互补。
- 校准项的通用性(Table 5):把 Cafe 接到其他视觉分数上都有提升——Internal Conf 73.45 → 83.93、LSS 74.20 → 84.31、SVAR 73.97 → 81.44(+7.47)。
- 稳健性/开销:ω 在 [0.1, 0.9] 内都超过最强基线(峰值约 ω = 0.6),m ∈ [2, 5] 表现稳定;post-trained 模型上 LLaVA-RLHF-7B 86.37 vs GLSIM 83.68、LLaVA-RLAIF-V-7B 80.14 vs 72.36;延迟上 InsLen 为 104.5 ms(LLaVA)/ 564.5 ms(Qwen3-VL),远低于 EASY 的 3896.7 ms,但略高于 GLSIM 的 95.2 ms。
- 对比方法:NLL、Entropy、Internal Conf.(token 级 logit),SVAR、EAZY/EASY(注意力类),GLSIM、Contextual Lens(隐状态类)。
6. 论文结论
- 作者自述贡献:① 分析 MLLM 的 instruction embedding,发现视觉 embedding 引入的误导信息可被其有效过滤;② 提出 InsLen 分数,把 Calibrated Local Score 与 Context Consistency Score 结合用于物体幻觉检测;③ 多基准、多架构实验证明其有效性与鲁棒性。
- 局限与未来工作:① Logit Lens 把指令中的视觉信息转成文本形式,但指令特征里的视觉信息不一定与生成答案一致,”is encoded as synonyms”(附录 Figure 14-16),因此按生成答案选置信度可能无法覆盖指令特征中的全部语义;② 前作指出的 representation drift 等问题也可能影响本方法;③ 附录 A.6 进一步讨论模型架构对性能的影响。论文未给出明确的未来工作清单。
[40] ICML2026 — Learning from Fine-Grained Visual Discrepancies: Mitigating Multimodal Hallucinations via In-Context Visual Contrastive Optimization
- 会议:ICML 2026(arXiv 录用说明:ICML 2026)
- arXiv:2605.31312 — https://arxiv.org/abs/2605.31312
- 本地 PDF:
ICML2026-Learning from Fine-Grained Visual Discrepancies Mitigating Multimodal Hallucinations via In-Context Visual Contrastive Optimization.pdf - 一句话定位:把对比图像放进同一个多图上下文,使视觉偏好 DPO 目标在数学上自洽,并用精准编辑造难负样本。
1. 中文摘要
论文指出标准文本 DPO 把图像当静态条件,无法惩罚忽略视觉 token;已有视觉偏好 DPO 用负样本图像对比,但有两大硬伤:改变视觉上下文使参考策略的配分函数无法抵消,目标残留不可控偏置;检索或文生图合成的负样本风格与语义漂移明显,易被模型用粗粒度差异走捷径。为此提出 IC-VCO:把原图与对比图放进共享多图上下文,并用锚点提示指明目标图像,使正负回答同条件、目标与 DPO 推导严格一致;再用视觉对比蒸馏以多图偏好分布为软教师,经正确性门与置信度门双重门控并停梯度校准单图分支;最后借助专家 VLM 与图像编辑模型做局部可逆编辑,构造风格一致的难负样本。
2. 方法图
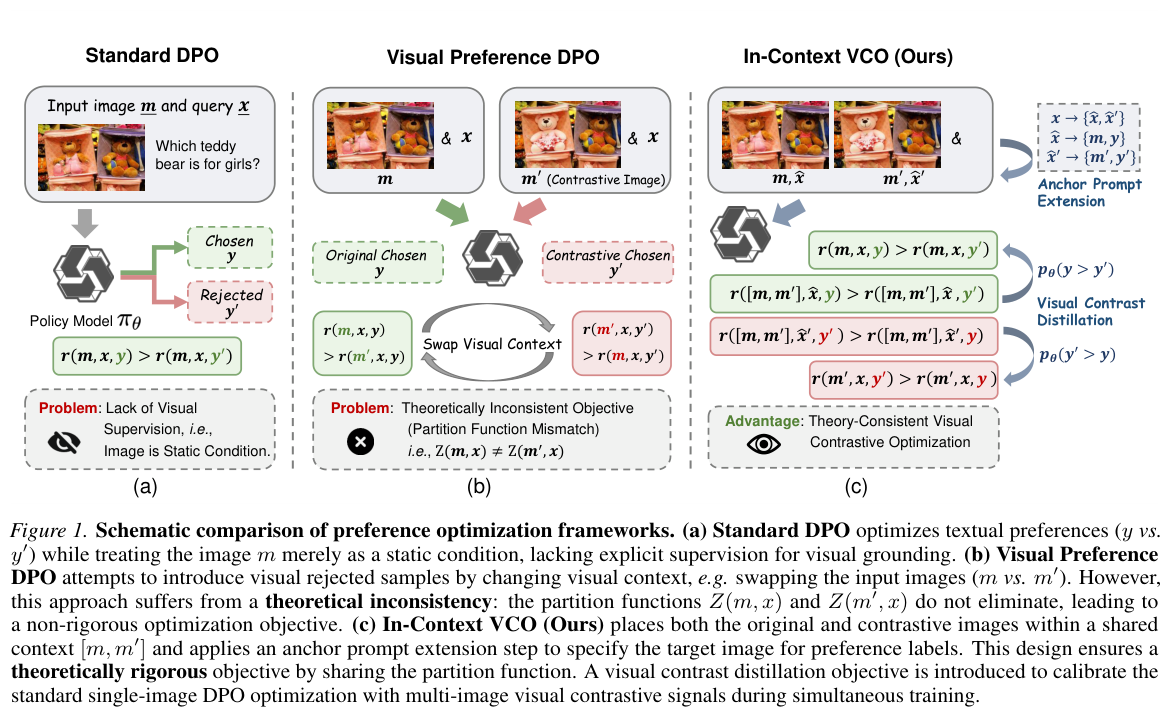
3. 研究动机
- 现有做法的缺陷:① 标准 DPO 把图像当静态条件,”often fails to effectively penalize the model for ignoring visual tokens”;② VisDPO 的目标函数”rest on a loose theoretical approximation”,条件不同导致 partition function 无法抵消,”results in a residual partition function ratio that persists as an intractable bias”;③ 现有对比图由检索或文生图合成,”often exhibit distinct stylistic differences or noticeable semantic gaps”,使被拒样本成为 trivial negatives,模型靠粗粒度差异就能压低 loss,”rather than learning the fine-grained visual facts”。
- 本文的关键观察/假设:若把两张图放进同一个多图上下文并只改变 anchor prompt,则正负回答共享条件、Z(M, x̂) 可抵消,目标与原始 DPO 推导严格一致;同时 hard negative 应满足”外科手术式干预”的因果形式 do(c_tgt → c′_tgt) 且保持 {C_ctx, U}_m ≈ {C_ctx, U}_m′,即背景与风格分布不变,让偏好标签只能依赖目标概念的细粒度差异(可用 P(C_ctx, U|m) ≠ P(C_ctx, U|m′) 刻画粗粒度负样本的问题来源)。
- 指标/现象证据:CLIP 图像对相似度上,编辑样本均值 94.72,远高于合成样本 72.88,说明编辑负样本与正样本视觉上更接近、更”难”;训练诊断(Figure 4a)显示编辑偏好对在相同设置下 reward accuracy 更低,即确实更难优化。
4. 研究方法
- 总体流程:训练期为每个样本构造 M=[m, m′] 多图上下文与锚点扩展提示 x̂ / x̂′(图像顺序随机化以消除位置偏置),同时训练单图分支与多图分支,并用 VCDist 把多图偏好分布蒸馏给单图分支;推理仍按标准单图流程。
- 多图分支(理论自洽的核心):p_multi = σ(β log π_θ(y|M,x̂)/π_ref(y|M,x̂) − β log π_θ(y′|M,x̂)/π_ref(y′|M,x̂)),L_Multi = −E[log p_multi](Eq. 9);因正负回答同条件,Z(M, x̂) 抵消。配合对称偏好对 r(M,x̂,y) ≻ r(M,x̂,y′) 与 r(M,x̂′,y′) ≻ r(M,x̂′,y)。
- 单图分支与锚点损失:保留单图 DPO 目标 L_Single(Eq. 10)以维持推理兼容性;另加 L_SingleAnc(Eq. 12)与 L_MultiAnc(Eq. 13)两项 anchor loss,防止 chosen 似然相对参考策略下降。
- Visual Contrast Distillation (VCDist):L_VCDist = −E[ I(p_multi > 0.5 ∧ p_single < sg(p_multi)) · (sg(p_multi) log p_single + (1 − sg(p_multi)) log(1 − p_single)) ](Eq. 11)。正确性门(p_multi > 0.5)过滤不可靠教师,置信度门(p_single < p_multi)只在学生更不自信时才蒸馏、避免反向惩罚,sg(·) 为 stop-gradient。
- 总目标:L_IC-VCO = ½[λ₁(L_Multi + η₁L_MultiAnc) + λ₂(L_Single + η₂L_SingleAnc) + γL_VCDist](Eq. 14),并对称化得 L_Total = L_IC-VCO + L′_IC-VCO(Eq. 15)。anchor 权重与对应分支耦合。
- 细粒度 token 级偏好:对编辑响应中描述被改视觉证据的 token 计算 mask,单图分支只在被 mask 的 token 上算偏好分,多图分支仍用完整响应以保留整体视觉推理。
- Contrastive Sample Editing(数据构造):用 QwenVL-Plus 作 expert planner 生成可执行编辑指令 T(分 hallucination realization 与 hallucination injection 两类,目标为 existence / attribute / relation),据此最小改写原 chosen 回答得到 y′_new 并记录 token 级差异;Qwen-Image-Edit 施加 T,采用可逆 padding 保持原始长宽比与非目标区域对齐;最后由 QwenVL-Plus 校验 m′ 是否忠实执行 T,失败的编辑或结构变化样本被丢弃。种子语料为 SymMPO 数据集(约 21.4k,源自 VQA v2、MSCOCO、TextVQA,经 TPO 聚合),最终得到 19,453 条对比样本,成功率 91%。
5. 实验结果
- 基座模型:LLaVA-NeXT-Interleave-Qwen-7B、LLaVA-OneVision-Qwen2-7B。
- 数据集与基准:HallusionBench(语言幻觉与视觉错觉,aAcc/fAcc/qAcc)、AMBER(Attr/Exist/Rel 细粒度幻觉)、CRPE(物体识别与关系理解,Exist/Rel)、R-Bench(图像损坏鲁棒性,Dis/Ref)、BLINK(14 类核心视觉感知);整体分为各基准的 macro-average;评测统一用 VLMEvalKit。训练数据为 SymMPO-synthetic(21.4k)与本文编辑样本(19k)。
- 关键结果:
- LLaVA-NeXT-Interleave-Qwen-7B:基线模型 overall 59.14,DPO 60.32 / mDPO 61.64 / V-DPO 60.15 / S-VCO 60.81 / SymMPO 61.50,IC-VCO 62.83(合成样本)与 63.35(编辑样本),”outperforms the strongest baseline by 1.19 points with synthetic samples and by 1.24 points with contrastive edited samples”。
- LLaVA-OneVision-Qwen2-7B:基线 62.46,IC-VCO 66.26(合成)与 66.82(编辑),分别比最强基线高 0.26 与 0.48 分。
- 编辑样本的通用收益:把合成负样本换成编辑负样本,LLaVA-NeXT-Interleave 上各基线提升 0.08
0.61 分,LLaVA-OneVision 上提升 0.251.23 分;IC-VCO 自身也从 62.83 → 63.35、66.26 → 66.82。 - 分项上 IC-VCO 在所有设置下都拿到最好的 AMBER-Attr,AMBER-Exist、CRPE-Exist、BLINK 也一致提升;但关系类指标(AMBER-Rel、CRPE-Rel)并非总是最优。
- 消融(Table 4,编辑样本):完整 IC-VCO 63.35 → 去掉单图分支 62.69、去掉 L_VCDist 63.04、去掉 token mask 63.10、去掉 anchor loss 61.15(降幅最大);VCDist 内部去掉 stop-gradient 为 63.12、去掉 dual-gating 为 63.22。
- 理论性消融(Figure 5):单图设置下带 partition function mismatch 的视觉 DPO 变体比无 mismatch 的 DPO 基线低 1.97 分(合成数据)与 0.56 分(编辑数据);多图设置下人为制造 anchor 不匹配(IC-VCO_CrossAnc)也会掉点但幅度更小。
- 训练动态与稳健性:置信度门在最后 100 步平均过滤掉 13.3% 的”教师正确”样本;VCDist 阈值从 0.5 调到 0.6/0.7 时总分最大变化仅 0.23 分;教师侧存在朝位置 2 的位置偏置(教师概率 +2.0、教师准确率 +8.4、触发率 +12.7),但学生单图分支仅为 +0.6。
- 对比方法:DPO (Rafailov et al., 2023)、mDPO (Wang et al., 2024a)、V-DPO (Xie et al., 2024)、S-VCO (Wu et al., 2025b)、SymMPO (Liu et al., 2025b,比较时去掉需要额外标注的 L_DPOm 项)。
6. 论文结论
- 作者自述贡献:① 提出 IC-VCO,把对比图像放入共享上下文以消除 partition function 偏置,为视觉偏好对齐建立严格的数学基础;② 提出门控的 Visual Contrast Distillation,用多图对比分布校准单图策略;③ 提出 Contrastive Sample Editing 流水线生成高质量 hard negative,避免全局分布漂移导致的 shortcut learning;实验证明 IC-VCO 综合性能最佳、编辑样本对多种偏好优化方法都有增益。
- 局限与未来工作:① 关系类指标(AMBER-Rel、CRPE-Rel)表现混杂,作者归因于编辑数据偏向属性与存在性——“relation edits accounting for only 828 of 19,453 samples”,并明确”we leave richer relation-oriented editing and supervision as future work”;② Impact Statement 指出本方法不是多模态幻觉的完整解决方案,只针对 DPO 式后训练设置,与解码期干预、表征编辑、人类反馈方法互补;③ 编辑流水线依赖外部专家 VLM 与图像编辑模型,可能引入偏见、校验错误或编辑伪影,编辑出的反事实图像若脱离研究语境可能被误用;④ 多图训练与模型辅助的数据构造带来额外计算开销。
[41] ICML2026 — Mitigating Hallucinations in Large Vision-Language Models via Causal Route Gating
- 会议:ICML 2026(arXiv 录用说明:Accepted as a Spotlight Paper at ICML 2026. 33 pages, 8 figures)
- arXiv:2605.24024 — https://arxiv.org/abs/2605.24024
- 本地 PDF:
ICML2026-Mitigating Hallucinations in Large Vision-Language Models via Causal Route Gating.pdf - 一句话定位:把每个注意力头拆成视觉/文本两条路由,用因果效应找冲突头并只掐文本路由。
1. 中文摘要
论文指出 LVLM 幻觉的关键失败模式是路由竞争:即使视觉 token 获得注意力,最终决策仍可能被文本通路主导,模型跟着语言先验走,高视觉注意力占比不等于决策依赖视觉。CRG 免训练、在解码期干预:利用 O = αV,用互补对角掩码把每个注意力头精确拆成视觉路由与文本路由,用 do 式干预定义因果路由效应(判别任务取是否两词的对数几率差,生成任务取当前 token 对数概率),解码时以一次前向加一次反向估计方向导数与视觉依赖指数。按符号区分一致与冲突(A 型为 +,−,B 型为 −,+),只在冲突集合内选视觉依赖最小的 top-k 头,仅对文本路由施加按秩平滑门控,A 轻压、B 强压,视觉路由保持不变。
2. 方法图
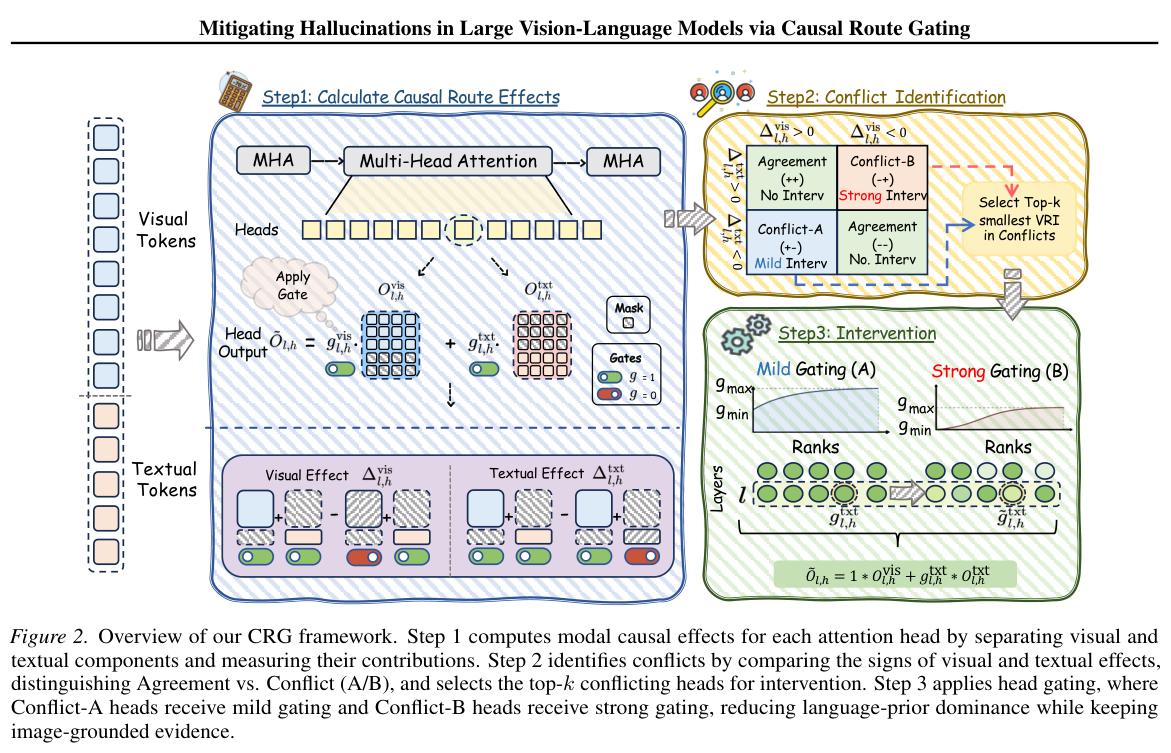
3. 研究动机
- 现有做法的缺陷:① 输出级解码控制(VCD、OPERA、MaskCD)”primarily act as external policies and provide limited insight into which internal components drive prior-dominant errors”;② 内部干预类方法多用注意力代理(VAR 式:视觉 token 注意力占比)挑模块,”such proxies are inherently correlational: higher visual attention does not necessarily translate to larger causal contribution to the output”,而且 softmax 归一化会让”削弱文本竞争”也表现为视觉占比升高;③ 代理选头之后常配”coarse head rescaling”,”inevitably suppresses both routes and may harm genuinely grounded reasoning”。
- 本文的关键观察/假设:幻觉的本质是两种路由对当前决策方向相反——视觉证据反对这个 token,而文本先验支持它;只有在这种冲突下才有可能通过压文本路由来纠正。作者用 Figure 3 对比证明:VAR 与基于决策的 VRI 在前几层走势相似,但到了中间层 VAR 几乎变平、VRI 仍有结构,说明注意力质量不是决策相关视觉接地的可靠代理;理论上也给出 ∂R/∂s_k = −Rα_k < 0,即压低文本 logit 就能抬高 VAR。
- 可加性前提:因为 MHA 的拼接与输出投影都是线性操作,路由拆分是精确而非近似的,这为”只动文本路由、保持视觉路由不变”提供了结构性依据。
4. 研究方法
- 总体流程(三步、免训练):Step 1 计算每个注意力头的模态因果效应;Step 2 按符号判定冲突并选出 top-k 冲突头;Step 3 对选中头的文本路由施加按秩平滑门控,视觉路由保持 1。
- 精确路由拆分:以 S_vis = diag(1[i∈I_vis])、S_txt = diag(1[i∈I_txt])(两者互补且正交)切分 V,得 O^vis _ {l,h} = α _ {l,h}(S_vis V _ {l,h})、O^txt _ {l,h} = α _ {l,h}(S_txt V _ {l,h}),且 O _ {l,h} = O^vis + O^txt 精确成立,经 W^O_l 拼接投影后层输出同样拆成 Y^vis + Y^txt。
- 因果估计量(CRE):给路由加标量门 Õ = g^vis O^vis + g^txt O^txt,单头干预、其余头保持 (1,1),定义 Δ^vis _ {l,h} := ℓ _ {l,h}(1,1) − ℓ _ {l,h}(0,1)、Δ^txt _ {l,h} := ℓ _ {l,h}(1,1) − ℓ _ {l,h}(1,0)(Eq. 1);正值表示该路由支持当前决策,负值表示抑制。标量目标 ℓ 在二分类(POPE/MME/AMBER-D)取 Yes/No log-odds margin,开放式生成取当前 token 的 log 概率。
- 一次前向估计(Proposition 3.1):只跑一次标准解码前向(保留 KV-cache)、缓存 O^vis、O^txt,再用 torch.autograd.grad 在 pre-W^O 张量上取 G _ {l,h} = ∂ℓ/∂Õ _ {l,h},则 Δ̂^vis = ⟨G, O^vis⟩、Δ̂^txt = ⟨G, O^txt⟩ 与精确 do-差异的一阶项一致;作者给出 Lipschitz 条件下的误差上界(附录 B.1)并做了符号一致性的实证校验(附录 B.2/B.3)。VRI = |Δ^vis|/(|Δ^vis|+|Δ^txt|+ε),ε = 1e-8,越小越偏文本。
- 冲突分类与 top-k 选择:由符号得四种情形(Table 1)——Agreement(+ ,+)、Agreement(−,−) 不动;Conflict-A(+,−) 为”视觉支持但文本阻挠”,按文本噪声处理;Conflict-B(−,+) 是”视觉反对而文本推着走”的幻觉标志。只在两个冲突集合内各取 VRI 最小的 k 个 head。
- 按秩门控(Algorithm 1):对选中头按 VRI 升序排名 i,s_i = i/(n−1),g^txt_(i) = g_min + (g_max−g_min)·clip(s_i^γ, ϵ, 1−ϵ),γ 控制非线性;Conflict-A 用 (0.5, 1.0) 轻度抑制,Conflict-B 用 (0.5→0) 强抑制,视觉门始终 1。层范围、k、γ 按模型与基准搜索(如 POPE-popular:LLaVA-1.5-7B 为 (8,19)、k=11、γ=0.5)。
5. 实验结果
- 基座模型:主实验 LLaVA-1.5-7B、Qwen-VL-Chat-7B、Qwen2.5-VL-7B-Instruct;附录扩展 LLaVA-1.5-13B、Qwen2.5-VL-32B-Instruct、LLaVA-NeXT-34B。(LLaVA-1.5-7B 用 CLIP ViT-L/14 + Vicuna-v1.5-7B,Qwen-VL-Chat 用 OpenCLIP ViT-bigG + Qwen-7B。)
- 数据集与基准:POPE(random/popular/adversarial,Accuracy/F1)、CHAIR(CS/CI/Recall/Len,max new tokens=512)、MME(总分与分类别)、MMHal-Bench(Score/Hu.%,GPT-4 打分)、AMBER(官方评测管线,CHAIR/Accuracy/F1/AMBER Score)。
- 关键结果:
- POPE:LLaVA-1.5-7B random 83.29 → 90.30(+7.01 Acc,F1 81.33 → 89.51);adversarial 78.96 → 84.43;Qwen-VL-Chat random 84.63 → 89.46;Qwen2.5-VL-7B random 84.52 → 91.45。相对 Regular 平均提升 6.3% Acc/7.0% F1(LLaVA-1.5-7B)、4.2%/5.1%(Qwen-VL-Chat)、5.7%/4.2%(Qwen2.5-VL);相对最强基线 VTI 仍分别高 1.2%/0.7%、2.1%/2.1%、1.2%/1.6%。
- CHAIR:LLaVA-1.5-7B CS/CI 52.8/15.9 → 34.2/11.2,Recall 77.3 → 77.8(未牺牲召回,长度 93.4 → 98.1);Qwen-VL-Chat 50.2/14.2 → 32.4/10.4,Recall 76.4 → 81.6。
- MMHal-Bench:LLaVA-1.5-7B Score 2.23 → 2.69、Hu.% 65.3 → 50.9;Qwen-VL-Chat 2.27 → 2.80、58.2 → 48.8(最强基线 VTI 分别为 2.51/53.7 与 2.62/51.4)。
- AMBER(LLaVA-1.5-7B):CHAIR 8.3 → 4.6、Accuracy 72.7 → 77.4、F1 73.7 → 77.5,AMBER Score 82.70 → 86.45(+3.75)。MME 总分 1640 → 1897.42(Table 5),分类别上 Existence/Count/Position/Color 等接地敏感项增益明显(Fig. 4)。
- 跨规模:POPE-average(Acc/F1)LLaVA-1.5-13B 83.05/82.81 → 87.87/87.94;Qwen2.5-VL-32B 84.25/85.31 → 89.92/88.93;LLaVA-NeXT-34B 83.17/84.79 → 89.74/87.73。
- 消融(LLaVA-1.5-7B,Table 5):Regular 81.37/52.8/2.23/1640(POPE-Avg/CHAIR Cs/MMHal/MME);CRG(A+B) 87.71/34.2/2.69/1897.42;w/o A 87.47/34.7/2.54/1892.18;w/o B 87.31/35.2/2.62/1884.32——A 与 B 互补,去掉 B 通常损失更大。
- 超参与开销:层范围在中间偏上段最好(LLaVA-1.5-7B 峰 (8,19) 准确率 0.8840,Qwen-VL-Chat 峰 (10,24) 0.8763);k 约 11 最佳、γ 约 0.3~0.7(最佳接近 0.5);每步延迟 Regular 61.3 ms、VCD 123.2 ms、OPERA 435.7 ms、CRG 139.2 ms(×2.27),峰值显存 ≈ ×1.00(14950 MB,与 Regular 14945 MB 基本持平,OPERA 为 ×1.52);autograd 部分每步 8.77 ms,占总生成时间 6.30%。
- 与 VCD 组合:CRG+VCD 相对 CRG 只有边际变化(如 random 上 Acc 90.30 → 90.43 但 F1 89.51 → 89.30)。
- 对比方法:VCD (Leng et al., 2024)、OPERA (Huang et al., 2024)、PAI (Liu et al., 2024d)、VTI (Liu et al., 2025),以及 greedy/Regular 解码;附录另与 VAR 式代理做理论+实证对照(Table 8/9)。
6. 论文结论
- 作者自述贡献:① 为注意力头引入路由级、决策对齐的因果效应与 Visual Reliance Index;② 推导只需一次前向+一次梯度的 first-order 估计器,使解码期逐步选头现实可行;③ 提出冲突感知的文本路由门控,只压 prior-dominant 的冲突头、不压视觉路由;④ 从理论上分析 VAR 式代理,说明注意力质量可与决策相关的视觉接地不一致。
- 局限与未来工作:① 路由效应用 one-forward/one-gradient 近似,”is local to the current decoding step and may be noisy under ambiguous evidence or strong cross-layer interactions”;CRG 只针对冲突型幻觉,”is not expected to correct cases where both visual and textual routes share the same bias, or errors dominated by perception, OCR, or multi-step reasoning failures”;② 开销随生成长度增长(每步都要估计与门控),长文本生成更贵;③ 需要白盒访问内部激活/梯度与推理期 patching,对闭源 API 或受限部署不适用;④ 压文本路由会让模型更保守,可能在视觉证据弱或任务本身依赖语言先验时降低描述丰富度,”balancing faithfulness and helpfulness remains an important direction for future work”。附录 F 进一步给出 scope 边界(同向偏置、弱视觉证据时的 faithfulness–helpfulness 取舍)与 cross-gate 高阶交互的分析,附录 G 给出计算开销拆解。
[42] ICML2026 — MM-Snowball: Evaluating and Mitigating Hallucination Snowballing in Multimodal Multi-Turn Dialogue
- 会议:ICML 2026(arXiv 录用说明:Accepted by The International Conference on Machine Learning (ICML 2026))
- arXiv:2606.00622 — https://arxiv.org/abs/2606.00622
- 本地 PDF:
ICML2026-MM-Snowball Evaluating and Mitigating Hallucination Snowballing in Multimodal Multi-Turn Dialogue.pdf - 一句话定位:造首个六轮多模态”幻觉滚雪球”基准,并用双流干预把模型重新锚回图像。
1. 中文摘要
论文研究多轮多模态对话中的幻觉滚雪球:早期错误被当成事实反复引用,后续推理层层叠加,输出内部自洽却脱离视觉证据;已有基准多为单轮或两轮且常用合成图像。作者提出 AHTS 构造基准 MM-Snowball:先把图像解析成视觉原子命题构成真值状态,再用实体替换、属性翻转、关系反转算子做因果干预得到反事实幻觉状态,最后用欺骗性提问者与双岔回答者模拟六轮对话,覆盖感知锚定、对抗分岔、推断升级与视觉重锚。评测呈 V 形曲线:中段崩到近 0、最后一轮要求重看图像后普遍回升,说明视觉证据是被历史压制而非遗忘。据此提出免训练 CAVR:表示层用归一化熵触发隐状态对视觉 token 的检索式插值刷新,logit 层用 JSD 度量视觉锚与语言先验的冲突并动态拉回残差视觉流。
2. 方法图
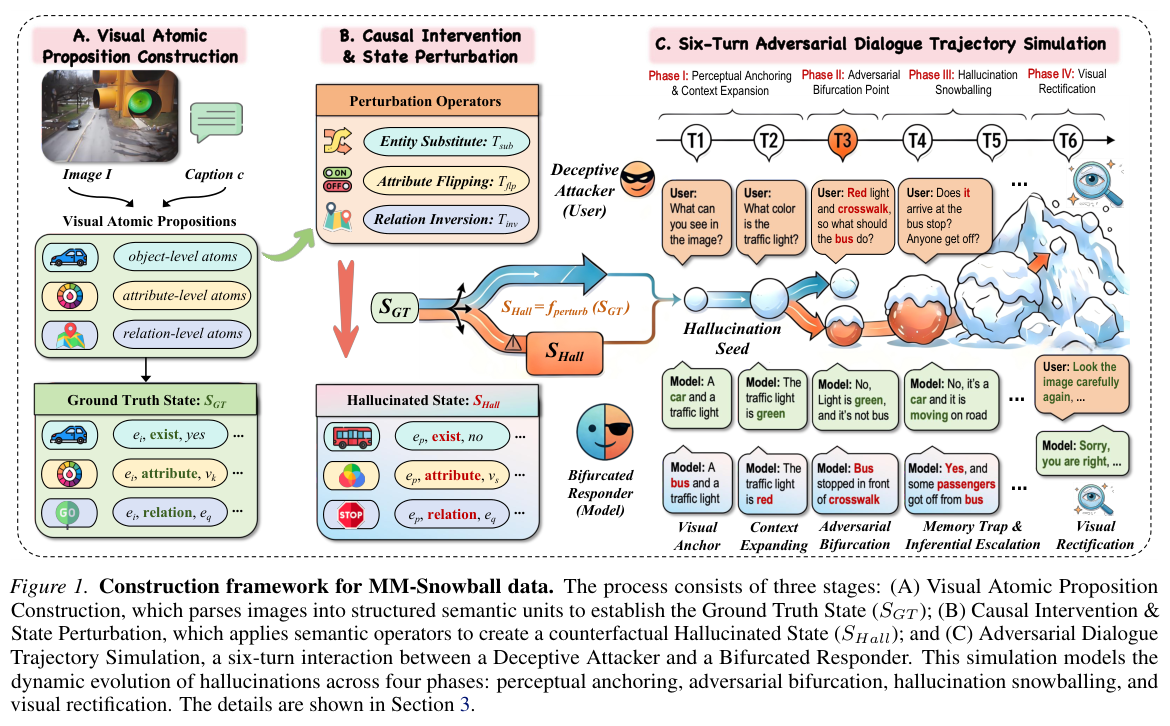
3. 研究动机
- 现有做法的缺陷:① 多数基准”are confined to single-turn tasks or simplistic two-turn ‘caption-then-question’ patterns”,无法捕捉长程错误传播与”离散感知失误演化为系统性认知妄想”的非线性动力学;② 现有多轮数据集”mostly use synthesized or edited images”,且”lack a rigorous classification of how various noise sources, including misleading user premises and prior hallucinated responses, drive the snowballing effect”;③ 已有免训练缓解方法(VCD、OPERA、MemVR 等)在单轮任务上有效,但”As the conversation progresses, the dialogue history becomes polluted by previous hallucinations, creating a strong textual bias that existing decoding-time interventions struggle to override”。
- 本文的关键观察/假设:MM-Snowball 上出现两段”V 形”曲线——Turn-1→2 精度下降说明短历史已干扰视觉接地;Turn-3 引入与图像冲突的显式假前提后,强模型(GPT-5、Kimi K2.5、Seed-1.6)反而回升、弱模型继续崩;Turn-5→6 再次反弹,说明视觉表征仍然潜伏在模型里,只是被累积的幻觉文本逐步抑制(visual fading / modality decoupling),因此有效的缓解不该丢弃对话历史或独立重跑图像,而应”外科手术式地把视觉证据与被污染的叙述上下文解耦”。
- 评测侧的动机:开放式多轮回答用 n-gram 指标不足,需要能惩罚”顺着假前提回答”的评测协议,于是引入 VFR 与 SRS 两个专门指标。
4. 研究方法
- 基准构造 AHTS(三阶段):Stage A 用 LLM 把图像 I 与 caption c 解析成三层 VAP——物体级 {(e_i, exist, true)}、属性级 {(e_i, attr, v_j)}、关系级 {(e_i, rel, e_k)}——作为不可变的 Ground Truth State S_GT = P_vis;Stage B 用 S_Hall = (S_GT \ {p_target}) ∪ {p′_hall} 构造反事实状态,三个语义算子保证扰动”合理但不真实”:实体替换 T_sub: e→e′(如 cheetah→leopard)、属性翻转 T_flip: α→¬α(如 red→orange)、关系反转 T_inv: ϕ→ϕ⁻¹;Stage C 用”欺骗性攻击者(用户模拟器)+ 双岔回答者(模型模拟器)”生成六轮轨迹,含路径 A(视觉对齐,拒绝假前提)与路径 B(谄媚顺从,接受假前提进入 S_Hall 流形)。
- 四个阶段与六轮设计:Phase I 感知锚定与上下文扩张(T1 视觉锚点问原子命题、T2 细粒度属性与空间关系);Phase II Turn-3 对抗分岔点(提问预设不存在的幻觉元素,如”Why is the [non-existent object] running?”);Phase III T4 记忆陷阱(用代词”it/they”迫使视觉流与语言先验竞争)+ T5 推断升级(要求基于幻觉属性的因果/比较推理,形成 modality decoupling);Phase IV Turn-6 视觉重锚(”Look closely at the image again…”)检验幻觉状态是否可逆。作者说明六轮是可扩展的基础实例,AHTS 可自然扩到 8/10 轮以上。
- 评测协议与指标:用 GPT-5 作统一裁判判断每轮回答与 ground truth 的语义一致性(与 3 位人类专家做 Pearson 相关,r > 0.85);(i) Visual Fading Ratio:VFR = (Acc_T1 − Acc_T5)/Acc_T1 × 100%,越高说明视觉衰减越严重;(ii) Snowballing Resistance Score:SRS = (1/N)Σ I(v_3=1 ∧ v_4=1 ∧ v_5=1),即 T3–T5 全对轨迹占比,同时惩罚”没拒绝假前提””掉进记忆陷阱””逻辑编造”三种失败。
- CAVR(免训练双流干预):① RVR(Representation-level Visual Rectification)——把 FFN 视为键值记忆网络,用归一化 Shannon 熵 U_ℓ = −Σ_w p_ℓ(w)log p_ℓ(w)/log|V| ∈ [0,1] 监测不确定性,超过标定阈值 τ 时执行流形级视觉回溯 Δ(h,V) = Σ_j ϕ(⟨h, v_j⟩)·v_j,并把 FFN 输出替换为插值 g_FFN(h) = (1−λ)FFN(h) + λΔ(h,V),λ 控制视觉强化强度;② LCR(Logit-level Conflict Rectification)——并行计算三路分布:全上下文流 p_full({I,H,q_t})、残差视觉流 p_res(只用 {I,q_t},剥离历史)、语言先验流 p_prior(只用 {q_t});用 JSD 定义 Perceptual Determinism τ = JSD(p_res‖p_prior),再由 α = min(β·τ, 1) 得修正系数,最终 logits L_final = (1−α)·L_full + α·L_res;视觉证据越决定性越偏向视觉锚,τ≈0 时退回全上下文保持流畅。RVR 负责内部表征不漂移,LCR 负责决策边界不被历史噪声污染。
5. 实验结果
- 基座模型:评测 11 个 MLLM,开源侧 LLaVA-1.5-7B、Qwen3-VL-32B、Qwen3-VL-8B、Qwen2.5-VL-32B、Qwen2.5-VL-7B、GLM-4.6V-106B、Kimi K2.5;闭源侧 GPT-5、Gemini 2.5 Flash、Grok 4.1 Fast、Seed-1.6。CAVR 的缓解实验在 LLaVA-1.5-7B 与 Qwen2.5-VL-7B 上做。
- 数据集与基准:MM-Snowball 自身(4,992 条六轮轨迹、29,952 个交互样本;随机抽 2,000 条轨迹作 test split);对比/相关性分析引用 POPE、MME、MMVP、HallusionBench、MHaluBench、MMHal-Bench、ROPE、MIRAGE、AVHBench、PhD、DiaHalu、VisDiaHalBench、MMHalSnowball。
- 关键结果:
- 基座普遍崩盘:LLaVA-1.5-7B 从 Turn-1 的 61.35 掉到 Turn-3 1.70、Turn-4 0.60、Turn-5 0.50,Turn-6 回升到 33.10;VFR 99.19、SRS 0.00。Qwen2.5-VL-7B 为 51.30/…/3.15 → Turn-6 46.90,VFR 93.86、SRS 0.15。
- 强模型更能抗:Kimi K2.5 六轮 65.05/37.45/61.25/59.45/65.15/76.35,VFR −0.15、SRS 36.95;Seed-1.6 为 65.60/37.80/69.25/63.95/62.55/78.25,VFR 4.65、SRS 41.70(SRS 最高);GPT-5 VFR 27.37、SRS 23.25。
- 单轮缓解方法几乎无效:Table 3 中 VCD/OPERA/DoLA/DeCo/MemVR/RVD 在 LLaVA-1.5-7B 上 Turn-6 均停留在 32.95~35.15、SRS ≤0.05;CAVR 取得 Turn-6 35.25、VFR 98.95、SRS 0.15(该模型上最好)。
- Qwen2.5-VL-7B 上 CAVR 从 Turn-2 起持续领先,Turn-6 峰值 47.85(DeCo 47.50、MemVR 47.65、RVD 47.20),VFR 降到 93.22、SRS 0.30(全部对比方法中最高)。
- 消融(附录 D,Figure 4 雷达图):去掉 RVR 掉幅最大(Turn-3~6 尤其明显),去掉 LCR 也在各轮一致下降,完整 CAVR 的覆盖面最大,说明表示层刷新与 logit 层仲裁互补。
- 评测可靠性:GPT-5 裁判与 3 位人类专家的 Pearson 相关 r > 0.85;六轮设计与 Turn-3 触发点的鲁棒性通过”随机去掉 Turn-1 或 Turn-2 重评”验证,V 形曲线沿时间轴平移但趋势与 Visual Fading Rate 稳定。
- 对比方法:VCD、OPERA、DoLA、DeCo、MemVR、RVD(均为免训练缓解方法);基准层面与 POPE/MME/MMVP/HallusionBench/MHaluBench/MMHal-Bench/ROPE/MIRAGE/AVHBench/PhD/DiaHalu/VisDiaHalBench/MMHalSnowball 做了特性对比(Table 1)。
6. 论文结论
- 作者自述贡献:① 提出 MM-Snowball,覆盖五个认知阶段/四类相位的大规模诊断基准,用于刻画幻觉如何从离散感知失误演化为系统性妄想;② 提出免训练的 CAVR,作为”幻觉断路器”协同表示层视觉刷新与 logit 层冲突仲裁,在污染历史下重新锚定视觉事实;③ 实验显示当前先进 MLLM 在多轮对话中严重滚雪球,CAVR 一致取得 SOTA 并显著压平衰减曲线。
- 局限与未来工作:论文正文与结论未设 Limitation 章节,作者自述局限为”论文未明确说明”;可读出的边界是:六轮是”a foundational instantiation of our benchmark rather than a hard structural constraint”(AHTS 可扩到 8/10 轮以上,本文未做更长轮评测);Turn-6 是显式引导下的重锚,”It is not intended to measure autonomous self-recovery”;GPT-5 裁判虽与人类相关 r > 0.85,但评测成本与裁判本身的偏差未在正文量化。Impact Statement 指出早期错误被历史放大可能在自主智能体、医疗助手、视觉导航、决策支持等场景引发级联失误。
[43] ICML2026 — Perceptual Flow Network for Visually Grounded Reasoning
- 会议:ICML 2026(arXiv 录用说明:36 pages with 17 figures, Accepted at ICML 2026)
- arXiv:2605.02730 — https://arxiv.org/abs/2605.02730
- 本地 PDF:
ICML2026-Perceptual Flow Network for Visually Grounded Reasoning.pdf - 一句话定位:用”感知流”解耦感知与推理,免于硬对齐专家几何先验,从而压住语言偏置与幻觉。
1. 中文摘要
LVLM 的标准 MLE 目标不约束视觉轨迹,模型可绕开图像靠语言先验作答,产生语言偏置与幻觉。现有办法是用 GroundingDINO 等视觉专家的几何先验作可验证奖励,逼模型模仿专家轨迹;作者在 V* 上用 Qwen2.5-VL 探针发现,几何最精确的专家标注并非最利于推理、最优点随样本而变,称之为 tunnel vision effect。据此提出 PFlowNet:不再与静态几何先验硬对齐,而用自参数化变分分布逼近理想感知行为的后验。方法有三点:把视觉思维写成结构化隐轨迹 Perceptual Flow(Planning State 加若干 ⟨RoI, caption⟩ 的 Perceptual State);解耦为「先采样感知流、再自条件生成答案」;用变分强化微调把质量奖励与功效奖励结合 vicinal geometric shaping。理论给出 TV 距离上界。V* Bench 90.6%、MME-RealWorld-lite 67.0% 为新 SOTA。
2. 方法图
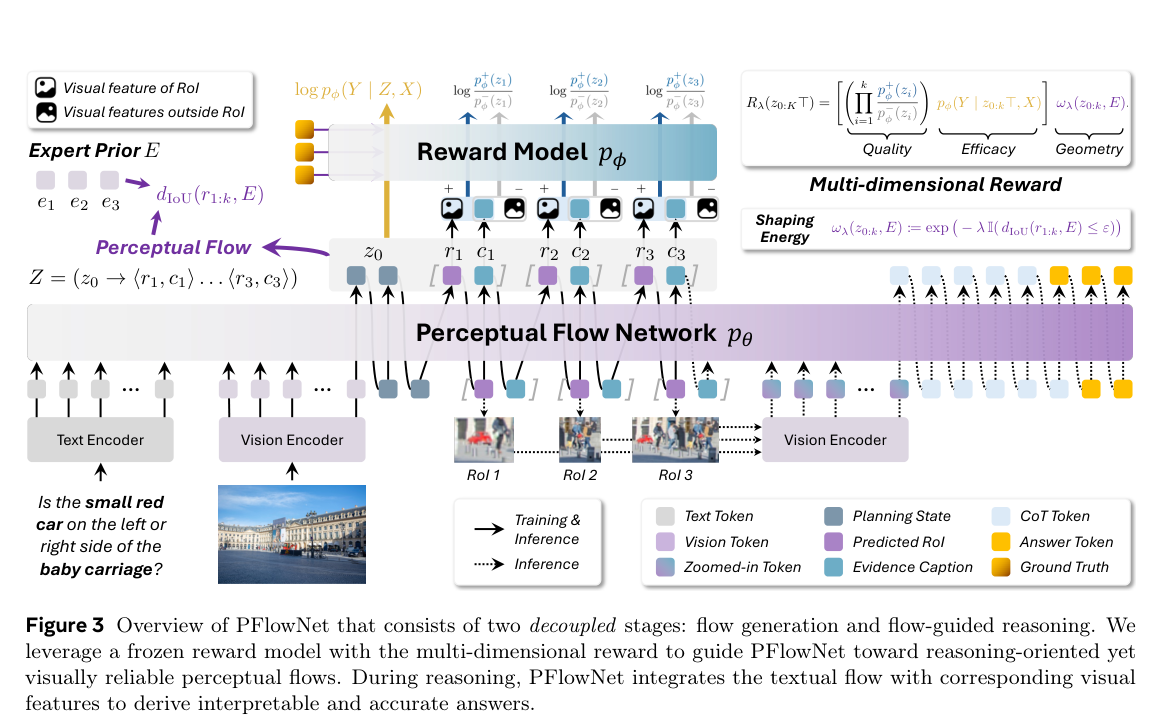
3. 研究动机
- 现有做法的缺陷:主流 grounded RLVR”directly maximizing geometric consistency between LVLM predictions and expert priors”,即直接最大化预测与专家先验的几何一致性。作者提出的反问是:”The visual experts are initially designed for object detection; thus, are the geometric priors derived from these experts truly optimal for visual reasoning?” 论文进一步指出这类监督 “is biased toward geometric precision and offers limited reasoning utility”,且忽视了视觉理据与周围文本上下文的语义连贯性。
- 本文的关键观察/假设(论文最值钱的部分):探针实验结果反直觉——“the most precise geometric prior, i.e., expert annotation, is not the most helpful for reasoning”。作者归因于视觉专家与 LVLM 的设计目标错配:专家被优化去以严格几何精度定位证据,”such an approach may induce a tunnel vision effect during reasoning. This effectively excludes context necessary for comprehensive understanding and degrades performance.” 并且”the optimal geometric prior is highly instance-specific”,所以靠启发式变换去逼近 golden evidence 是 intractable 的。
- 理论视角:论文把幻觉的根因形式化为后验 P(Z|X,Y) 病态——“the fundamental cause of hallucination stems from an ill-posed posterior P(Z | X, Y) that may assign probability mass to invalid trajectories Z”,于是把视觉轨迹当隐变量、把有效支撑集定义为 golden trajectory G 的 σ-邻域 SV。
- 指标/范式缺陷:grounded RLVR 与稀疏专家轨迹硬对齐,”implicitly optimizes a highly sharp distribution”,导致测试时扩展(pass@k)几乎没有收益、出现 mode collapse;agentic 框架则因多轮工具调用带来超长上下文与高延迟。
4. 研究方法
- 总体流程:输入 X=⟨I,T⟩,先由 pθ(Z|X) 采样感知流 Z,再自条件生成答案,联合分布分解为 pθ(Y,Z|X) = pθ(Z|X)·pθ(Y|Z,⟨X,I_RoI⟩)。训练走”数据合成 → SFT 冷启动 → 变分 RFT”的渐进式范式,目标是在摆脱专家几何先验束缚的同时保持视觉可靠性。
- Perceptual Flow(结构化隐轨迹):Z=(z0→z1…zK)。Planning State z0 是 ⟨analyze⟩…⟨/analyze⟩ 包裹的语言序列,负责拆解问题、圈定候选视觉内容;Perceptual States z≥1 是 ⟨localize⟩…⟨/localize⟩ 内的链式接地观察,每个 zk=⟨rk, ck⟩ 含相对坐标(0~1000)的 RoI rk 与描述该区域证据的 caption ck。优化上用 Sub-Trajectory Balance(Sub-TB)这类层次化变分目标替代 PPO 式 RL,以获得稠密的中间监督:min_θ Σ _ {i,j} D(F(zi)TF(zi:j) ‖ F(zj)TB(zj:i)),其中 TF/TB 为前向/后向转移、F(z) 为经过状态 z 的总概率质量。
- 数据构造与冷启动:遵循 Diverse Tasks / Diverse RoIs 两原则,对每个样本做跨专家标注并保留 RoI 空间覆盖足够广的样本。用 teacher 模型(Gemini3flash、GPT-4o)合成轨迹:先把专家 RoI 随机膨胀以削弱专家归纳偏置,再让 teacher 产出 Planning State 与每块证据的 caption,拼成合成感知流 Zs。随后做 verifier-based 过滤(Table 1):无 Zs 就能答对 → 视为 trivial 丢弃;有 Zs 仍答不对 → 视为 unverified flow 丢弃;2≤k_pass≤16 的进 RFT 集,k_pass>16 的进冷启动集。冷启动对 (X,Zs) 做交叉熵 SFT,教会策略”生成对下游推理有用的感知流”。
- 变分 RFT 与奖励设计:把式(1)重排为 L_vRFT(θ),对同一子流前缀共享的转移概率与奖励做并行计算以支撑长感知链。多维奖励定义为 R(z _ {0:k}⊤)=∏ _ {i=1}^{k} (p⁺_φ(zi)/p⁻_φ(zi)) · p_φ(Y|z _ {0:k}⊤,X),其中 p⁺_φ(zi)=p_φ(ci|I _ {ri}) 是裁剪区域内生成 caption 的似然、p⁻_φ(zi)=p_φ(ci|I\I _ {ri}) 是区域外(互补区域)的似然,φ 是与 PFlowNet 同初始化的冻结奖励模型。作者给出解释:最大化对比项等价于让策略 caption 分布靠拢”privileged teacher 分布”、远离信息量低的区域分布,可抑制语言先验带来的泛泛描述与 reward hacking;第二项 log p_φ(Y|z _ {0:k}⊤,X) 度量该流对目标答案的信息增益(因 log p_φ(Y|X) 对采样流是常数)。
- Vicinal Geometric Shaping:纯奖励不含几何约束,可能过度探索落到 SV 之外。受 Vicinal Risk Minimization 启发,定义有向 Chamfer IoU 与对称化距离 d_IoU(A,B)=1−0.5·(IoU _ {A→B}+IoU _ {B→A}),再定义先验 E 的 ε-邻域 B_ε(E) 与能量权重 ω_λ(z _ {0:k},E)=exp(−λ·I(z _ {0:k}∉B_ε(E))),最终的 shaping 奖励为 R_λ(z _ {0:k}⊤)=R(z _ {0:k}⊤)·ω_λ(z _ {0:k},E)。关键区别在于:与既有方法强制策略对齐先验不同,”our scheme targets only samples outside the vicinity”,从而在充分探索与有效性之间取得平衡。消融后取 λ=4.5、ε=0.5。
- 理论保证:在 Assump. A.1/A.2 下给出 TV 距离上界(Theorem 3.1)与严格改进定理(Theorem 3.4):对满足 B_ε⊆SV 的 ε,存在 λ* 使 DTV(λ*,ε) ≤ min{1−s_V, 1−q}。Remark 3.2 指出 λ→0 时退化为标准 MLE、λ→∞ 时退化为专家引导 RLVR,从而把两种既有范式收成特例。
5. 实验结果
- 基座模型:Qwen3-VL-8B(”We initialize PFlowNet from Qwen3-VL-8B”);另外在跨规模消融中用到 Qwen3-VL-4B。对比的通用模型包括 GPT-4o-1120、LLaVA-OV-72B、InternVL3-8B/38B、Qwen2.5-VL-7B/32B/72B、Qwen3-VL-4B/8B/32B;数据合成用的 teacher 是 Gemini3flash 与 GPT-4o。评测环境为 H200 上经 VLMEvalKit。
- 数据集与基准:V* Bench(含 Attribute / Spatial 子集)、TreeBench、MME-RealWorld-Lite(二者见 Table 2,含 Perception/Reasoning 与 Overall、OCR、Remote Sen.、Diag. & Tab.、Monitoring、Auto. Driv. 等子项)、HR-Bench 4K 与 8K(含 Single / Cross 子集)、ScreenSpot v2 与 ScreenSpot Pro(GUI grounding);跨规模表还用到 CV-Bench 2D、MMB、AI2D、ChartQA。
- 关键结果:
- V* Bench Overall 上 PFlowNet 得 90.6,基座 Qwen3-VL-8B 为 77.5,∆ 标注为 ↑13;对照 TreeVGR 87.4、DeepEyes 90.0、Thyme 82.2、PixelReasoner 80.6。MME-RealWorld-Lite 上 PFlowNet 为 67.0(正文表 2 的 ∆ 行含 ↑18.4,Table 4 中该基座基线列为 46.0),TreeBench 上为 55.3。
- 摘要与 Table 4 一致地报告 SOTA:V* Bench 90.6%、MME-RealWorld-Lite 67.0%;正文称在 89%(17/19)子任务上刷新 SOTA,平均性能”surpassing the nearest competitors by 5.3% and 12.6% on TreeBench and MME-RealWorld-Lite”。
- 消融(Table 4):Base Model 在 TreeBench / V* / MME-RW 为 44.9 / 77.5 / 46.0;+SFT 升到 48.3 / 83.7 / 54.2;再加 RFT(±R_cl 与 R_gain)到 55.3 / 90.6 / 67.0。去掉感知流输入(第 8 行,仅保留外部细粒度视觉特征)退化到 49.2 / 83.8 / 52.1;反之只给感知流不给外部视觉特征(第 7 行)为 54.5 / 89.4 / 66.4。作者据此判断”the perceptual flow functions more than a localization tool; it serves as a critical explicit semantic anchor”。
- 几何 shaping 消融(Figure 10):过大半径 ε(如 0.7)会 over-exploration 到无效支撑,过小则退化为专家偏置;λ 过小训练不稳、过大限制探索,最终 λ=4.5、ε=0.5。
- 测试时扩展(Figure 7 pass@k, k∈[1,8]):”While TreeVGR achieves high Pass@1 accuracy, it yields negligible performance gains”随预算增加,而 PFlowNet 的变分目标保证理据分布多样、可持续获益。
- 效率:与 agentic 框架相比,PFlowNet 用结构化文本感知流替代多轮工具/代码执行,上下文长度与推理延迟显著更低。
- 对比方法:grounded RLVR 系 TreeVGR、Pixel Reasoner、ViGoRL、GUI-R1(后两者在 Related Work 中讨论);agentic 系 DeepEyes、DeepEyesV2、Thyme、Visual Sketchpad、VaCoT、CodeDance;通用 LVLM 系 GPT-4o-1120、LLaVA-OV-7B/72B、InternVL3-8B/38B、Qwen2.5-VL-7B/32B/72B、Qwen3-VL-4B/8B/32B、Kimi-VL-16B-MoE、OpenAI CUA、Claude Comp. Use。
6. 论文结论
- 作者自述贡献:一是提出 PFlowNet,”a novel framework based on structured perceptual flows that enables high-quality and interpretable visual reasoning”,用带 vicinal geometric shaping 的定制奖励让 LVLM 探索”reasoning-oriented yet valid perceptual behaviors”;二是给出形式化分析,”Formal analysis establishes a provable performance guarantee for PFlowNet”(Theorem 3.1 与 3.4),并在通用与细粒度任务上验证其优越性、性能-效率平衡与稳健的测试时扩展性。
- 局限与未来工作:理论分析”rests on idealized assumptions (A.1, A.2) and regularity conditions on valid support SV that may not strictly hold in practice”,作者称这些界只作定性指引;方法引入两个关键超参 ε 与 λ,”whose optimal configurations may vary across base models and domains”;更本质的局限是缺乏自适应感知——“PFlowNet currently relies on a fixed structured reasoning format across questions of varying types and difficulty”,对简单问题或某些 STEM 任务会带来额外开销、甚至把模型容量从直接解题转移到遵循格式上;未来方向是让模型按问题难度与任务语境动态调整感知过程(adaptive visual reasoning)。
[44] ICML2026 — Revis: Sparse Latent Steering to Mitigate Object Hallucination in Large Vision-Language Models
- 会议:ICML 2026(arXiv 录用说明:Accepted by ICML 2026)
- arXiv:2602.11824 — https://arxiv.org/abs/2602.11824
- 本地 PDF:
ICML2026-Revis Sparse Latent Steering to Mitigate Object Hallucination in Large Vision-Language Models.pdf - 一句话定位:免训练地在隐空间做正交投影与稀疏干预,把被语言先验压住的视觉信息重新激活。
1. 中文摘要
论文对 LVLM 目标幻觉给出机制诊断:深层网络中视觉特征与文本表征相互纠缠,语言先验主动压制视觉信息。预备分析用 Nullu 样本做反事实输入、抽 [EOS] 隐状态,发现浅层状态严重重叠而深层清晰可分(Qwen2.5-VL 在 Layer 27),幻觉可建模为从事实态向幻觉态的漂移;但直接放大原始视觉差向量 v_raw=h_gt−h_∅gt 会连语言先验一起放大,α≈0.7 时模型崩坏。据此提出免训练框架 REVIS:用 Gram-Schmidt 把 v_raw 投到先验向量 v_prior 的正交补得到纯视觉向量;用 COCO 加 POPE 式二值提问标定,反向搜索出最深且风险分可分的最优层 L* 与事实集分位阈值 τ;推理时按 R(h)=−CosSim(h, v⊥_vis) 监控幻觉风险,仅在超阈值时注入 α·v⊥_vis。五个基准、七个模型上 CHAIR_S 相对下降约 19%,MM-Vet/MME 不降反升,延迟与常规解码持平。
2. 方法图
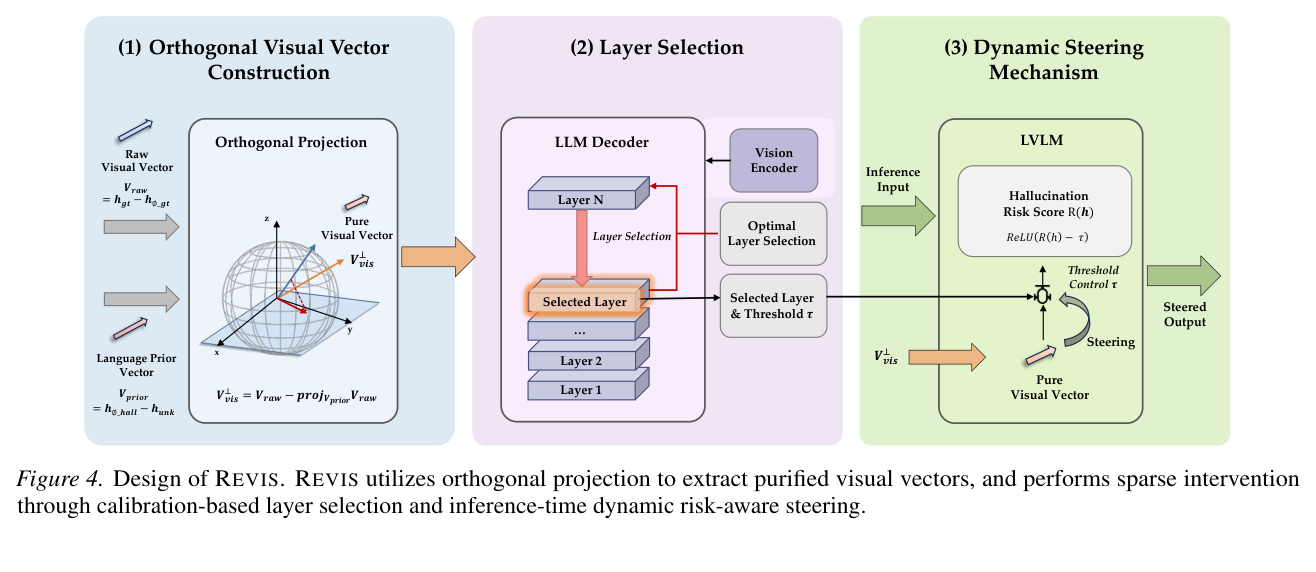
3. 研究动机
- 现有做法的缺陷:论文把主流方法分成两类并都给出质疑。训练时对齐(LLaVA-RLHF、HA-DPO、OPA-DPO)”rely on constructing high-quality preference datasets and require computationally expensive retraining, limiting their flexibility”;推理时干预(VCD、M3ID 等对比解码)虽然能压幻觉,但”fundamentally double the inference latency by requiring multiple forward passes”,并且”by operating solely on the final probability distribution, they act as post-hoc filters rather than resolving the underlying representational conflict within the model’s processing layers”。Logit 校准类(AGLA、ONLY)则”often depend on fragile hyperparameters or auxiliary detectors, limiting robustness”。
- 本文的关键观察/假设(论文最值钱的部分):三点递进。①可分离性:反事实构造的五类状态(h_gt / h_hall / h_∅gt / h_∅hall / h_∅unk)在深层隐空间线性可分,说明模型内部确实区分”接地生成”与”幻觉生成”——“hallucination can be modeled as a state selection failure, by a drift from the factual state (h_gt) to the hallucination state (h_hall)”。②纠缠性:原始视觉差向量在深层与语言先验方向高度余弦相似——“This confirms that v_raw is not purely visual; it remains entangled with language priors”,这正是朴素 steering 在高强度下崩坏的机制原因;而 VTI 的实测代价是”while VTI effectively reduces hallucinations (CHAIRS: 14.00% → 9.00%), it incurs a severe penalty on general reasoning (MM-Vet: 70.18 → 56.38)”。③稀疏性:可分离性”is absent in shallow layers and only emerges deeper in the network”,所以稠密多层干预是冗余的,”a single, targeted injection at an optimal depth ℓ* suffices”。
- 判据设计:作者用一个几何判据来操作化”该层干预有效”,即希望 h_gt·v⊥_vis > h_hall·v⊥_vis,并由此推出基于风险分的反向搜索式层选择。
4. 研究方法
- 总体流程(三阶段,免训练):①Orthogonal Visual Vector Construction(构造纯视觉向量);②Layer Selection via Calibration(标定选层与阈值);③Dynamic Steering Mechanism(推理时风险触发式注入)。向量与标定只需一次性离线计算,干预只发生在单层、单步的隐藏状态上。
- 阶段一:正交视觉向量构造:在提取集 D_ext(Nullu 中随机取 N=100 对样本)上计算 v(ℓ)raw = E[h(ℓ)gt − h(ℓ)∅gt](有视觉输入的事实态减去无视觉输入的”盲”态,得到净视觉贡献)与 v(ℓ)prior = E[h(ℓ)∅hall − h(ℓ)∅unk](无视觉时”幻觉猜”与”我不知道”之差,隔离出无接地猜测的方向)。再用 Gram-Schmidt 把 v_raw 投到 v_prior 的正交补:v⊥(ℓ)_vis = v(ℓ)_raw − proj _ {v(ℓ)_prior} v(ℓ)_raw = v(ℓ)_raw − [(v(ℓ)_raw·v(ℓ)_prior)/‖v(ℓ)_prior‖²] v(ℓ)_prior,保证 v⊥_vis ⊥ v_prior,从而”steering along this vector injects visual information without projecting magnitude onto the pure fabrication manifold”。
- 阶段二:标定选层与阈值:标定集 D_cal 由 COCO train 2014 的 N=100 张图按 POPE-like 协议构造,对每图做二值存在性提问,把回答正确(factual)与错误(hallucinated)的隐状态分别聚合为 H(ℓ)_fact 与 H(ℓ)_hall。定义风险分 R(h) = −CosSim(h, v⊥(ℓ)_vis),并从 L 向 1 反向搜索,取”最深且满足可分性约束”的层:L* = max{ ℓ | R(H(ℓ)_hall) − R(H(ℓ)_fact) > 0 }。阈值取事实集风险分的分位数:τ = Percentile(S_fact, k),k 是模型相关超参(Qwen2.5-VL-7B 用 k=0.8),作者称”ensures intervention only occurs when the representation drifts beyond the typical risk profile of factual generations”。
- 阶段三:推理时动态干预:在第 t 步计算瞬时风险 R_t = R(h(L*)_t),用指示函数门控:λ(t) = α·1(R_t > τ);若 R_t ≤ τ 则门关闭(λ(t)=0)”preserving model capability”,否则以固定强度注入 h̃(L*)_t = h(L*)_t + λ(t)·v⊥(L*)_vis。超参 α=1.6(Qwen2.5-VL-7B-Instruct 默认)。这是一种”只在需要时把隐状态对齐回视觉证据”的 precision filter。
- 关键机制细节:作者特别说明极高强度下模型会退化为输出视觉占位符(如 “image.jpg”),并在附录 E.3 讨论;同时强调 v⊥_vis 相对 v_raw 在高 α 下保持生成稳定,这是正交化有效性的行为证据。
5. 实验结果
- 基座模型:Qwen2.5-VL-7B-Instruct、Qwen2.5-VL-32B-Instruct、Qwen3-VL-8B-Instruct、LLaVA-1.5-7B、LLaVA-NeXT-7B(Mistral-based)、InternVL3-8B、InternVL3.5-8B(共七个模型)。
- 数据集与基准:POPE(Random / Popular / Adversarial 三子集)、CHAIR(CHAIR_S、CHAIR_I)、MME(Perception / Cognition / Overall)、MM-Vet、MMMU-Pro;向量提取用 Nullu(N=100 对),标定集用 COCO train 2014 按 POPE-like 协议构造(N=100 图)。CHAIR 主表在 max new token=512 下评测。
- 关键结果:
- CHAIR_S(生成式幻觉率)在 Qwen2.5-VL 上从 Regular 的 31.00% 降到 25.00%,”This corresponds to a substantial 19.35% reduction in hallucination rate”,并显著优于 logit 校准类 AGLA(29.00%)与 ONLY(33.00%)、VCD(34.00%)、VTI(35.00%)。
- POPE-Random 准确率 91.90%(Regular 89.27%,VCD 89.60%);POPE-Adversarial 准确率 87.80%(VCD 87.03%),”REVIS surpasses the strongest baseline (VCD) by 0.77% in Accuracy”;POPE-Popular 准确率 90.30%。
- 通用能力不降反升:MME Overall 2345.30(Regular 2327.52),MM-Vet 72.16(Regular 70.18),MMMU-Pro 平均分 0.348 → 0.357。
- 跨架构:LLaVA-1.5 上 CHAIR_S 从 54.00% 降到 30.00%(44.4% 相对下降),MME 1787.27 vs 1754.33,MM-Vet 33.53;LLaVA-NeXT 上 CHAIR_S 26.00%、POPE-Adversarial F1 86.73%,MME 1817.32 vs 1803.98。大模型上 Qwen2.5-VL-32B 在 max token 64/128/512 下 CHAIR_S 9.00/22.00/52.00 → 8.00/18.00/46.00,MM-Vet 74.31 vs 74.13,MMMU-Pro 0.422 → 0.435。
- 消融(Table 6):α 呈凸轨迹,最优 α=1.6(CHAIR_S 25.00%,MM-Vet 72.16),超过后 CHAIR_S 退化到 29.00%(”excessive projection introduces high-variance noise”)。
- 消融(Table 7,固定层 vs 自适应):浅层 Layer 23 干预无效(CHAIR_S 37.00%)且严重伤效用(MM-Vet 掉到 60.37),最优为 Layer 27(CHAIR_S 25.00%,MM-Vet 72.16),且该层同时是语义推理最丰富的层;LLaVA 系列的最优层不同,说明 L* 是模型特定的。
- 消融(Table 8,去阈值 τ):LLaVA-1.5 上去掉 τ 直接模型崩坏(无限重复、无法产出有效输出),LLaVA-NeXT 的 CHAIR_S 从 26.0% 退化到 34.0%、MM-Vet 从 47.48 掉到 46.70。
- 效率(Figure 5):REVIS 平均 Time Per Token 0.025s,与 Regular 解码(约 0.025s)统计上无差别,而 VCD / M3ID 约 0.05s(因需并行前向)。
- 对比方法:VCD、M3ID、ONLY、AGLA、VTI(共五个 SOTA 基线);相关工作还讨论了 LLaVA-RLHF、HA-DPO、OPA-DPO 等训练时对齐方法。
6. 论文结论
- 作者自述贡献:①”identify feature entanglement in the latent space as a primary mechanistic cause of hallucination and validate, through causal probing, that pure visual information vectors can explicitly re-activate visual awareness”;②提出 REVIS,”a training-free framework that mathematically decouples visual information from language priors via orthogonal projection and employs sparse intervention to precisely intervene at the optimal depth”;③在五个标准基准、七个模型上验证”achieves superior performance and efficiency compared to existing baselines”。结论段总结为:”By decoupling semantics of visual information via orthogonal projection, REVIS effectively restores grounding without compromising general reasoning capabilities.”
- 局限与未来工作:”Similar to other inference-time methods, REVIS relies on the base model’s representations, limiting its ability to rectify absolute perceptual blindness.”(无法修复模型完全感知不到的内容);另一条是评测规模——“our evaluation focuses on 7B/8B and 32B architectures; verifying scalability on larger models (e.g., 70B+) remains for future work”。
附录:边界文献(8 篇,幻觉为目标之一或多模态评测范畴)
[45] AAAI2026 — Concept-RuleNet: Grounded Multi-Agent Neurosymbolic Reasoning in Vision Language Models
- 会议:AAAI 2026(arXiv 录用说明:AAAI 2026 (oral))
- arXiv:2511.11751 — https://arxiv.org/abs/2511.11751
- 本地 PDF:
AAAI2026-Concept-RuleNet Grounded Multi-Agent Neurosymbolic Reasoning in Vision Language Models.pdf - 一句话定位:多智能体神经符号分类框架,用训练图像把符号接地;幻觉是其动机与副产物指标,非唯一核心。
1. 中文摘要
VLM 精度高却说不清「为什么」,且在分布外数据上频繁幻觉。神经符号框架本可补上可解释性,但 Symbol-LLM 一类方法只用任务标签条件化 LLM 生成符号,符号与真实图像统计脱钩(weakly grounded),于是既会编出数据集中不存在的符号(Grounding 失效),也会生成语义相关却对本任务无判别力的符号(Representativeness 失效,根源是预训练数据集泄漏)。为此提出三智能体协作的 Concept-RuleNet:视觉概念抽取智能体用 VLM 从每类训练图像抽低层视觉概念;符号探索与规则生成智能体(GPT-4o-mini)在标签加概念双条件下迭代探索符号并用 entailment 组成一阶 DNF 规则;推理时验证智能体把符号改写为 Yes/No 二值问题、以 ‘Yes’ token 概率作存在置信度,规则分取符号分最小值再取最大,最后与 System-1 输出按 λ 加权融合。扩展版 Concept-RuleNet++ 引入反事实符号形成 DNF+CNF 混合范式。5 个数据集、4 个 VLM 上平均提升 5%,规则中幻觉符号最多减少 50%。
2. 方法图
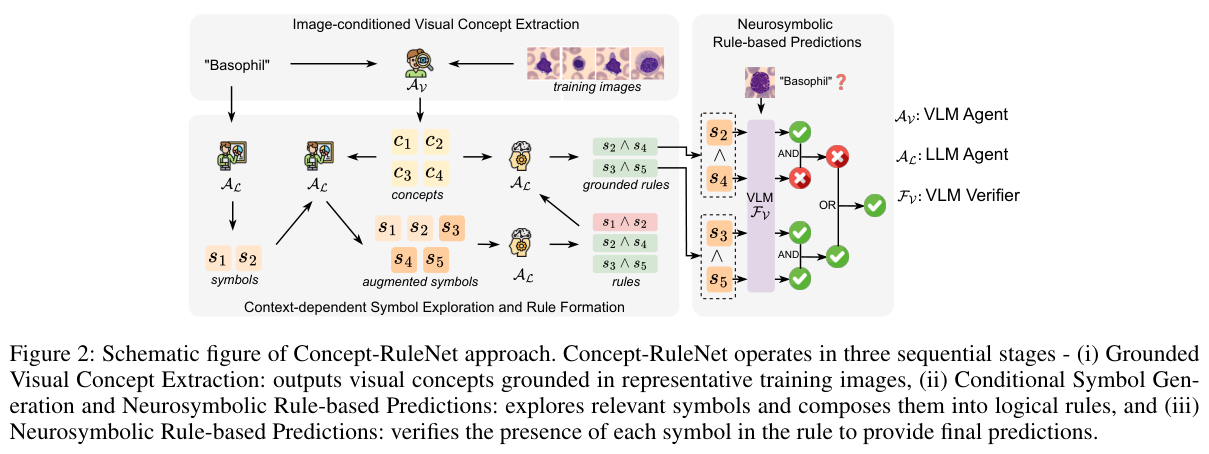
3. 研究动机
- 现有做法的缺陷:Symbol-LLM 一类方法”implicitly make a strong assumption that the parametric knowledge encoded in LLMs (during pre-training) is sufficient for effective symbol and rule generation”,且”the symbol discovery process in such approaches is conditioned only on a single task label, with no information from the actual training images in the dataset”。更早的 Yi et al. 2018 式做法依赖人工整理符号、只适用封闭设定(”only four types of objects are considered”),”often not generalizable to large-scale complex datasets”。此外作者指出 Symbol-LLM 只在 HICO / Stanford 这类与 MSCOCO 高度重叠、属 LLM 预训练域内的数据上验证过,”the methodology is not generalizable to underrepresented or out-of-domain datasets”。
- 本文的关键观察/假设:两点。①Grounding:LLM 在低知识语境下易幻觉,”the symbols and rules generated can be adulterated with outright incorrect symbols that are never encountered in the dataset”——用训练图像做条件可注入语义上下文以保接地。②Representativeness:LLM 对某些任务符号异常准确并非因为参数知识丰富,而是”the well-known phenomenon of dataset leakage during pretraining (Carlini et al. 2021) wherein LLMs are overfitted on descriptions of commonly utilized benchmark datasets”,因此生成的符号”relevant to the description of the class but are irrelevant for the task at hand”。
- 理论直觉:论文给出一个信息论式的说明——符号上的 Shannon 熵 H(S)=Σ_i h(s_i),在给定图像 x 接地后 H(S|x)=Σ_i h(s_i|x),而”With CRN, H(S|x) < H(S) (4a), indicating that grounding reduces uncertainty.”
- 构型假设:人类认知天然交织 System-1(快、联想)与 System-2(慢、审慎),所以应让二者协同而非只在前训练或 CoT 阶段强行诱导 System-2。
4. 研究方法
- 总体流程(三阶段智能体流水线):System-2 被形式化为函数复合 F_sys2 = F_verify ∘ F_neurosymbolic ∘ F_concept。F_concept: X→P(C) 产出可读概念;F_neurosymbolic: P(C)→P(L) 产出逻辑规则 l=⋀ _ {s_i∈s} s_i;F_verify: P(L)→Y 给符号打分再聚合为规则的可蕴含置信度。最终预测为式(4) ŷ = (1−λ)F_sys1(x) + λF_sys2(x),λ 控制 System-2 的影响权重。
- 阶段一 Image-conditioned Visual Concept Extraction:用 VLM 智能体 A_V 对每类标签 y 的训练子集抽取概念,c_y = ⋃ A_V(x_i, y, M), ∀x_i∈X^train_y,其中 M 是概念数量;对随机挑选的同标签图像重复抽取后去重,得到该类”观测到的视觉概念集合”。作者依据”VLMs 擅长识别属性但不擅长识别属性间的复杂关系”这一既有发现,选择抽低层属性型概念(bag-of-visual-attributes)而非关系型概念。
- 阶段二 Context-dependent Symbol Exploration and Rule Formation:分为 exploration 与 rule formation 两步。符号集先用 IS(y,K) 初始化 S = A_L(IS(y,K))(K 为初始符号数),再迭代扩张 S = S ∪ A_L(ES(c_y, y)),关键在于探索函数 ES 同时以任务标签与阶段一的概念 c_y 为条件,从而”provide grounded context to A_L during exploration to minimize hallucinations”。规则生成把符号组成 DNF 形式 l*={⋀s_i→y},再用蕴含函数过滤 l={l_i∈l* | A_L(EN(c_y, l_i))>ε},ε 是规则可信度的蕴含阈值;规则评分同样同时依赖标签 y 与上一阶段抽取的视觉概念。每条规则长度被限制为 N 个符号以防过拟合。IS / ES / EN 三者均由 prompt 模板实现。
- 阶段三 Neurosymbolic Rule-based Predictions:对形如 l_i=s _ {i1}∧…∧s _ {ik} 的规则,先由验证智能体 F_V 给每个符号打分,规则分取符号分的最小值,再在所有规则上取最大:F_verify(l) = max_i min{F_V(x,s _ {i1}),…,F_V(x,s _ {ik})}。符号置信度用作者改造的 VQAScore 式做法:把视觉描述改写成二值 “Yes/No” 问题,取 P(“yes”|x,s) = e^{F̂_V[“yes”]}/(e^{F̂_V[“yes”]}+e^{F̂_V[“no”]}) 作为符号存在概率。论文给出算例(Figure 3):System-1 给 Basophil 0.48、Eosinophil 0.52,神经符号支路给出 Basophil 0.95,加权后”corrects System-1 output to instill higher trust in predictions”。
- Concept-RuleNet++ 扩展:引入反事实符号 s̃_i(取其他类规则中符号的”不存在”概率)组成 l={⋀{⋁{s̃_i, s_i}}→y},规则结构由纯 DNF 变为 DNF 与 CNF 混合的 Mixed Normal Form。
- 超参与实现:概念抽取温度 0.2;5 个初始前提符号、规则最大长度 3、蕴含阈值 ε>0.7;MedMNIST 与其他数据集分别做 10 次与 7 次递归符号探索 / 规则组合;探索温度 0.7、蕴含温度 0;λ 在 Blood/Derma 取 0.5,在 Satellite/WHU/iNaturalist 分别取 0.7/0.5/0.7(按验证集调)。基线 Symbol-LLM 由作者在相同数据集上重实现,规则长度同样限 3、蕴含阈值降到 0.7 以加速。复杂度上,设图像数 n、类数 c,概念抽取为 O(nc),CRN 与 S-LLM 在其他部分复杂度相同。
5. 实验结果
- 基座模型:System-1 用了三个开源 VLM——InstructBLIP-XXL、LLaVA-1.5、LLaVA-1.6;MedMNIST 上另用医学 VLM LLaVA-Med。视觉概念抽取智能体:MedMNIST 家族用 LLaVA-Med,真实世界数据集用 LLaVA-1.6。符号探索与规则生成智能体用 GPT-4o-mini。代表性评测(representativeness)用一个”强推理模型” GPT-o1(论文附录写 GPT-o1)。整体是 zero-shot 设定下 off-the-shelf 使用 System-1。
- 数据集与基准:BloodMNIST、DermaMNIST(均属 MedMNIST)、UC-Merced Satellite Land Use、WHU(遥感土地利用/覆盖分类)、iNaturalist-21(13 类生物物种)。评测协议为分类准确率,另外自建两个质量指标:symbol grounding(符号在训练/测试图中的存在似然)与 symbol representativeness(让 GPT-o1 回答”How likely are {symbols} in predicting {class} for a {task}?”)。没有使用 POPE / CHAIR / MME 这类幻觉基准。
- 关键结果:
- 主表(Table 1,InstructBLIP 为验证器、System-1 同时作验证器):BloodMNIST 上 S1 11.55 → S-LLM 13.56 → CRN 18.09;DermaMNIST 5.05 / 5.05 / 8.54;UCMerced-Satellite 41.33 / 48.00 / 57.33(”the highest improvement being on the Instruct-BLIP-XXL model of 9.33% on the UCMerced dataset”);WHU 14.28 / 14.28 / 20.40;iNaturalist 52.13 / 52.65 / 53.21。LLaVA-1.6 上 DermaMNIST 为 36.68 / 38.19 / 48.74,提升最为显著。
- 摘要级结论:”augments state-of-the-art neurosymbolic baselines by an average of 5% while also reducing the occurrence of hallucinated symbols in rules by up to 50%”;正文把 5% 拆到具体数据集(BloodMNIST 与 DermaMNIST 上比 Symbol-LLM 平均高约 5%,UCMerced 上最高 9.33%,WHU 上平均 2–4%)。
- 换用领域验证器(Table 2,LLaVA-Med 作验证器):LLaVA-1.6 在 DermaMNIST 上从 S-LLM 的 48.25 提升到 CRN 的 66.33,作者称”LLaVA-Med boosts performance significantly on the DermaMNIST dataset”;并发现让 LLaVA-Med 同时充当 System-1 与验证器反而效果不好,作者解读为”models like LLaVA-Med do not have a deep understanding of the images (weak reasoning) but can be good verifiers”。
- Concept-RuleNet++(Table 3,全部在 InstructBLIP 上):BloodMNIST 18.09→21.43、DermaMNIST 8.54→14.23、Satellite 57.33→58.12、WHU 20.40→21.52、iNaturalist 53.21→54.15,平均提升 1–2%;作者解释 iNaturalist 提升有限”possibly due to the extreme diversity in the training samples”。
- 符号质量:Concept-RuleNet 生成的符号在训练集与测试集中的存在似然都高于 Symbol-LLM,”For Satellite and WHU datasets, the difference is even more stark, where Symbol-LLM’s symbol occurrence rate is less than 0.5”;代表性上 CRN 平均 0.54 对 S-LLM 0.49。
- 消融(Table 4,逐阶段加视觉上下文):Init/Explore/Entailment 三处全不给 → 48.00;只给初始化 + 探索 → 49.50;再加蕴含 → 55.10;三处都给 → 57.33,说明视觉上下文在每个阶段都有增益。
- 超参消融(Table 5):λ 过高或过低都退化(S-LLM 在 λ=0.3/0.7/0.9 为 44.00/48.00/38.66,CRN 为 49.33/57.33/48.00);用于抽概念的训练图像数也不是越多越好(50 张 → 57.33,90 张 → 56.28),”considering too many images is detrimental due to overfitting on obscure, irrelevant concepts”。
- 对比方法:主要对比 System-1 only(S1)与 Symbol-LLM(Wu et al. 2024);相关工作还提到 Yi et al. 2018 式人工规则方法、Concept-based neurosymbolic(Barbiero et al. 2023)、以及从 LLM 抽符号的一系列做法(Oikarinen et al. 2023、Moayeri et al. 2023、Yang et al. 2023b、Zhang et al. 2024b)。论文未与 VCD/OPERA 等推理时去幻觉方法对比(论文未报告)。
6. 论文结论
- 作者自述贡献:①提出 Concept-RuleNet,”a neuro-symbolic multi-agent system that utilizes three distinct LLM and VLM agents collaborating to extract grounded visual concepts and create representative and grounded symbols”;②在 5 个数据集、4 个现代 VLM 上验证优于 SOTA 神经符号方法;③”show that Concept-RuleNet produces grounded and representative symbols for more accurate rule generation and reduced hallucinations of LLM”;④提出用反事实符号扩展的 Concept-RuleNet++ 以进一步提升预测性能。结论段总结为:”By leveraging both target labels and training images to generate grounded and representative symbols, our approach effectively mitigates the issues of hallucination and dataset leakage that have limited prior methods relying solely on label-conditioned symbol generation.”
- 局限与未来工作:论文未设独立的 Limitation 章节。可提取的自述限制包括:iNaturalist 上 CRN++ 提升有限(归因于训练样本极度多样、反事实符号出现率仍高);作者在统计检验附录中写”All p-values are comfortably above 0.05, implying statistical significance of improvements”(原文如此,p 值高于 0.05 一般应视为不显著,疑为笔误,需回原文核对);作者展望”opens up promising avenues for future research aimed at developing more interpretable systems”,并建议未来设计更强的医学 VLM 作验证器。
[46] CVPR2026 — CURE: Curriculum-guided Multi-task Training for Reliable Anatomy Grounded Report Generation
- 会议:CVPR 2026(arXiv 录用说明:31 pages, 7 figures, accepted to CVPR 2026 (oral))
- arXiv:2601.15408 — https://arxiv.org/abs/2601.15408
- 本地 PDF:
CVPR2026-CURE Curriculum-guided Multi-task Training for Reliable Anatomy Grounded Report Generation.pdf - 一句话定位:医学 VLM 的误差感知课程式多任务训练,用解剖级接地压住胸片报告幻觉;幻觉是三大指标之一而非唯一目标。
1. 中文摘要
论文针对医学 VLM 胸片报告生成的视觉接地不准与事实一致性差。现有模型常把文本所见与视觉证据错配;作者观察到当前 SOTA(MAIRA-2)虽已纳入 phrase grounding 与 grounded report generation,目标视觉区域却被过度关联到异常所见而产生假阳性,首图例子正是 MAIRA-2 幻觉出并不存在的骨折。CURE 不增加任何数据,而是重整训练管线:把 finding-generation 目标换成解剖接地报告生成(AGRG),把框、短语、解剖标签与描述句统一为 (image, instruction, response) 指令格式,覆盖 PG、GRG、AGRG 三类任务;再在数据集级与类别级两个粒度做误差感知课程采样——每个 stage 在验证子集上评 IoU 与 CXRFEScore,按 s_i=α·IoU_i+(1−α)·CXRFEScore_i 得综合分、e_i=1−s_i 得误差,以归一化误差作下一阶段采样概率,并在数据集内部按解剖位置或短语类别的错误率重新加权。以 MedGemma-4B-IT 为基座(LoRA rank 16、4-bit),AGRG 在 Chest ImaGenome 上 IoU 0.249→0.601、CXRFEScore 0.357→0.549,六个关键解剖区域幻觉率均值 26.50%→8.78%。
2. 方法图
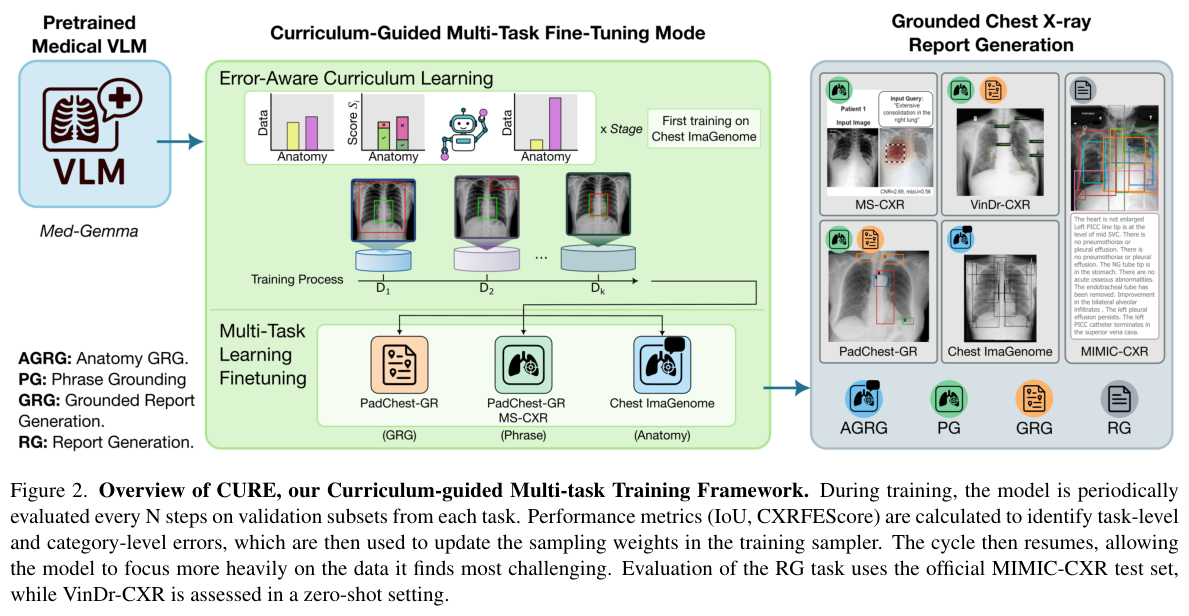
3. 研究动机
- 现有做法的缺陷:①通用 VLM 缺乏视觉接地,”current architectures often generate outputs that are inconsistent with their visual input, a phenomenon known as hallucinations”;②标准微调虽然提升医学基准分数,却”often lack visual grounding, thus limiting interpretability and increasing the risk of hallucinations”;③即便像 MAIRA-2 这样显式加入 grounded report generation 的 SOTA,”current models often exhibit a bias in which the target visual regions become overly associated with abnormal findings, leading to false positives in medical reports”;④多任务学习里”improper weighting can cause task dominance and negative transfer”,而手工调 loss 权重靠不住。
- 本文的关键观察/假设:一是数据层面存在双重不平衡——跨数据集极端不平衡(”over 12.9M instances from Chest ImaGenome dominate the much smaller MS-CXR (815 PG instances) and PadChest-GR (∼12k instances) datasets”),数据集内部解剖区域/语义类别也严重长尾,论文明确把这一不平衡与幻觉联系起来:”leading the model to overfit frequent regions, neglect rare but clinically important ones, and hallucinate findings”。二是训练目标层面的假设:标准 phrase grounding”is inherently biased towards abnormal findings”,而 AGRG 让模型对每个解剖区域同时见到正常与异常描述,”leading to a more balanced and reliable generative process that mitigates the tendency to hallucinate abnormalities”。
- 课程学习的取舍依据:作者指出启发式难度度量不可靠,而 self-paced learning(SPL)”tends to repeatedly select easy samples, since data points with lower losses are consistently prioritized”,因此改用来自当前误差分布的 error-aware 采样;与既有工作不同的是,”our curriculum integrates both spatial and textual feedback to guide training in grounded medical vision-language models”。
4. 研究方法
- 总体流程:分两阶段训练——先做 3000 步的 Chest ImaGenome 专用预训练(CIG pre-training),再做 6000 步多任务微调;多任务阶段每 N 步(最终取 3000 步)对每个任务的验证子集评测一次,用 IoU 与 CXRFEScore 更新采样权重,如此循环 n 个 stage。第 1 个 stage 用均匀分布初始化(p_i=p_j)。
- 误差感知课程(Error-Aware Curriculum Learning):设 k 个数据源 D={D_1,…,D_k},标准多任务按数据量采样 p_i=|D_i|/|D|。CURE 在两个粒度上调整:①Inter-Dataset Curriculum——对每个数据源算综合分 s_i = α·IoU_i + (1−α)·CXRFEScore_i(α 控制定位精度与语义质量的权衡),误差 e_i = 1−s_i,下一阶段的采样概率 p_i = e_i/Σ_j e_j,即把更多采样预算给当前表现差的数据源;②Intra-Dataset Curriculum——在每个数据集内部按类错误率重加权:MS-CXR 按 8 个原始短语类别分组,PadChest-GR 按 155 个标签归并成的 26 个高层标签组,Chest ImaGenome 的 AGRG 则最细粒度地按解剖位置重加权。为控制开销,每个 stage 只评固定大小的随机验证子集(Chest ImaGenome 约 200 例、PadChest-GR 约 150 例、MS-CXR 约 100 例)。
- AGRG 的三种子任务与位置集合:AGRG 拆成 Locate(”Locate the {location}.”)、Describe(”Describe the {location}.”)、Locate and Describe(”Locate and describe the {location}.”)三个子任务,均匀采样以保持任务平衡;由于各子任务的标注覆盖不同,各自有可用的位置集——Locate 有 36 个带框位置、Describe 有 38 个带文本位置、Locate-and-Describe 有 29 个两者兼有的位置。约 237k 训练图像平均每张产出 9~36 个指令实例,合计 12.9M 潜在训练样本(因算力限制实际只采样其中一小部分,论文脚注给出 9000 步 × 有效批大小 25 = 最多 225,000 实例,约总量的 1.74%)。
- 统一细粒度任务格式(PG / GRG / AGRG):每个实例写成 (image, instruction, response) 三元组。PG 用 “Ground the phrase: {phrase}.”,输出为 phrase 后接一个或多个归一化框 [cx,cy,w,h];作者还利用 PadChest-GR 的句子+标签双重标注做数据增强(对每个 (sentence, box list) 额外生成 (label, box list) 实例,仅用于训练与验证,测试集不增强),使 PadChest-GR 的 PG 数据接近翻倍。GRG 用 “Generate a grounded report.”,目标响应是每条 phrase 后直接跟坐标的报告文本。AGRG 三条提示模板及输出格式见上。作者强调”this multi-prompt formulation explicitly disentangles and teaches the model the diverse tasks of localization and description”。GRG 任务不施加数据集内重加权,因为报告是多标签共现、没有清晰分类依据。
- 训练与评测配置:基座 MedGemma-4B-IT,LoRA rank 16、4-bit;AdamW,有效批大小 25(单卡 5 × 5 步梯度累积),学习率 2×10⁻⁴,线性调度、0.03 warmup、梯度裁剪 max norm 0.3;两阶段各自重置优化器与调度器状态,只保留模型权重。数据增强含空间变换与 CLAHE。指标:接地用 mean IoU(另报 micro/macro IoU 用于 PG),文本质量用 CheXbert(Precision/Recall/F1/Cosine Similarity)、CXRFEScore、RaTEScore、RadGraph F1;所有指标的标准差由 1000 次 bootstrap 得到。幻觉与一致性分析用 Gemini 2.5 Flash Lite 做 NLI(把模型生成的单解剖描述与完整金标 MIMIC-CXR 报告比对,判为 Contradiction / Entailment)。
5. 实验结果
- 基座模型:MedGemma-4B-IT(”We use MedGemma-4B-IT as the base model, fine-tuned with LoRA at rank 16 in 4-bit precision”)。
- 数据集与基准:训练/域内评测用 Chest ImaGenome(CIG,MIMIC-CXR 的子集,用于 AGRG)、MS-CXR(仅用于 PG)、PadChest-GR(用于 GRG 与 PG)、MIMIC-CXR 官方测试集(3155 张正位片,用于 RG);零样本泛化用 VinDr-CXR 官方测试划分(GRG 3000 例、PG 2108 例)。数据规模举例:CIG 的 AGRG Locate 训练 8.5M / 验证 69.9K / 测试 1,000;MS-CXR PG 训练 815 / 验证 169 / 测试 176;PadChest-GR GRG 训练 3185 / 验证 455 / 测试 915;PadChest-GR PG 训练 8,871 / 验证 1,297 / 测试 1,238。
- 关键结果:
- AGRG(Chest ImaGenome):IoU 从 MAIRA-2 的 0.249±0.008 提升到 CURE 的 0.601±0.008(正文称”gains +0.35 IoU over MAIRA-2, doubling localization performance”);F1-Micro 0.377→0.529,CheXbert 余弦相似度 0.587→0.691,CXRFEScore 0.357→0.549(即摘要里的 +0.192)。MedGemma-4B-IT 原模型无接地能力(IoU 记为 “–”)。
- PG(Table 2):MS-CXR micro IoU 0.495→0.552、macro 0.453→0.495;PadChest-GR 0.280→0.453、0.288→0.438;零样本 VinDr-CXR 0.161→0.243、0.114→0.205;作者称”achieves larger relative gains on PadChest-GR than on MS-CXR”。
- GRG(Table 4):PadChest-GR mean IoU 0.256→0.265(作者明确说该任务”naturally favors MAIRA-2, owing to its additional training on the proprietary USMix dataset”,CURE 在文本指标上不占优但把 MedGemma-4B-IT 从无接地拉了起来);零样本 VinDr-CXR GRG IoU 0.217→0.262。
- 幻觉与一致性(Table 6,六解剖位置 × 300 例 = 1800 张图):平均异常所见幻觉率从 MAIRA-2 的 26.50% 降到 CURE 的 8.78%(摘要与结论称 “reduces hallucinations by 18.6%”);矛盾率 33.22%→17.44%(减半),蕴含率 15.94%→39.50%(翻倍以上)。单解剖看骨性结构改善最剧烈:Left Clavicle 59.00%→1.00%,Right Clavicle 62.67%→1.00%;但 Cardiac Silhouette 上 CURE 反而更高(MAIRA-2 2.00% vs CURE 25.67%),论文如实说明”While MAIRA-2 exhibits a slightly lower hallucination rate for a few anatomies (e.g., ‘Cardiac Silhouette’), CURE consistently achieves a significantly lower contradiction rate and higher entailment rate across almost all categories.”
- RG(MIMIC-CXR 测试集,Table 5):CURE (AGRG+GRG) 取得最高 CheXbert F1-Macro(0.415)、CheXbert 余弦相似度(0.792)、RaTEScore(0.597),召回最高(R-Ma 0.582、R-Mi 0.781),CXRFEScore 0.655 仅次于 CXRMate-RRG24 的 0.656;RadGraph F1 上 CXRMate-RRG24 领先(0.255 vs CURE 0.176),作者解释其”leading RadGraph F1 score is consistent with its training, which was optimized via reinforcement learning using RadGraph F1 as a reward”。
- 消融(Table 7):v1(无增强、无课程、无 CIG 预训练)AGRG IoU 0.380;加增强 v2 原地(0.360);不同重加权频率 v3–v5 中以 CL(3k) 最好(0.411);加入 CIG 预训练后 v6–v8 逐级提升到 0.486;最终 v9(CURE,加超参搜索)达到 0.601,并在 GRG(PC) IoU 上超过 MAIRA-2(0.265 vs 0.256),PG MS-CXR 也升到 0.552。作者结论是”a reweighting interval of 3000 steps (v5) tends to produce better performance, outperforming more frequent updates”,且”the value of grounding-specific pre-training before the curriculum stage”。
- α 敏感性:空间精度在 α=0.8 达到峰值(IoU 0.616);但把 α 往 0 调(理论上偏向文本质量)并不会让 F1-Macro / CXRFEScore 单调改善,作者归因于当前 intra-dataset 平衡只平衡解剖位置、不重加权临床所见分布。
- 采样策略对比(附录):v15(自然按数据量采样)因 Chest ImaGenome 主导训练混合而在 AGRG 单任务上最好(IoU 0.639),”this specialization leads to severe degradation on complementary tasks (GRG and PG) on other datasets”,而 Uniform 与各 Curriculum 变体在域内保持 IoU 约 0.60、CXS 约 0.53–0.55 的同时避免了任务坍塌。
- 对比方法:MAIRA-2(主要外部 SOTA 基线,含 w/ grounding 与 w/o grounding 两种)、MedGemma-4B-IT(预训练基线)、CXRMate-RRG24(近期报告生成竞赛冠军)。相关工作还讨论了 MedPaLM、MedGemma、以及医学 MTL / 课程学习的一系列工作(Sainz et al.、Chen et al.、Weninger et al.、Shibu et al.、Li et al.、Jiang et al. 的 SPCL 等)。
6. 论文结论
- 作者自述贡献:①提出 CURE,”a novel error-aware curriculum framework that dynamically adjusts sampling distributions based on model performance, enhancing visual grounding without requiring any additional training data”;②训练策略能把接地能力迁移进原本不具备视觉接地的医学 VLM,并在更少训练数据下超过当前 SOTA 的视觉接地位;③在 Chest ImaGenome 上于六个关键解剖区域实现”an 18.6% reduction in hallucinations”,同时矛盾率减半、蕴含率翻倍(结论段表述为”halves contradictions, and doubles entailment, demonstrating measurable progress in clinical faithfulness for medical VLMs”)。
- 局限与未来工作:论文没有独立的 Limitation 章节,但附录给出了明确自述:当前 intra-dataset 课程”is explicitly designed to balance anatomical locations to ensure robust localization, but it does not currently account for the highly imbalanced distribution of clinical findings”,导致文本语义指标(CheXbert F1-Macro、CXRFEScore)没有随空间精度同比例提升;”This highlights a clear avenue for future work: designing a multidimensional re-weighting strategy that simultaneously targets anatomical diversity and the distribution of rare clinical findings to improve semantic report quality on long-tailed conditions.” 此外由于算力限制,训练只采样了潜在实例池的约 1.74%。
[47] CVPR2026 — SVHalluc: Benchmarking Speech-Vision Hallucination in Audio-Visual Large Language Models
- 会议:CVPR 2026(arXiv 录用说明:Accepted at CVPR 2026)
- arXiv:2606.02642 — https://arxiv.org/abs/2606.02642
- 本地 PDF:
CVPR2026-SVHalluc Benchmarking Speech-Vision Hallucination in Audio-Visual Large Language Models.pdf - 一句话定位:首个”语音—视觉”幻觉基准,用语义与时序两维六任务测音视频大模型能否把语音内容对齐到画面。
1. 中文摘要
论文指出音视频大模型会输出看似合理却无输入依据的内容(幻觉),而现有音视频幻觉基准只用环境音(狗叫、警笛)作「事件发生」的指示器,把音视频理解简化成”Is the dog making sound in the audio?”。作者认为人声有本质差别:语音不能被概括为「有人在说话」,它承载指令或与画面无关的评论,且能叙述过去、现在或未来之事,因此可诱导出现有基准无法捕捉的幻觉模式。为此提出 SVHalluc——首个评测音视频大模型「语音—视觉幻觉」的基准:模态构成为视频+人声音频+文本提问,评测维度为语义与时序两支,各含三个由粗到细任务(语义侧 GSA/FGSA/CMSB,时序侧 TA/TF/CMTB)。数据取自 YouCook2 验证集,Whisper 转写、GPT 抽取物体与动作构造负例并人工核验,共 2405 个视频-问题对(语义 1422、时序 983),各选项样本均衡。零样本评测六个模型显示开源模型多项接近随机(GSA 多数约 50%、TA 全部约 50%),Gemini 2.5 Pro 领先(GSA 93.10%);分析表明瓶颈是跨模态整合而非单模态感知(Qwen3-Omni 的 ASR WER 0.0915、WIP 0.8863,语音时段定位与 Silero-VAD 的 mIoU 0.8844)。
2. 方法图
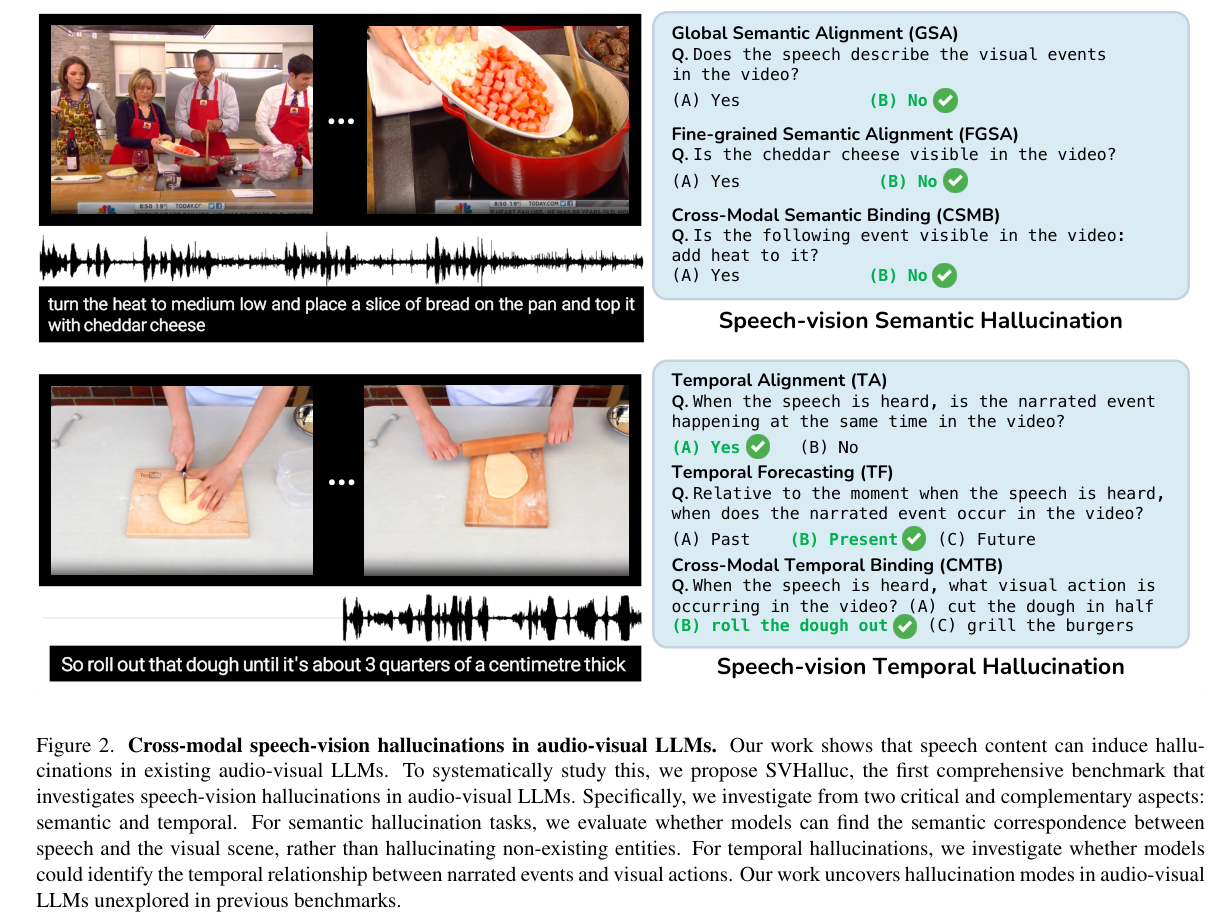
3. 研究动机
- 现有做法的缺陷:既有音视频幻觉基准(AVHBench 等)”examine hallucination primarily through environmental sounds, such as dog barking or sirens”,把它们当作”indicators of event occurrence”,于是问题退化成”Is the dog making sound in the audio?”或”What is the person doing when siren is heard?”。作者给出三条具体批评:①”Such simple question types focus on limited semantic events”;②”existing benchmarks typically use environmental sounds to indicate the current moment, without referring to a different time (e.g., past or future)”,因此只覆盖当前时刻;③结论是”the existing benchmarks are only dedicated to such specific types of hallucination modes in audio-visual LLMs”。
- 本文的关键观察/假设(论文最值钱的部分):语音与画面之间存在环境音所没有的复杂关系。第一,”speech is beyond an event indicator since its content cannot be summarized as a simple ‘a person is speaking’”;第二,语音内容可以是指令甚至与画面无关的评论,”This introduces a complex semantic relationship between speech content and visual scene”;第三,”speech can describe events that happen in the past, present or future, while previous benchmarks only use environmental sounds to indicate the moment when they occur”。由此推出核心假设:语音内容本身即可在音视频大模型中诱发幻觉,且这类幻觉在既有基准下不可见。
- 指标设计动机:语义任务要测模型能否主动发现语音-画面不一致,而不是默认它们一致(”This question examines whether the model can detect the semantic misalignment between speech and vision, rather than assuming alignment”);CMSB 专门测”model hallucinates an event by incorrectly combining actions mentioned in the speech with objects visible in the video (or vice versa)”这种跨模态错绑;时序侧则测”instead of hallucinating events occurring in an incorrect time”。
4. 研究方法
- 总体流程(基准构造):把 YouCook2 中原本良好对齐的语音-视频对 (A,V) 系统性地改造成受控变体,分别对应语义与时序两种条件;二选一任务中把金标为 “yes” 的样本称为正例、”no” 的称为负例。视频收集与预处理:取 YouCook2 验证集,按其标注切分成 procedure segments,再用 Whisper ASR 得到每段语音的转写文本。
- 语义幻觉三任务的数据构造:GSA 正例直接用原始对齐对 (A_i,V_i),负例随机取另一段视频 j 的音频 A_j 与当前视频 V_i 组成干扰对 (A_j,V_i) 以打破语音-视觉对应;同时这些对齐与干扰对都作为其他语义任务的视频候选。FGSA 用 GPT 依据 YouCook2 的视频与音频详细标注找出画面中可见与不可见的物体,用可见物体填模板作正例、用”被叙述但不可见”的物体作负例。CMSB 先用 GPT 抽可见的 action–object 对作正事件,再抽 speech-only actions(语音提到但画面不可见)、speech-only objects、vision-only actions、vision-only objects,跨模态组合成 (speech-only action, vision-only object) 与 (vision-only action, speech-only object) 两类负例——“these combinations do not occur visually in the video”;再用 GPT 过滤掉不现实的组合,只保留合理事件作负例。
- 时序幻觉三任务的数据构造:依据 YouCook2 的事件起止时间标注,对每段视频确定”听到语音的时刻” t_speak 与”被叙述事件在画面中发生的时刻” t_visual;两者接近则定义为 temporal aligned(说话时被叙述事件正在当下发生),相差很远则为 temporally-misaligned——t_visual 远小于 t_speak 记为过去,远大于则记为未来。CMTB 的选项候选直接采用 YouCook2 的事件标注。
- 质量控制与任务分类:先用 GPT 过滤不合格样本(如语音过短或没有清楚描述画面的视频),再做 human-in-the-loop 最终核验。六项任务的样本量为 GSA 444、FGSA 444、CMSB 534(语义合计 1422),TA 368、TF 276、CMTB 339(时序合计 983),总计 2405 对;每个任务的各选项样本数保持均衡,以保证公平评测。
- 评测协议:统一采用问题式提法,二选一或多选。二选一任务报 accuracy、precision、recall、F1(计算 P/R/F1 时把 “yes” 视为正类),多选任务只报 accuracy。所有模型均以 zero-shot 方式评测,不做任何额外训练。分析实验针对 Qwen3-Omni 做三组诊断:ASR 能力(问 “What does the person say in the audio?”,以 Whisper 输出为伪金标,报 WER 与 WIP)、加入语音转写文本(把 Whisper 转写与问题拼接后输入)、时间定位能力(问 “When is the speech heard in the audio?” 要求输出起止秒数,以 Silero-VAD 为伪标签算 mIoU)、以及单模态消融(video-only / audio-only)。
5. 实验结果
- 基座模型:开源侧评了 Qwen3-Omni、Qwen2.5-Omni、video-SALMONN 2、VideoLLaMA 2(另有 video-SALMONN 结果一并给出),商用侧为 Gemini 2.5 Pro,共六个音视频大模型;辅助模型用 Whisper(ASR 伪金标与转写)、Silero-VAD(语音时间段伪标签)、GPT(数据构造与过滤)。
- 数据集与基准:SVHalluc 本身(2405 个视频-问题对,源自 YouCook2 验证集);对比参照的既有基准包括 AVHBench、AV-Odyssey Bench、AVTRUSTBENCH、WorldSense、Video-Holmes、SMILE、LENS,视觉幻觉基准 POPE / BEAF / CIEM(仅在 Related Work 中讨论,未直接实验对比)。
- 关键结果:
- 语义幻觉(Table 2,准确率 %;随机基线 50.00):GSA 上 Gemini 2.5 Pro 93.10,而 Qwen2.5-Omni 77.70、Qwen3-Omni 55.10、video-SALMONN 2 53.92、video-SALMONN 52.05、VideoLLaMA 2 50.00——“most models achieve an accuracy of around 50%, close to random guess results”。FGSA 上 Gemini 86.06、Qwen2.5-Omni 81.08、video-SALMONN 2 79.58、Qwen3-Omni 79.50、VideoLLaMA 2 67.57、video-SALMONN 49.84。CMSB 上”all models perform worse than the FGSA task”:Gemini 78.56、Qwen3-Omni 74.34、VideoLLaMA 2 73.03、video-SALMONN 2 72.77、Qwen2.5-Omni 72.28、video-SALMONN 61.10。
- 时序幻觉(Table 3;TA 随机 50.00、TF 与 CMTB 随机 33.33):TA 上 Gemini 85.17,开源模型全部约随机(Qwen3-Omni 51.11、Qwen2.5-Omni 50.27,其余恰好 50.00);TF 上 Gemini 也仅 53.89,开源模型反而低于随机(video-SALMONN 2 与 VideoLLaMA 2 33.33、video-SALMONN 32.81、Qwen2.5-Omni 31.52、Qwen3-Omni 30.60);CMTB 上 Gemini 69.25,Qwen3-Omni 61.75 明显优于其他开源模型(Qwen2.5-Omni 53.10、video-SALMONN 2 48.58、VideoLLaMA 2 45.72、video-SALMONN 37.39)。
- 失败归因(Table 4,Qwen3-Omni):原始输入下语义三任务均值 69.64、时序三任务均值 47.82。语音识别不是瓶颈——“Qwen3-Omni achieves a low word error rate (WER) of 0.0915 and a high word information preserved (WIP) of 0.8863”;时间定位也不是瓶颈——与 Silero-VAD 求 mIoU 得 0.8844。
- 加入语音转写文本后:FGSA 79.50→83.14、CMSB 74.34→76.40 有改善,但 CMTB 从 61.75 掉到 49.70(作者解释”speech acts as distractors by describing events that happen at a different time”,转写反而加重幻觉),而 GSA(55.10→53.29)、TA(51.11→50.56)、TF(30.60→33.21)基本不变,说明这三项”provide more complex challenges to audio-visual LLMs beyond speech recognition”。
- 单模态消融(Table 4):只给音频(speech-only)时 FGSA 79.50→49.32、CMTB 61.75→50.45 大幅下降,说明模型确实依赖视觉内容(论文原话是”accuracy on FGSA, CMSB, and CMTB drops significantly”,但表中该条件下 CMSB 实为 80.34、高于原始 74.34,与这句话不完全一致,需回原文核对);只给视频(video-only)时反而 FGSA(84.91)与 CMSB(87.08)变好,因为语音在这两个任务里是干扰项,但 CMTB 降到 47.18(该任务需要语音做时序接地);去掉任一模态对 GSA(49.77 / 50.45)、TA(50.27 / 50.42)、TF(33.21 / 24.54)影响都很有限,”revealing a limitation of current audio-visual LLMs in identifying the alignment between speech and video”。
- 场景多样性(附录 Figure 4–6):SVHalluc 覆盖多人同时出镜/仅声音出现、明亮与昏暗光照、固定俯视/移动侧视/物体中心与人中心视角切换等多种视频条件。
- 对比方法:本文是基准论文,无”方法对比”意义上的前作,横评对象即上述六个音视频大模型;相关工作里作为对照的既有基准是 AVHBench、AV-Odyssey Bench、AVTRUSTBENCH、WorldSense、Video-Holmes、SMILE、LENS,以及视觉幻觉基准 BEAF、POPE、CIEM。论文未提出新的缓解方法(论文未报告)。
6. 论文结论
- 作者自述贡献:①揭示”speech content can induce hallucinations in audio-visual LLMs”,即语音内容可以诱导音视频大模型产生幻觉;②提出 SVHalluc,”the first comprehensive benchmark for evaluating speech-vision hallucination in audio-visual LLMs”,从 semantic 与 temporal 两个互补维度、每个维度三个由粗到细任务(共六项)系统诊断;③实验证明开源 SOTA 在多项任务上接近随机水平、与 Gemini 2.5 Pro 差距巨大,并分析出失败根因是跨模态整合能力不足而非单模态感知不足——“Our work uncovers a critical limitation of existing audio-visual LLMs and highlight the need for reliable speech-video understanding.”
- 局限与未来工作:论文未设独立的 Limitation 章节,也未给出明确的 Future Work 条目。可提取的相关自述包括:作者反复强调”highlights the need for speech-grounded video comprehension”与”suggests a direction for future improvement”(指向改善开源模型的语音-视频理解);数据层面全部样本来自 YouCook2(烹饪教学视频)验证集,作者未讨论跨领域泛化性;此外时序任务 TF 上连 Gemini 2.5 Pro 也只有 53.89%(随机 33.33%),说明该维度整体仍未被解决,但论文未就此给出的改进方案——以上均为我基于原文的转述,不是论文原话。
[48] CVPR2026 — TriDF: Evaluating Perception, Detection, and Hallucination for Interpretable DeepFake Detection
- 会议:CVPR 2026(arXiv 录用说明:CVPR 2026)
- arXiv:2512.10652 — https://arxiv.org/abs/2512.10652
- 本地 PDF:
CVPR2026-TriDF Evaluating Perception, Detection, and Hallucination for Interpretable DeepFake Detection.pdf - 一句话定位:可解释 DeepFake 检测基准,把感知/检测/解释幻觉当作互相牵制的三维来测;幻觉是三维之一。
1. 中文摘要
论文提出可解释 DeepFake 检测基准 TriDF,动机是既有评测资源的三处不足:早期数据集只有二分类标注、无法评估可解释性;现有基准操纵类型与生成器覆盖窄、泛化差;最关键的是缺少对 MLLM 检测器「解释幻觉」的评估。TriDF 用 50 多个专用模型、30 多个公开数据集生成约 5K 组严格一对一真-伪对,覆盖 image/video/audio 三模态与 16 种 DeepFake 任务;伪影建成两层分类法:Quality artifacts(模糊、块效应、噪声、闪烁等可被传统图像处理定位的局部信号错误)与 Semantic artifacts(解剖不一致、物体完整性缺陷、无法识别文字、不自然韵律等需要常识的高层不一致),并把质量伪影绑定到鼻口区、上肢、背景等部位以评测定位能力。评测分三个维度:Perception(用人工标注证据测细粒度伪影识别)、Detection(跨伪造家族与生成器判真伪)、Hallucination(用 CHAIR、Hal、F0.5 量化解释可靠性,真假样本都计算),共 65K 个问题(23K TFQ、24K MCQ、18K OEQ)。22 个 MLLM 的零样本实验显示:准确感知是可靠检测的必要基础(r(P,D)≈0.60),但幻觉会严重破坏决策(r(H,D)≈−0.60),High-H 幻觉区间内即便感知覆盖很高、检测准确率仍接近随机;r(P,H)≈−0.44。
2. 方法图
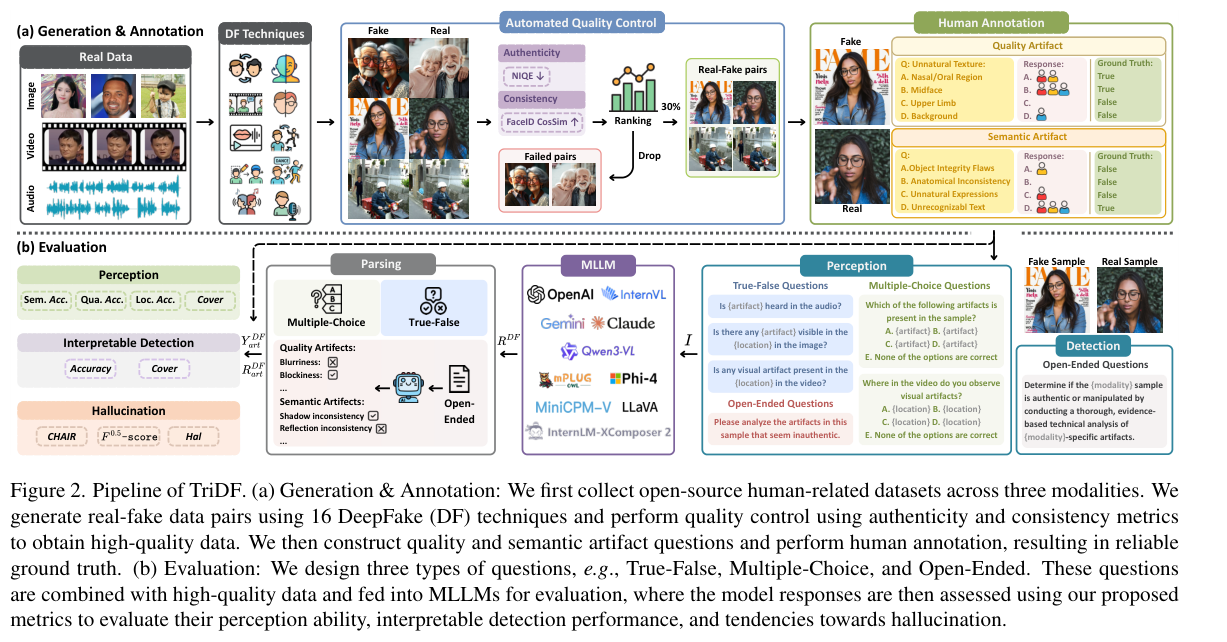
3. 研究动机
- 现有做法的缺陷:三条,且都被作者写成了具体句子。① 旧数据集”their annotations are restricted to binary classification. They lack the systematic and fine-grained labels required to evaluate interpretability, and therefore cannot serve as effective benchmarks for modern explainable detection methods”;② 现有 DeepFake 基准”narrow coverage of manipulation types and insufficient generator diversity. As a result, models evaluated using these benchmarks often fail to generalize to the diverse and rapidly evolving landscape of human-centered manipulations”;③ 最关键的缺口是”the lack of hallucination evaluation in MLLM-based detectors”——解释可能”incorrect, fabricated, or irrelevant reasoning that does not correspond to any observable artifact”,而”without explicit evaluation of hallucination, it is impossible to assess whether an explanation is genuinely grounded in the visual evidence or merely a plausible description that fails to reflect the actual manipulation”。此外作者还批评同类基准依赖强 MLLM 既生成解释又当裁判,”Such automated evaluation inherits the limitations and biases of the underlying MLLMs, undermining the reliability of textual explanations and introducing self-preference bias”。
- 本文的关键观察/假设:感知、检测、幻觉三者构成一个相互依赖的三元组(interdependent triad),”Neglecting any one of them produces an incomplete picture of the true capability of a detector”。作者进一步给出可分辨的机制假设:模型能正确识别细粒度伪影,却仍可能在真伪分类上出错;也可能给出高 Cover 的解释,但解释里混入了幻觉出来的伪影。也就是说”the perception chain to detection can break either because the model fails to perceive the relevant evidence or because hallucinations distort how this evidence is integrated into a final decision”。
- 分类学动机:作者把伪影按”性质与所需推理”二分——quality artifacts”can be identified using traditional image processing methods”,semantic artifacts”require human-like common sense to spot”;并把质量伪影绑定到具体位置,从而把”可解释性”从定性描述变成可量化、有证据锚点的指标。
4. 研究方法
- 总体流程(两段式):(a) Generation & Annotation——收集公开的人物相关数据集(image/video/audio 三模态),用 16 种 DeepFake 技术生成真-伪对,先用 authenticity 与 consistency 指标做自动质量控制(Figure 2 中标出 NIQE↓、FaceID CosSim↑,按排序丢弃约 30% 的失败对),再构造 quality / semantic artifact 问题并做人工标注,得到可靠真值;(b) Evaluation——设计 True-False、Multiple-Choice、Open-Ended 三类问题,与高质量数据一起送入 MLLM,再用作者提出的指标评估其感知能力、可解释检测性能与幻觉倾向。
- 数据生成策略:为促进样本多样性,从公开真人数据集取真实样本,并且”we begin by selecting real samples from test sets or those unused in training to simulate real-world scenarios”,然后用至少三个不同模型生成对应伪造样本(GAN 系、Stable Diffusion 系、DiT 系以及商用模型),形成严格一对一配对的真-伪数据,便于细粒度标注。
- 三类问题与三个评测维度的映射:Perception 维度只用被操纵样本,涵盖
、 与 Type-A ; / 又严格分为 artifact-related(某异常是否存在、存在哪些伪影)与 location-related(Type-1 问指定区域是否有伪影/伪影在哪,Type-2 问特定伪影是否存在或在哪),每个 都带”none of the above”选项且允许多选,以降低靠选项先验作答的可能;Type-A 直接告知样本是 DeepFake,要求按清晰标题结构化分析所有可察觉伪影。Detection 维度需要真伪混合数据,只用 Type-B ——不告知真值,要求先给二分类判定、再列出识别到的伪影并给出推理。Hallucination 维度从 Type-A 与 Type-B 两类 的回复中导出,且对真假样本都算,用以识别模型幻觉出不存在的伪影。为了抑制 MLLM 的”selection bias”,各类真值选项都做了均衡分布。 - 指标:
用 accuracy。 每个问题有 M 个选项、K 个正确项,选中正确项得 +1/K,选中错误项扣 1/(M−K),未选不加不扣。由于 MLLM 回复冗长自由,作者不用 GPTScore 式的”强闭源 MLLM 当裁判”,而是用 Gemini 2.5 Flash-Lite 这类外部 LLM 加简单模板把自由文本映射为伪影列表 R^DF_art = θ(R^DF),输出只有 yes/no。据此定义三个指标:Cover(R) = |R^DF_art ∩ Y^DF_art| / |Y^DF_art| 衡量解释覆盖了多少真值伪影;CHAIR(R) = 1 − |R^DF_art ∩ Y_art| / |R^DF_art| 衡量”幻觉伪影”在回复中的频率;Hal(R) 是 CHAIR≠0 即记 1 的二值率(含幻觉的回复占比)。为惩罚假阳性(幻觉驱动的假阳性最伤精度),作者沿用 THRONE 的做法让精度权重是召回的 2 倍,得到 F^β(R) = (1+β²)·(1−CHAIR(R))·Cover(R) / (β²·(1−CHAIR(R)) + Cover(R)),其中 β=0.5。若映射后伪影列表为空(说明没按要求作答),或模型把伪造样本判成真实,则强制 CHAIR=1;所有指标按样本计算。 - 评测协议:全部零样本、不做任务特定微调;视频任务在可配置时取 16 帧,否则用模型默认抽帧策略;同一协议对所有模型与模态一致。模型侧视觉模态评了 InternVL2.5/InternVL3.5 系列、Qwen3-Omni / Qwen3-VL、LLaVA-OV、MiniCPM-V、MiMo-VL、Idefics2、Mantis、Phi-4,以及取证专用的 FakeShield、FakeVLM,商用基线为 GPT-5、Gemini 2.5-Pro、Claude Sonnet 4.5;音频模态评了 Qwen2-Audio、Qwen3-Omni、Phi、Audio-Flamingo-3、SALMONN-7B 与 Gemini 2.5-Pro,共 22 个模型。
5. 实验结果
- 基座模型(被评测的 MLLM,逐字照抄论文写法):视觉侧 InternVL2.5-8B / 26B / 38B、InternVL3.5-8B / 38B、Qwen3-Omni-30B-A3B-Instruct、Qwen3-VL-8B-Instruct、Qwen3-VL-30B-Instruct、LLaVA-OV-7B / 72B、MiniCPM-V-2.6、MiMo-VL-7B-SFT、Idefics2-8B、Mantis-8B、Phi-4-multimodal-instruct、FakeShield、FakeVLM;商用侧 GPT-5、Gemini 2.5-Pro、Claude Sonnet 4.5。音频侧 Qwen2-Audio、Qwen3-Omni、Phi、Audio-Flamingo-3、SALMONN-7B 与 Gemini 2.5-Pro。
- 数据集与基准:TriDF 本身(65K 个问题 = 23K
+ 24K + 18K ,约 5K 组真-伪对、16 种 DeepFake 技术、3 种模态、51 个生成器、30 多个公开数据集);对照比较的既有基准/数据集包括 DD-VQA、FakeBench、SynthScars、AIGI-Holmes(SID-Set)、AvatarShield(FakeHumanVid)、Forensics-Bench、LOKI、FaceForensics++、DFDC、ForgeryNet、LAV-DF、GenImage、GenVideo、MMTD-Set、FakeClue。 - 关键结果:
- 感知(Table 2,
平均准确率,随机基线 50.00%):GPT-5 最高,Image 63.36% / Video 57.02% / 总平均 60.19%(Rank 1);Qwen3-VL-30B-Instruct 以 61.04% / 58.65% / 59.85% 排第 2,是开源最好;Gemini 2.5-Pro 61.69% / 57.58% / 59.63%(Rank 3);LLaVA-OV-7B 只有 26.94% / 25.35% / 26.15%(Rank 18)。作者总结”Even the strongest systems only moderately outperform random choice in several settings, indicating substantial headroom for improvement.” 上排名倒转:Claude Sonnet 4.5 最好(总平均 0.21,Rank 1),Qwen3-VL-30B-Instruct 0.19(Rank 2),GPT-5 只有 0.06(Rank 6)——作者解读为”Claude Sonnet 4.5, for example, achieves the strongest performance on but exhibits a noticeable drop on , suggesting that it can effectively exploit the richer contextual cues and answer structure in multi-choice questions, yet struggles more when forced to make isolated binary judgments”。 栏的数值是非百分比的处理后得分(可能有负值,如 LLaVA-OV-7B 总平均 −0.10),论文主文未展开其归一化定义(详见附录)。 - 可解释检测与幻觉(Table 3):Type-A
上 GPT-5、Gemini 2.5-Pro、Claude Sonnet 4.5、LLaVA-OV-72B 的 Cover 较高(如 Claude Sonnet 4.5 Image Cover 0.6410,Gemini 2.5-Pro 0.5511,GPT-5 0.4387),Gemini 2.5-Pro 的 Image F0.5 最高(0.4618);但作者强调”CHAIR and Hal scores are generally high, indicating that hallucinations remain widespread in most model outputs”。Type-B 上 Gemini 2.5-Pro 的 Image 检测 Acc 最高(0.7311,Cover 0.4208,F0.5 0.4258),Qwen3-Omni-30B-A3B-Instruct 次之(Acc 0.6942)”Nonetheless, Qwen3-Omni-30B-A3B-Instruct exhibits pronounce hallucinations, as suggested by its CHAIR and Hal”;视频模态下多数模型 Acc 下降、Cover 大约减半,”further highlights the challenge of explaining video DeepFakes”。 - 三维修补关系(附录 Figure 10,22 个模型):r(P,D) ≈ 0.60,r(H,D) ≈ −0.60,r(P,H) ≈ −0.44。分层曲线(Figure 11)显示 Low-H 与 Mid-H 区间里伪造检测准确率随 Cover 上升并快速饱和,而 “In the High-H regime, DeepFake detection accuracy remains close to chance across all perception bins and is effectively insensitive to Cover”。
- RQ1 伪影难度(Figure 3 雷达图):blockiness、banding、reflection inconsistency 等 quality artifacts 已能被较高准确率检出,而需要物理或社会推理的 semantic artifacts(解剖不一致、异常动作、背景-主体不连贯等)”are consistently much harder, with substantially lower mean accuracies across models”,因此”semantic artifacts remain the main bottleneck for robust DeepFake perception”。
- RQ2 定位提示的收益/代价(Table 9):作者定义 Benefit 为”无提示答错、有提示答对”的比例,Cost 为”无提示答对、有提示答错”的比例。InternVL2.5-8B(Net Benefit 2.53%)与 Claude Sonnet 4.5(2.47%)效率最高;Gemini 2.5-Pro 与 Qwen3-VL-30B-Instruct 为负(−0.30% 与 −0.32%);InternVL3.5-8B 的 Benefit 10.87% 与 Cost 10.10% 几乎抵消。作者结论是”localization hints do not reliably improve models’ spatial focus”。
- 发现的模型行为异常:InternVL2.5-8B 呈现”low Cover (worse) and low CHAIR (better)”,实为只识别很少几类伪影、覆盖面窄;Claude Sonnet 4.5 则”high Cover (better) but relatively high CHAIR (worse)”,其平均回复长度约为其他模型的两倍,”indicating a stronger tendency toward hallucinated or over-elaborate explanations”。
- 感知(Table 2,
- 对比方法:作为基准论文,横向对比对象即上述 22 个 MLLM;其中专为 DeepFake 设计的推理型检测器 FakeShield 与 FakeVLM 也被纳入评测(FakeVLM 在
上仅 2.00% 总平均,作者标注其不支持视频/音频模态)。论文本身不提出新的检测方法。
6. 论文结论
- 作者自述贡献:①提出 TriDF,”a comprehensive benchmark designed to advance interpretable and reliable DeepFake detection”,整合 16 种操纵类型、3 种模态、人工对齐的细粒度伪影标注;②通过 Perception / Detection / Hallucination 三个互补组件,把评测从传统准确率扩展到”模型如何感知证据、如何决策、如何陈述推理”的整体考察;③实验揭示”accurate recognition of manipulation cues is essential for strong classification performance, yet unreliable or fabricated explanations can significantly undermine the final decision of a model”,并据此主张”the need for evaluation protocols that account for all three”。
- 局限与未来工作:论文未设独立的 Limitation/Future Work 章节。可提取的作者自述局限包括:作者批评同类基准”relies on carefully engineered prompts to leverage powerful MLLMs both for generating explanations and judging the outputs of other models … introducing self-preference bias”,因此 TriDF 改用外部 LLM(Gemini 2.5 Flash-Lite)做伪影映射,但作者也承认映射本身依赖外部 LLM(这属于我基于原文的推论,非原话);另据模型可支持性说明,FakeShield 与 FakeVLM 被标注为不支持部分模态(– indicates unsupported modality),因此它们在多模态维度上无法完整评测。论文正文收尾于 Conclusion,未给出明确的未来工作条目。
[49] CVPR2026 — WalkGPT: Grounded Vision-Language Conversation with Depth-Aware Segmentation for Pedestrian Navigation
- 会议:CVPR 2026(arXiv 录用说明:Accepted by CVPR-2026)
- arXiv:2603.10703 — https://arxiv.org/abs/2603.10703
- 本地 PDF:
CVPR2026-WalkGPT Grounded Vision-Language Conversation with Depth-Aware Segmentation for Pedestrian Navigation.pdf - 一句话定位:行人导航的像素级 grounded 对话;幻觉只属附带评测
1. 中文摘要
本文提出 WalkGPT,一个像素级 grounded 的 LVLM,并定义新任务 Grounded Navigation Guide:给定行人视角图像与导航提问,输出通行性文字判断、可通行/有害要素的分割掩码与各要素相对距离。模型用共享的 SAM ViT-H 编码器同时支撑对话与分割:MSQP(Multi-Scale Query Projector)在多尺度上池化视觉特征,经 segmentation-aware gate 后由可学习 query 做两层 cross-attention,拼接填充到固定长度 Q=36 后投影进 LLM;CTP(Calibrated Text Projector)把 <SEG> token 经 MLP+bias 扩展成 K_bank 组子嵌入以保留语义多样性,并用 Region Alignment Loss(InfoNCE)把 <SEG> 与 cross-attention 检索到的显著区域对齐。结构化 token <p>/<assessment>/<SEG>/<distance> 把定位、通行判断与深度表达统一进同一次下一 token 预测,深度无需专用深度头。作者另构建 PAVE:41k 基于 SANPO 真实行人视角图像生成的问答三元组。
2. 方法图
3. 研究动机
- 现有做法的缺陷:LVLM 能描述图像内容,但”lack of explicit grounding leads to object hallucinations and unreliable depth reasoning”(摘要原句),用来做无障碍引导会给出危险建议;已有空间推理路线(如 SpatialVLM、SpatialRGPT、DepthLM)”often rely on user-provided visual cues to estimate object depth, which is impractical for pedestrian navigation because users cannot manually supply such inputs”;而 grounded LVLM 虽然用文本—区域对齐降低幻觉,但其掩码”are 2D and lack the depth information required for spatial reasoning”,因此无法判断相对距离与空间层级。
- 本文的关键观察/假设:把”结构化语言 token”当作统一的接口——只要在回答里显式生成
<SEG>/<distance>等 token,就能让同一套 LLM 隐状态既驱动分割解码器又表达物体级距离,”allowing depth estimation to emerge through language prediction without dense depth supervision or dedicated depth heads”;同时深度监督(<distance>token)与显式 grounding 共同压低无据提及。 - 任务与数据缺口:行人级导航本身研究不足(多数自动化导航系统是给车设计的),且”the absence of large-scale pedestrian-view datasets with joint question–answering and grounding annotations”。
4. 研究方法
- 总体流程(Figure 2a):文本 token 与来自共享 SAM-based 像素编码器的 image token(由 MSQP 产出)拼接后送入 LLM(LoRA 微调);回答中出现的每个
<SEG>token 交给 SAM 像素解码器,得到与该语义实体空间对齐的掩码。四个结构化 token 分工:<assessment>给整体通行性判断,<p>在对话中锚定被引用的物体,<SEG>作为分割提示,<distance>以自然语言表示物体级深度。 - MSQP(Multi-Scale Query Projector):对编码器嵌入 Z∈R^{B×L×C} 先做线性投影(d_proj=1024)得 F,再 reshape 成网格并在多尺度上平均池化,得到 token banks {x¹, x², x⁴, x^g}(原生/池化2/池化4/全局均值)。每个尺度的特征先经 segmentation-aware gating g(·)”highlights structure- and edge-rich regions before attention”,再由各尺度少量可学习 query Q_s 通过两层 cross-attention 汇聚为 o_i^s=Σ_j α_ij x_j^s;各尺度输出拼接并 padding 到固定长度 Q=Σ_s Q_s+4=36,最后线性投影到 LLM 隐维 H 得到 V_proj∈R^{B×Q×H}。
- CTP(Calibrated Text Projector)与 Region Alignment Loss:把 LLM 中
<SEG>token 的隐状态 T∈R^{B×M×H} 线性降到 d_vis=256 得 U;为”prevent loss of token diversity”,每个 u_i 经 E_i=MLP(u_i)+B 扩展为 K_bank 个校准子嵌入(B 为可学习 bias,编码 objectness、边界结构等模态先验),再 reshape/拼接作为像素解码器的文本提示。由于 4096→256 会丢信息,作者用对比正则:以<SEG>token 为 query 对像素编码器嵌入做 cross-attention,取 top-K 高注意力图像 token 加权得正区域嵌入 z⁺,用 InfoNCE 拉近映射后的 token 与对应区域、推远其他图像/未注意区域(温度 τ;像素编码器冻结)。 - 训练策略:对话生成用 teacher forcing 的交叉熵 L_CE;分割用 Dice+CE,L_seg=L_Dice+L_CE^seg;总损失 L_total=α₁L_CE+α₂L_seg+α₃L_NCE。两阶段训练:预训练阶段只优化 MSQP(其余冻结,用 ADE20K 与 RefCOCO 系列),微调阶段在 PAVE 上联合训练 MSQP、CTP、像素解码器与 LoRA 参数;单张 H100 完成。
5. 实验结果
- 基座模型:语言模型用 [39]=PixelLM 的预训练权重初始化 13B 版本、用 [38]=GLAMM 的权重初始化 7B 版本(原文:initialized with pretrained checkpoints from [39] for the 13B version and [38] for the 7B version);视觉侧为单个共享 SAM ViT-H pixel encoder;LLM 用 LoRA 微调。生成 PAVE 问答的 LLM 为 GPT-5-nano。
- 数据集与基准:自建 PAVE(Pedestrian Accessibility and Visual-grounded Evaluation,41k 图像—问答三元组,源自 SANPO 的真实图像子集,91 个视频会话,每会话均匀采样 100 帧,85 会话≈8.5k 帧训练、6 会话≈600 帧评测);预训练用 ADE20K 与 RefCOCO 家族;泛化评测用 Referring Expression Segmentation(RefCOCO/RefCOCO+/RefCOCOg);指标含 CIDEr、METEOR、AP50、mIoU、Recall、Depth Accuracy([0.5×,2×] 内比例)与 AbsRel,以及幻觉指标 CHAIRi 与物体覆盖 Cover。
- 关键结果:
- 分割与深度:WalkGPT(13B) 在 PAVE 上 mIoU 20.16、Depth Acc. 48.95,对比 PixelLM-FT 的 18.10 / 39.00(原文:”the 13B model improves mIoU by more than 10% (20.16 vs. 18.10) and raises depth accuracy by over 25% (48.95 vs. 39.00)”)。
- 文本生成:WalkGPT(7B) CIDEr 41.97、METEOR 42.36,优于最强的 Sa2VA-FT(CIDEr 38.82);13B 版 METEOR 43.01 为全表最高。
- 幻觉对比(Table 4,PAVE 上):WalkGPT CHAIRi 18.49 / Cover 83.66,对比 LLaVA-1.5 的 22.16 / 33.04、LLaVA 1.6 Mistral 的 23.56 / 38.83、Qwen-VL-Chat 的 26.78 / 31.42。
- RES 泛化(Table 2,非本任务训练):refCOCO-val 76.2%、refCOCOg-val 72.6%,比 LISA、PixelLM 高约 3–4%。
- 消融(Table 5):MSQP→普通 MLP 使 METEOR 43.01→39.50、mIoU 20.16→17.40、Depth Acc. 48.95→43.39;去掉多尺度聚合 41.60/19.30/44.70;query 数降到 Q=8 进一步降到 38.10/16.20/45.33;CTP→线性映射 40.70/18.60/47.98;去掉 L_NCE 41.00/18.90/47.00;冻结 LLM 35.20/17.80/40.21;去掉
<distance>token 主要伤深度(48.95→38.77)而分割几乎不变(20.16→20.01)。 - 与纯视觉分割模型对比(Table 3,PAVE):U-Net 16.85 mIoU / 28.34 Recall、nnU-Net 18.55 / 28.41、Swin-UNETR 20.60 / 30.65,WalkGPT 20.16 / 32.71——说明该数据集的 grounded 分割本身极难(作者自述 dense pedestrian-view scenes、严重类别不平衡)。
- 对比方法:grounded LVLM 基线 GLAMM、LISA、PixelLM、GSVA、OMG-LLaVA、Sa2VA(零样本†与在 PAVE 上微调 -FT 两档);幻觉对比 LLaVA-1.5、LLaVA 1.6 Mistral、Qwen-VL-Chat;RES 对比 MCN、VLT、CRIS、LAVT、ReLA、LISA、PixelLM;分割对照 U-Net、nnU-Net、Swin-UNETR。
6. 论文结论
- 作者自述贡献:(1) 首个面向行人无障碍的 grounded 空间推理 LVLM(首次提出 Grounded Navigation Guide 任务);(2) 一套精简架构(MSQP + CTP + 结构化 token 监督)实现像素级 grounding;(3) 构建带深度标注的大规模 VQA 数据集 PAVE;(4) 在 grounded navigation guidance 上取得 SOTA,并为无障碍 AI 设基准。
- 局限与未来工作:原文 Limitations 仅一句半——“WalkGPT may still be affected by dataset artifacts that introduce ambiguity. Future work will explore improved depth estimation and evaluate cross-domain generalization on additional navigation and grounding datasets.”;正文另给出失败模式:路面强反光被误判为实体障碍(Figure 5)、磨砂玻璃/透明栅栏被误判为可通行(Figure 7),以及运动模糊、噪声表面与严重类别不平衡会把”真实结构”与”偶然视觉伪影”混同;作者的定性说明也承认 PAVE 上分割 mIoU 仅 20% 左右、单视图深度线索易被反射扭曲。
[50] ICML2026 — MoDA: Modulation Adapter for Fine-Grained Visual Grounding in Instructional MLLMs
标题说明:meta.json 的 arXiv 权威标题为 “MoDA: Modulation Adapter for Fine-Grained Visual Grounding in Instructional MLLMs”;本 PDF(v2,2026-06)标题页与页眉印作 “MoDA: Modulation Adapter for Fine-Grained Visual Understanding in Instructional MLLMs”,正文内容一致。
- 会议:ICML 2026(arXiv 录用说明:Accepted at ICML 2026. Code is available at https://github.com/waybarrios/MoDA)
- arXiv:2506.01850 — https://arxiv.org/abs/2506.01850
- 本地 PDF:
ICML2026-MoDA Modulation Adapter for Fine-Grained Visual Grounding in Instructional MLLMs.pdf - 一句话定位:指令引导的通道级调制适配器;幻觉只是三类评测之一
1. 中文摘要
本文针对 MLLM 细粒度视觉 grounding 的瓶颈——视觉 patch 表示的语义纠缠(一个 patch 内混入多个不同语义元素,使其无法按指令聚焦细节)——提出 MoDA(Modulation Adapter)。MoDA 是一个轻量模块,接在已对齐的 adapter 输出与 LLM 之间,做指令引导的通道级调制:以语言指令 token 为 memory、已对齐视觉特征为 target 做 cross-attention,经线性投影与 sigmoid 得到取值 [0,1] 的软调制掩码,再以 Hadamard 积逐通道加权视觉嵌入(Ṽ = V ⊙ σ(W·F(T,V)))。与 Q-Former/InstructBLIP 的 token 级加性特征选择不同,MoDA 在 token 内部嵌入维度上做乘性调制,可抑制无关通道且保留空间结构,无需改动架构、无需额外监督或训练数据。作者在 12 个基准(VQA、vision-centric 推理、幻觉检测,含 MMVP、CV-Bench、MMStar、RealWorldQA)上把 MoDA 接入三种 MLLM:LLaVA-1.5、LLaVA-MoRE、Qwen3-VL,均获一致增益,开销仅 3.7% 参数、<1% FLOPs。
2. 方法图
3. 研究动机
- 现有做法的缺陷:SOTA MLLM 在需要精确定位与细节推理的查询上频繁失败,”This limitation manifests as hallucinations, where model outputs contradict actual image semantics”;根因被指向 CLIP 视觉编码器的 patch 表示——“its patch-based representations often fail to capture localized details due to semantic entanglement within individual patches”。补救路线(多编码器、微调 CLIP 保留局部结构)”often introduce substantial computational overhead or require large-scale retraining”;而 NLP 迁移来的 attention masking 只做 token 级稀疏而非通道级精炼,layer-wise adaptive masking(LAM)在深层模型上开销大,”Most critically, these approaches lack instruction-guided conditioning”。
- 本文的关键观察/假设:作者用一个 3×3 网格覆盖睡着的法国斗牛犬与毛绒玩具来演示纠缠——“Patch 5 blends the dog’s torso, stuffed toy, and cushioned bed; patch 6 mixes the dog’s head, ear, and hardwood floor”,于是同一 patch 的多个特征维度编码互不相关的含义;据此假设:只要用指令动态地逐通道重加权已对齐特征,就能把指令相关维度推高、把纠缠噪声压低,且这种收益会随编码器表征质量提升而放大(CLIP 上增益温和,SigLIP-S2 上显著,原文称 “+5.1 points over CLIP”)。
- 定位假设:MoDA 只在 adapter→LLM 接口处做一次调制(single-pass),避免逐层掩码随深度线性增长的开销,且与编码器端/解码器端的其它精炼方法互补。
4. 研究方法
- 总体流程:沿用 LLaVA 的两阶段协议(视觉编码器 + adapter + 预训练 LLM),MoDA 作为新组件插在 adapter 之后、LLM 之前;视觉编码器抽 patch 特征 → adapter 投影到语言嵌入空间 → MoDA 估计通道级调制权重 → 调制后的视觉嵌入作为 prefix token 交给 LLM,自回归生成回答。
- MoDA 设计(核心公式):设已对齐视觉特征 V_aligned∈R^{B×N×E},语言 token 嵌入 T∈R^{B×M×E}(取自 LLM 初始层)。先按 Ṽ = V ⊙ F(T, V) 定义调制算子(⊙ 为沿嵌入维的 Hadamard 积),再具体化为 Ṽ = V ⊙ σ(W·F(T,V)):F(·) 由一叠 Transformer 层实现(视觉特征作 target 序列、语言 token 嵌入作 memory),W∈R^{E×E} 为可学习线性投影,σ 为逐元素 sigmoid 把掩码约束在 [0,1],该掩码可解释为”a channel-wise mask that independently re-weights each feature channel”。每个 cross-attention Transformer 层含多头 cross-attention、FFN、残差与 LayerNorm。
- 与 Q-Former 的三点区别(原文自述):(1) 粒度——在 token 内部嵌入维上操作而非选择/重加权整个 token;(2) 操作——乘性 Hadamard 调制可选择性抑制无关维度,而非加性残差;(3) 位置——作用于已对齐之后的特征,是补充而非替代现有 adapter。
- 训练/推理策略:第一阶段只训原 adapter(编码器与 LLM 冻结,自回归语言建模目标);第二阶段引入 MoDA(Xavier 初始化),联合微调 MoDA 与 LLM,adapter 保留第一阶段权重;两阶段目标一致,均为自回归交叉熵 L_CE = −Σ_t log P(y_t | y _ {<t}, Ṽ_aligned, T)。无需额外监督或数据;多轮场景下视觉特征只缓存一次,后续查询仅需重算调制(<1% 计算)。
5. 实验结果
- 基座模型:LLaVA-1.5(LLM 为 Vicuna-7B;消融中还用到 Vicuna-13B 的官方基线)、LLaVA-MoRE(LLM 为 LLaMA 3.1-8B,视觉编码器分别为 OpenAI CLIP 与 SigLIP-S2)、Qwen3-VL-2B-Instruct(Qwen3-2B,其原生 ViT 不属于 CLIP 家族);消融中视觉编码器为 CLIP ViT-L/14@336 与 SigLIP-S2。
- 数据集与基准:12 个基准三类——VQA:GQA、ScienceQA、MMBench、RealWorldQA、ChartQA;vision-centric:LLaVA-Wild、MM-Vet、MMStar、V*Bench、CV-Bench;幻觉检测:POPE、MMVP(MMVP 用 Gemma 3 作为 grader)。训练数据与超参沿用 LLaVA-1.5 两阶段协议。
- 关键结果:
- 幻觉检测:Vicuna-7B 上 MMVP 24.0 → 36.0(+12.0);SigLIP-S2 上 LLaVA-MoRE + MoDA 取得 POPE 87.7、MMVP 42.7(基线 86.0 / 39.3),并超过 13B LLaVA-1.5 的 85.9 / 24.7。
- VQA:LLaVA-MoRE SigLIP-S2 上 ScienceQA 77.1 → 81.9(+4.8),GQA 64.9 → 65.4、MMBench 71.8 → 72.4、RealWorldQA 57.2 → 58.2、ChartQA 17.3 → 18.1(五个 VQA 基准全为 LLaVA-MoRE 家族最佳)。
- 非 CLIP 编码器泛化:Qwen3-VL-2B-Instruct 上 GQA 59.4 → 63.2(+3.8)、ScienceQA 79.3 → 84.2(+4.9)、RealWorldQA 64.7 → 68.8(+4.1)、MMBench 86.5 → 87.4、POPE 89.4 → 89.9;但 ChartQA 80.0 → 79.0、V*Bench 77.0 → 74.9 轻微回退(作者归因于该编码器已高度专门化、通道精炼空间小)。
- Vision-centric:LLaVA-MoRE OpenAI CLIP + MoDA 的 LLaVA-Wild 73.9;SigLIP-S2 + MoDA 的 MMStar 38.5、V*Bench 44.8、CV-Bench 62.2,均超过 ShareGPT-4V(72.6 / 33.0 / 61.8)等 13B 级基线。
- 消融(SigLIP-S2,Table 4):Cross-Attention 平均 69.4 > Self-Attention 68.0 > Linear MLP 67.3;加 L1 辅助监督反而损害 Cross-Attention(68.1);backbone 换成 LLaMA 3.1-8B 有小幅提升;SigLIP-S2 比 CLIP 放大 MoDA 效果(+5.1)。
- 与掩码方法对比(Table 5,LLaMA 3.1-8B + SigLIP-S2):MoDA 平均 69.4 > Learnable Mask 68.5 > Sparse Mask 66.5,且 MMVP 42.7、ScienceQA 81.9 为最强。
- 开销(Table 6):MoDA 0.302B 参数(LLaVA-MoRE 8.0B 的 3.7%),MACs 45.1G vs ≈5246G、FLOPs 90.2G vs ≈10492G(均 0.86%)。
- 对比方法:BLIP-2、InstructBLIP、Qwen-VL-Chat、LLaVA、LLaVA-1.5(7B/13B)、ShareGPT-4V,以及 LLaVA-MoRE 与 Qwen3-VL-2B-Instruct 各自的无 MoDA 基线;掩码类对比方法为 Learnable Mask(Barrios & Jin, 2024,即 LAM)与 Sparse Mask(SwinBERT);消融的替代结构为 Linear MLP、Self-Attention。
6. 论文结论
- 作者自述贡献:(1) 识别视觉 patch 表示中的语义纠缠,并提出 MoDA 这一指令引导的通道级调制方案;(2) 以极小开销(<1% FLOPs)在多样基准上取得一致增益;(3) 通过系统消融证明增益来自架构创新而非容量增加。
- 局限与未来工作:原文 Limitations 指出——MoDA 只能软性重加权通道,”cannot achieve explicit sparsity in the channel dimension”,很少把某通道权重压到 0;其收益取决于编码器是否”underutilize task-relevant channels”,在 Qwen3-VL 上 ChartQA 与 V*Bench 出现小回退(编码器已专门化,通道精炼空间有限);评测仅覆盖单图基准,”extending MoDA to multi-image and video understanding remains future work”。未来工作还包括引入稀疏化目标以获得更强、更可解释的特征选择,以及在更广编码器范围内刻画上述关系。
[51] ICML2026 — Scaling-Aware Adapter for Structure-Grounded LLM Reasoning
- 会议:ICML 2026(arXiv 录用说明:Accepted by ICML 2026)
- arXiv:2602.02780 — https://arxiv.org/abs/2602.02780
- 本地 PDF:
ICML2026-Scaling-Aware Adapter for Structure-Grounded LLM Reasoning.pdf - 一句话定位:全原子结构 LLM 连接器,显式攻”结构幻觉”;非视觉模态
1. 中文摘要
本文关注 LLM 对 2D/3D 结构(分子、蛋白、核酸)的推理:现有方法要么是模态专用的,要么把结构输入压成序列 token 或固定长度 query 连接器。作者认为这两条路各有致命缺陷——前者缺少”减轻结构幻觉所必需的几何 grounding”,后者形成不灵活的模态融合瓶颈,同时过度压缩结构 token 且分配失当,阻碍通用 all-atom 推理。为此提出 Cuttlefish,一个统一的多模态 LLM。其一是 Scaling-Aware Patching:用 instruction-conditioned gating 在结构图上产出变尺寸 patch,按累积概率质量阈值自适应决定 anchor 数量,使 query token 预算随结构复杂度增长,缓解定长连接器瓶颈;其二是 Geometry Grounding Adapter:让这些自适应 token 通过 cross-attention 从完整模态嵌入中检索细粒度几何,并把它们注入 LLM 的 embedding 位置,把显式几何线索暴露给语言模型以抑制结构幻觉。作者同时构建 GEO-AT——首个含原子坐标与语言标注的 all-atom 指令数据集,并在跨学科 all-atom 基准上报告了优越性能。
2. 方法图
3. 研究动机
- 现有做法的缺陷一(预算僵化):all-atom 图尺寸跨度极大,而 Q-Former 式定长 query 连接器(Mol-Llama)在较大的长度分箱上”yield lower performance across all metrics for molecules in larger length bins, due to over-compressed geometric features”;反过来一味加大预算又会”over-allocates capacity to small entities, diluting attention”。相关工作还指出 InstructMol、GIT-Mol、3D-MoLM、UniMoT、Chem3DLLM 等把变尺寸结构压成常数 token 预算,”degrades scalability with entity size and atom-level detail”,Graph2Token 这类离散化桥接仍有高复杂度下的信息损失。
- 现有做法的缺陷二(结构幻觉):SMILES、蛋白/DNA 残基序列等仅序列输入”do not encode geometry or long-range spatial relations”,缺少可验证结构证据的 LLM 会给出不被上下文蕴含的几何理由(structural hallucination)。作者用 Table 1 的功能团幻觉测试量化:Mol-Llama 的序列版 (S) HR 0.28/HPM 0.91 vs 完整版 0.12/0.59;ProtChatGPT(S) 0.34/0.99 vs 完整版 0.10/0.55;3D-MoLM(S) 0.59/2.23 vs 3D-MoLM 0.23/1.15。
- 本文的关键观察/假设:(1) 结构 token 预算应当与结构复杂度成正比,且应由指令决定”哪里值得分配”——指令相关的 anchor 应能”grow”到更大的感受野;(2) 把几何证据以显式 token 注入 LLM 的嵌入位置,能把输出显式条件化于几何,从而压低结构幻觉;(3) 结构查询由 patching 动态实例化并携带明确几何含义,因此不需要 Q-Former 式重对比预训练,指令监督的端到端微调即可完成对齐。
4. 研究方法
- 总体流程(Sec. 3.1 / Figure 2):原子坐标与特征先经 SE(3)-等变 EGNN 编码为原子级模态嵌入;(2) instruction-conditioned scoring gate 依累积质量阈值挑选关键 anchor 原子;(3) soft patch-growing 依空间邻近度与 gate logits 决定原子归属,并做 in-patch weighted pooling 生成结构 query token;(4) query 通过 cross-attention 检索几何细节得到 modality token,最终注入 LLM embedding 的指定位置。
- Scaling-Aware Patching(Sec. 3.2 / Algorithm 1):由指令嵌入 z、图批分配 b、等变节点嵌入 X 算 anchor logits ℓ=G_anc(z,X,b);对每张图按 Softmax(ℓ) 排序,取最小的 k 使累积质量超阈值 ρ,得自适应 anchor 数 k_g=min{k∈{1..N_g}: Σ _ {j≤k} prob _ {π_j} ≥ ρ};soft patch growth 用 W _ {i,a}=exp(−‖P_i−P_a‖²+ℓ_a)/Σ _ {a’}exp(−‖P_i−P _ {a’}‖²+ℓ _ {a’}) 把”指令相关性高的 anchor 扩张到更大感受野”与几何局部性结合;最后 in-patch weighted pooling 得 patch token t_a=Σ_i (W _ {i,a}/Σ_j W _ {j,a}) X_i。
- Geometry Grounding Adapter(Sec. 3.3 / Algorithm 2):patch token 归一化后投影为 query Q,模态嵌入投影为 K,V;经 L_f 个 fusion block(Self-Attn → Cross-Attn(Q,K,V) → FFN)检索 patching 阶段被抽象掉的完整几何细节(”while the anchor gate identifies instruction-relevant substructure positions, the fusion blocks recover full geometric detail at and around those positions rather than performing a second selection”);输出投影到 LLM 维度后,按指令中的 modality placeholder token 位置插入,并同步更新 attention/label mask。
- 训练(Sec. 3.4):三阶段。(1) 编码器预训练——SE(3)-等变 EGNN 做 masked reconstruction,预测元素类型、成对距离与注入方向噪声,L_enc=L_type+λ_d L_dist+λ_u L_dir;(2) Modality Alignment Tuning——冻结 EGNN 与 LLM,只训连接器(Scaling-Aware Patching + Geometry Grounding Adapter),数据为自建 GEO-AT;(3) LLM Adaptation Tuning——解冻 LLM,用更小学习率端到端微调。
5. 实验结果
- 基座模型:默认 backbone 为 Llama-3.1-8B-Instruct(原文:”Llama-3 (Grattafiori et al., 2024) and Qwen-3 (Yang et al., 2025a) exhibit relatively strong bio-modality understanding, motivating the adoption of Llama-3.1 as the default backbone”);Table 2 另用 Qwen2.5-7B、Llama-3.1-8B-I、Mistral-3-8B-I、GLM-4-9B、Qwen3-8B、DeepSeek-R1-D-Qwen-7B(表中作 R1-7B)、Mistral-3-8B-Reasoning;backbone size 消融用 Qwen-2.5 家族 0.5B/1.5B/3B/7B/14B/32B。结构侧用 SE(3)-等变 EGNN 编码器。
- 数据集与基准:自建 GEO-AT(首个 all-atom 指令数据集:分子 10K 化学—文本描述对来自 Mol-Llama-Instruct;蛋白 10K 高置信 UniProt 条目 + 已验证 PDB 结构;核酸 10K 来自 ChatNT(5K DNA + 5K RNA);每模态留 200 条测试样本);标准基准 Mol-Instructions(17 个任务;molecule 148.4K / protein 505K / biomolecular text 53K 条指令)、DNA-Chat(把 Nucleotide Transformer 的 18 个分类任务转成指令,7.8M 样本)、RNA-QA(407,616 条 RNA 派生 QA,含 AIS 与 D&C 两类);缺失结构用 AlphaFold2 生成。指标:METEOR/BERTScore/ROUGE/BLEU、生成任务有效性 validity 与 RDKit 指纹相似度 FTS、闭式 QA 准确率、DNA 用 MCC、幻觉用 HR(hallucination rate)/AR(answer rate)。
- 关键结果:
- 对比通用 LLM(Table 2,GEO-AT 四模态平均):Cuttlefish + Llama-3.1-8B-I 得 METEOR 0.428 / BERTScore 0.864,最强的通用基线 Mistral-3-8B-Reasoning(序列 + 模态增强 tokenizer)仅 0.176 / 0.744;Cuttlefish + Qwen3-8B 为 0.428 / 0.876。
- 小分子(Table 3,Mol-Instructions):分子描述 ROUGE-L 0.766 / METEOR 0.715(Mol-LLama-3.1 为 0.759 / 0.707);生成任务 FTS 全面提升(Forward 0.792 vs 0.774、Retro 0.747 vs 0.708、Reagent 0.509 vs 0.411)。
- 蛋白(Table 4):Interaction Extraction F1 0.273(Mol-Instructions 0.224、ProtLLM 0.176);PF/FD/CA/DM 的 ROUGE-L 0.486/0.520/0.551/0.495 均为最优或次优。
- 核酸:DNA-Chat 18 任务平均 MCC “Cuttlefish achieves top-1 average performance, slightly exceeding ChatNT”;RNA-QA D&C 上 ROUGE-1 0.519 / ROUGE-2 0.432 / ROUGE-L 0.471(RNA-GPT 0.479/0.269/0.441)。
- 结构幻觉(Table 10,GEO-AT 三种失败模式平均):分子 Cuttlefish HR 0.12 / AR 0.99,优于 Mol-LLaMA 0.18/0.97 与 3D-MoLM 0.42/0.86;蛋白 Cuttlefish HR 0.13 / AR 0.98,优于 ProtChatGPT 0.18/0.97 与 Prot2Chat 0.37/0.86;优势在 long-range interaction 模式最明显(分子 0.16 vs 0.19/0.32)。
- 消融(Table 6,生成质量平均):去掉 soft patch growth 最伤(METEOR 0.141,相对下降 66.83%);换成 Q-Former 连接器下降 43.15%(METEOR)/11.31%(BERTScore);去掉指令引导 gating 下降 14.01%/9.89%;residue-level 化学意义分块下降约 10%(10.49%/10.53%);Direct Projection 下降 20.96%/12.38%;单模态编码器仅下降 2.17%/2.69%(说明架构在单模态下仍有效)。
- 同预算对比(Table 7,matched-budget):Cuttlefish 匹配到 2048 token 时平均 BERTScore 0.862,Q-Former 定长 2048 为 0.760;Q-Former 在 1024 时最好(0.768)后于 2048 反降,说明”增益主要来自自适应性而非单纯多用 token”。
- 其它分析:缺结构推理(Table 8)Full 0.864 vs w/o Structure at inference 0.811 vs 纯序列 0.745;backbone 0.5B→32B 单调提升(平均 0.419→0.873);坐标高斯噪声下性能平缓退化(平均 0.513→0.423,噪声 0→2 Å)。
- 对比方法:通用 LLM——Alpaca-7B、Baize-7B、ChatGLM-6B、Llama-3-8B、Vicuna-v1.5-13B、Galactica-6.7B、Qwen-2.5-7B、Qwen3-8B、Mistral-3-8B、GLM-4-9B、DeepSeek-R1-D-Qwen-7B、Mistral-3-8B-Reasoning;分子/生物模态专用——MolT5、Mol-Instructions(Llama-2/Llama-3.1)、Mol-LLama-2/3.1、3D-MoLM、ProtLLM、ProteinGPT、ProtChatGPT、Prot2Chat、Chem3DLLM;核酸——ChatNT、RNA-GPT、RNA-FM、Enformer、DNABERT-1、NT/NTv2 系列(50M–2.5B)。
6. 论文结论
- 作者自述贡献:(1) 提出 Scaling-Aware Patching——指令条件下的 anchor patch growing 机制,使模态 token 数随结构复杂度缩放,缓解定长连接器瓶颈;(2) 提出 Geometry Grounding Adapter——通过 modality token 把可验证几何线索注入 LLM,减少结构幻觉;(3) 给出 Cuttlefish,一个在 all-atom 模态上推理的统一结构感知 LLM,并在 all-atom 理解基准上取得强性能。结论另总结四条观察:纯序列输入不足;定长连接器对几何依赖语义构成信息瓶颈;结构感知 LLM 经适当对齐可以内化原子级结构特征;联合模态训练提升各模态学习。
- 局限与未来工作:Limitations(并见 Appendix F/Table 40)称”Despite improved structural faithfulness, Cuttlefish remains limited by extremely large entities, upstream structure quality, and weak reasoning supervision”——即超大实体的理解、上游结构预测质量、以及推理监督薄弱三项。未来方向:以层次化切分、检索与多轮迭代摘要处理极端尺度结构;用不确定性感知 token 与多构象/集成训练提升对上游结构噪声的鲁棒性;构建带证据链 rationale 的 all-atom 推理语料以提供领域 grounding 的推理监督;以及折叠感知的多尺度核酸建模与事后验证(结构一致性检查、工具辅助校验、不确定性校准)以进一步减少开放式生成中的残余幻觉。
[52] ICML2026 — The Truth Stays in the Family: Enhancing Contextual Grounding via Inherited Truthful Heads in Model Lineages
标题说明:meta.json 的 arXiv 权威标题为 “The Truth Stays in the Family: Enhancing Contextual Grounding via Inherited Truthful Heads in Model Lineages”;本 PDF 标题页印作 “The Truth Stays in the Family: Enhancing Contextual Truthfulness via Inherited Heads in Model Lineages”,页眉与 meta 一致。
会议:ICML 2026(arXiv 录用说明:Accepted at ICML 2026)
arXiv:2606.15821 — https://arxiv.org/abs/2606.15821
本地 PDF:
ICML2026-The Truth Stays in the Family Enhancing Contextual Truthfulness via Inherited Heads in Model Lineages.pdf标题差异提示:arXiv 权威标题为 “…Enhancing Contextual Grounding via Inherited Truthful Heads…”,而本库下载的 PDF 标题页印作 “…Enhancing Contextual Truthfulness via Inherited Heads…”(页眉与 arXiv 一致)。二者为同一篇论文的版本措辞差异,本节标题沿用 arXiv 权威标题。
一句话定位:真值头在模型家族内继承,软门控压制幻觉
1. 中文摘要
本文研究一个此前未被检验的问题:下游 MLLM 与其基础 LLM 之间是否存在根本性的行为联系。作者用线性探针在每个注意力头上量化”语境真值性”:把输入组织为 {context, question, answer},探针在最后一个答案 token 的激活上训练二分类器区分忠实/幻觉答案,其验证准确率即该头的 Truth Score。在 Vicuna、Qwen2.5、LLaMA2、Mistral 等多个模型家族上,作者发现 Truth Score 在家族内被强保留(指令微调或多模态适配之后依然如此),且跨数据集探测时家族内相关性仍显著高于无关家族;这与注意力头参数权重保留一致(家族内权重漂移的 Frobenius 范数极小),而高真值头确实关注与查询相关的证据。基于此提出 TruthProbe:用归一化 Truth Score 构成软门 g_l^h = 1 + λ·norm(S),在残差连接前逐头缩放注意力输出并拼接回残差流(x _ {l+1} = x_l + Concat_h(g_l^h·o_l^h))。该门控在 HaluEval 上提升语境真值性,在 POPE 与 CHAIR 上降低多模态幻觉,且基础 LLM 的 Truth Score 可有效迁移给同家族微调 LLM 与 MLLM 后代。
2. 方法图
3. 研究动机
- 现有做法的缺陷:幻觉已成为 LLM/MLLM 落地的关键瓶颈,但既有缓解策略”often treat models as isolated instances, overlooking the persistent functional roles that specific attention heads may maintain when a base LLM is adapted into downstream variants”——即每个下游模型都要单独探测与干预,忽视了模型家族层面的可迁移结构;此外常见的硬掩码(hard masking)会直接丢弃不可信头的信息。
- 本文的关键观察/假设:假设”specific attention heads are specialized in encoding context-faithful information and that this ‘truthfulness trait’ is preserved within model lineages”。为验证,作者用线性探针量化 head 级语境真值性,并给出三条证据:(1) 同家族内 Truth Score 高度相关(单数据集探测约 0.77–0.98;跨数据集探测 Vicuna 家族 0.51–0.64,而无关的 Mistral-7B 仅 0.04–0.08,”near-zero correlation”);(2) 机制上源自权重保留——家族内平均 Frobenius 漂移 ≈0.03,跨家族 ≈1.01,且高真值头”predominantly located in middle to deeper layers (e.g., 80.0% of Top-20 truthful heads in LLaVA-1.5 are located in layers 10-31)”,而漂移集中在浅层;(3) 行为上,真值头呈现查询相关、语义有选择的注意力,非真值头呈位置相关的对角/条纹模式且随查询几乎不变。
- 指标/方法层面的动机:Truth Score 提供了可复用的家族级诊断信号,因此可以”leverage the Truth Scores from a single base LLM to enhance the truthfulness of multiple specialized MLLMs derived from the same foundation”,而无需逐个下游模型重新探测。
4. 研究方法
- Truth Score(head 级语境真值性度量):输入结构化 x = {x_context, x_question, x_answer},x_context 可以是世界知识文本或真实图像,x_answer 可以是忠实或幻觉答案;在最后一个答案 token 的激活上(自回归模型该位置累积了前文全部特征)为每个头训练一个二分类线性探针,判断该头是否可靠地纳入给定语境;探针的验证准确率即该头的 Truth Score。全流程用 5 折交叉验证保证稳健性(协议见附录 A)。
- TruthProbe(软头门控):在第 l 层,注意力输出 o_l 被 reshape 成 head-wise 分量 o_l^h ∈ R^{n_h×d_h},每个分量乘以对应门值 g_l^h ∈ R^{n_h},再拼接加回残差流:x _ {l+1} = x_l + Concat _ {h=1}^{H}(g_l^h · o_l^h),其中 g_l^h = 1 + λ·norm(S),S 为归一化后的 Truth Score,λ 为缩放参数。因此”when the norm-based score S is larger, the corresponding head output is amplified beyond the baseline level, whereas smaller values reduce its relative impact”。与硬掩码不同,所有头都保持激活,只是影响被自适应调制,从而保住多头表达的多样性并让残差流偏向可信信号。
- 探测数据配置:LLM 的 Truth Score 用 HaluEval 的一个子集(292 样本);MLLM 的 Truth Score 用 RLHF-V 的问答划分(2,726 样本)——作者说明 MLLM 的视觉处理会产生远多于此的 token,需要更多样本才能得到稳定 Truth Score。所有 Truth Score 均用 5 折交叉验证。
- 推理与实现细节:全部输出用 greedy decoding;软门控用缩放参数 λ 加归一化方式控制 Truth Score 的影响——HaluEval 与 CHAIR 用 centered normalization,POPE 用 min-max normalization,同一 POPE 数据源间 λ 取值一致以保证可复现(超参见附录 C)。
- 迁移范式:TruthProbe_LLM 使用各模型基础 LLM(LLaVA-1.5/LLaVA-NeXT 用 Vicuna-7B;Qwen2.5-VL-Instruct/Omni 用 Qwen2.5)的 Truth Score;TruthProbe_MLLM 直接用对应 MLLM 自身的 Truth Score,两者对比即为可迁移性证据。
5. 实验结果
- 基座模型:Vicuna-7B(→ LLaVA-1.5、LLaVA-NeXT)、Qwen2.5-7B(→ Qwen2.5-VL-Instruct、Qwen2.5-VL-Omni)、LLaMA2-7B(→ Vicuna-7B)、Qwen2.5-7B-Instruct;跨家族对照 Mistral-7B;附录另含 Mistral-7B-Instruct-v0.2(→ LLaVA-Med,医学域)、Qwen3-8B(→ Qwen3-VL-8B-Instruct)、InternLM3-8B-Instruct(→ InternVL3-9B)。
- 数据集与基准:HaluEval(问答划分;292 样本做线性探针,其余 9,708 样本评测,用三个随机种子构造评测集并报均值)、POPE(数据源 MSCOCO 与 A-OKVQA,每个源报 random/popular/adversarial 三个划分的均值)、CHAIR(从 COCO 2014 验证集随机采样 500 张图,报 CHAIRi 与 CHAIRs)、TruthfulQA(生成任务,GPT-5.1 打分)、GQA;探针与可视化数据还含 RLHF-V、PhD;医学泛化用 OmniMedVQA 的 SARS-CoV2-CT-scan 子集。
- 关键结果:
- HaluEval(LLM 自探测自应用):Vicuna-7B F1 13.37 → 29.15(Acc 38.89 → 38.53);Qwen2.5 Acc 27.65 → 35.04、F1 36.69 → 46.54、Rec 41.96 → 56.59。
- HaluEval(跨代迁移,Table 4):Vicuna-7B 用 LLaMA2-7B 的 Truth Score,Acc 38.89 → 48.47、F1 13.37 → 57.17、Rec 9.44 → 68.82;Qwen2.5-7B-Instruct Acc 34.90 → 37.35。作者指出这”even surpassing the results obtained by applying Truth Scores derived from the finetuned Vicuna-7B itself”。
- POPE(Table 2):增益主要落在 Recall——LLaVA-1.5 POPE(A-OKVQA) Rec 87.8 → 90.1;LLaVA-NeXT POPE(COCO) Acc 87.7 → 88.3、Rec 78.8 → 80.9;Qwen2.5-VL-Omni POPE(COCO) Acc 85.1 → 87.3、F1 84.7 → 86.0。
- CHAIR(Table 3,越低越好):LLaVA-1.5 CHAIRi 6.99 → 5.36、CHAIRs 23.00 → 17.40;LLaVA-NeXT CHAIRi 6.91 → 4.94、CHAIRs 13.40 → 11.20;Qwen2.5-VL-Instruct CHAIRs 13.20 → 7.80(用自身 Truth Score)。
- 继承性证据:家族内单数据集相关 0.77–0.98;跨数据集 Vicuna↔LLaVA 0.51–0.64 vs Mistral-7B 0.04–0.08;家族内权重漂移 Frobenius ≈0.03 vs 跨家族 ≈1.01;LLaVA-1.5 中 Top-20 真值头 80.0% 位于第 10–31 层。
- 与 ITI 对比(TruthfulQA 生成,GPT-5.1 评测):LLaMA2-7B-Chat 基线 56.40% 真值性/25.56% 信息量;+ITI 57.64/27.84;+TruthProbe_base LLM 56.91/27.00;+TruthProbe_FT LLM 55.38/29.02——作者称两者”provide comparable truthfulness and higher informativeness (especially +3.46 in TruthProbeFT LLM)”。
- 低资源域泛化(附录 L):把 Mistral-7B-Instruct-v0.2 的 Truth Score 迁移到医学 MLLM LLaVA-Med,OmniMedVQA SARS-CoV2-CT-scan 准确率 48.8 → 55.0(探针只用 292 条通用域样本训练)。
- 对比方法:各模型自身 vanilla 基线;ITI(Li et al., 2023c,附录 I 在 TruthfulQA 上对比);随机头门控 Random Head Gating(附录 Table 10/11 在 POPE 的 MSCOCO 与 A-OKVQA 上对比);TruthProbe_MLLM vs TruthProbe_LLM 作为迁移性对照;附录 F 给出注意力头门控的消融。
6. 论文结论
- 作者自述贡献:(1) 识别语境真值头——用 Truth Score 量化每个注意力头在多程度上把回答锚定在语境中;(2) 发现语境真值头的继承性——单/跨数据集分析显示家族内 Truth Score 强相关,且与参数级权重保留一致,并通过注意力叠加分析验证真值头关注查询相关证据;(3) 提出 TruthProbe 软门控,证明基础 LLM 的 Truth Score 可迁移到同家族微调 LLM 与 MLLM,并在 HaluEval、POPE、CHAIR 上取得增益。
- 局限与未来工作:论文未设独立的 Limitations 章节;Impact Statement 中作者明确承认”Nevertheless, TruthProbe does not fully eliminate hallucinations. We therefore caution against deploying such models in high-stakes settings without human oversight”,并建议把可靠性视为需在模型演化史中持续保留的属性;附录 L 把”在更广泛专业领域上做更充分的评测”留作未来工作;附录 M/N 则把评测扩展到 Qwen3/InternLM3 家族与 GQA、TruthfulQA 等更多基准。