20260907
(ICLR 2026)
motivation
数据滥用问题:收集海量网络数据(如人脸、艺术品、文本)来训练深度模型已成为常态,但这引发了严重的未经授权使用个人数据的隐私问题。
不可学习样本(Unlearnable Examples):为了缓解这一问题,研究者们提出向数据中添加人类肉眼难以察觉的微小扰动。当深度神经网络(DNNs)使用这些被扰动的数据进行训练时,模型在未见过的干净数据上将无法泛化,表现得就像随机猜测一样,从而使数据变得“不可学习”。
现有方法的痛点:现有的主流方法(如 EM、REM、TAP 等)通常依赖复杂的深度神经网络作为“代理模型”来生成这些扰动,计算成本极其高昂。例如,REM 方法在 CIFAR-10 数据集上生成扰动需要耗费超过 15 个 GPU 小时。
方法
作者提出了PERTURBATION-INDUCED LINEARIZATION=PIL。仅仅使用一个简单的无偏置线性模型作为代理模型来生成扰动。这使得其计算效率极高,在 CIFAR-10 数据集上生成扰动只需不到 1 个 GPU 分钟。
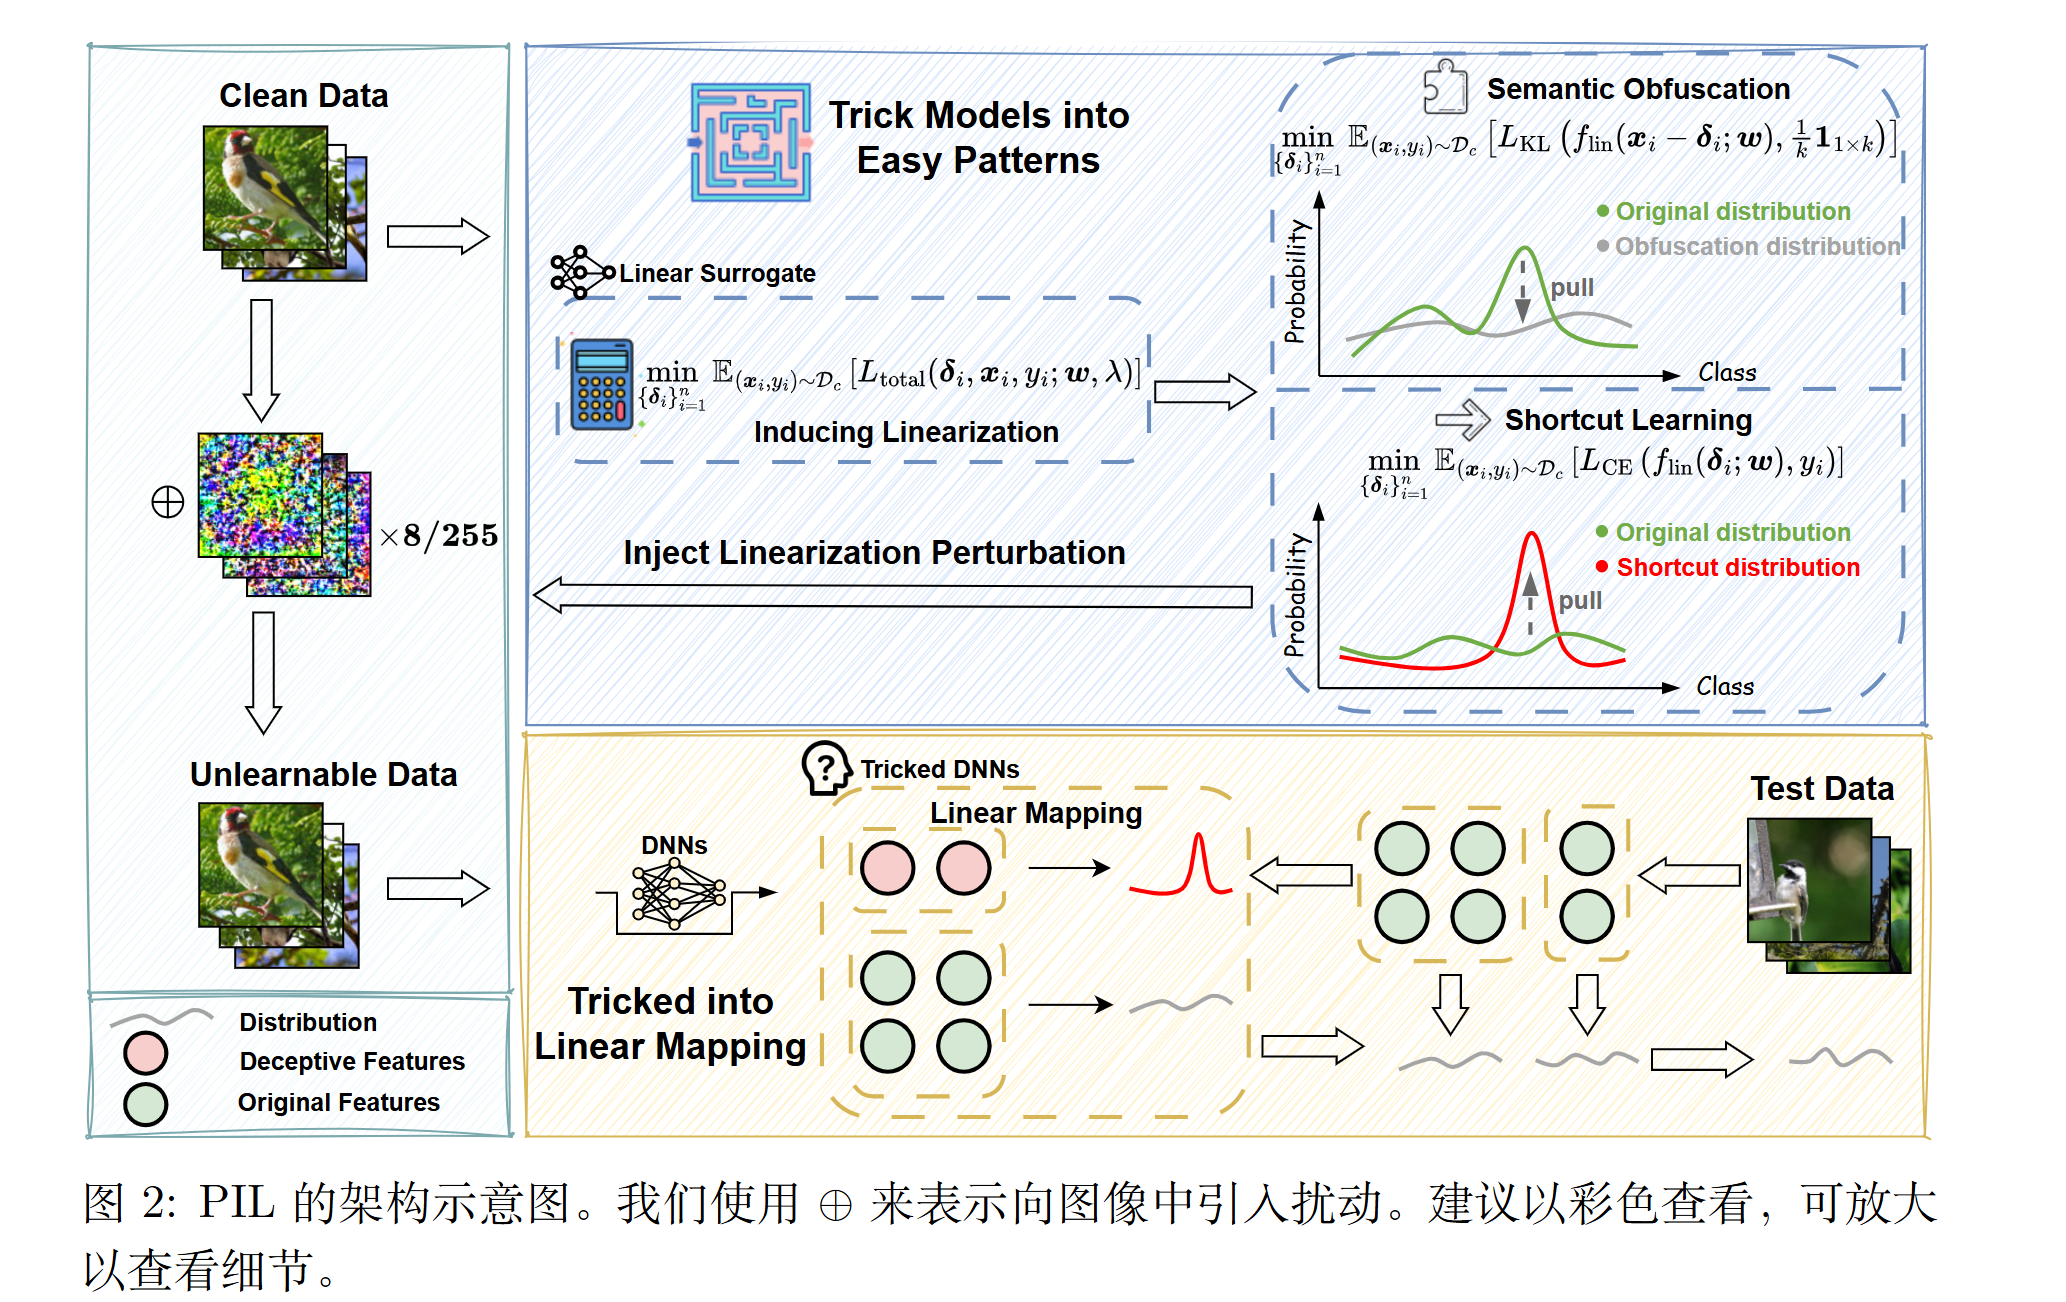
PIL 的核心思想是:设计一种特定的微小扰动,迫使复杂的深度神经网络在训练时“偷懒”,放弃学习图像原本的复杂语义特征,转而学习一种简单的线性映射。
为了实现这一目标,作者在一个标准的攻击者-防御者“双层优化(Bilevel Optimization)”框架下,完全依赖一个简单的无偏置线性分类器来指导扰动的生成。
1. 基础设定与线性代理模型
假设干净的训练数据集为 $\mathcal{D}c = {(x_i, y_i)} _ {i=1}^n$,类别数为 $k$。防御者的目标是为每张图片 $x_i$ 生成一个极其微小的扰动 $\delta_i$(满足无穷范数约束 $||\delta_i||\infty \le 8/255$),构建不可学习的数据集 $\mathcal{D}_u$。
PIL 采用了一个极为简单的无偏置线性分类器作为代理模型,其定义为:
$$f _ {lin}(x; w) = xw$$
其中 $w$ 是模型的权重参数。
2. 扰动生成的两大核心目标
在概念上,PIL 将生成的扰动 $\delta_i$ 视作由两部分组成($\delta_i = \delta_i^1 + \delta_i^2$),它们分别承担不同的任务:
目标一:语义混淆 (Semantic Obfuscation)
为了让模型学不到有用的原图信息,PIL 试图将原图的语义信息“抹平”。具体做法是,要求输入图像在经过某种混淆操作后,线性分类器给出的预测结果趋近于均匀分布(即模型完全分不清这是哪一类)。 这一目标通过最小化 KL 散度(Kullback-Leibler divergence)来实现:
$$\arg\min _ {\{\delta_i\} _ {i=1}^n} \mathbb{E} _ {(x_i, y_i) \sim \mathcal{D}_c}[L _ {KL}(f _ {lin}(x_i - \delta_i; w), \frac{1}{k}\mathbb{1} _ {1\times k})]$$
(注:这里 $\frac{1}{k}\mathbb{1} _ {1\times k}$ 代表各个类别的概率均为 $1/k$ 的均匀分布)。
目标二:捷径学习 (Shortcut Learning)
为了让模型更愿意“偷懒”,扰动本身必须包含极易学习的、与标签强相关的信号,充当训练的“捷径”。 这一目标通过要求线性模型能够直接从扰动 $\delta_i$ 中准确预测出真实标签 $y_i$ 来实现,即最小化交叉熵损失(Cross-Entropy loss):
$$\arg\min _ {\{\delta_i\} _ {i=1}^n} \mathbb{E} _ {(x_i, y_i) \sim \mathcal{D}_c}[L _ {CE}(f _ {lin}(\delta_i; w), y_i)]$$
。
3. 统一优化的损失函数
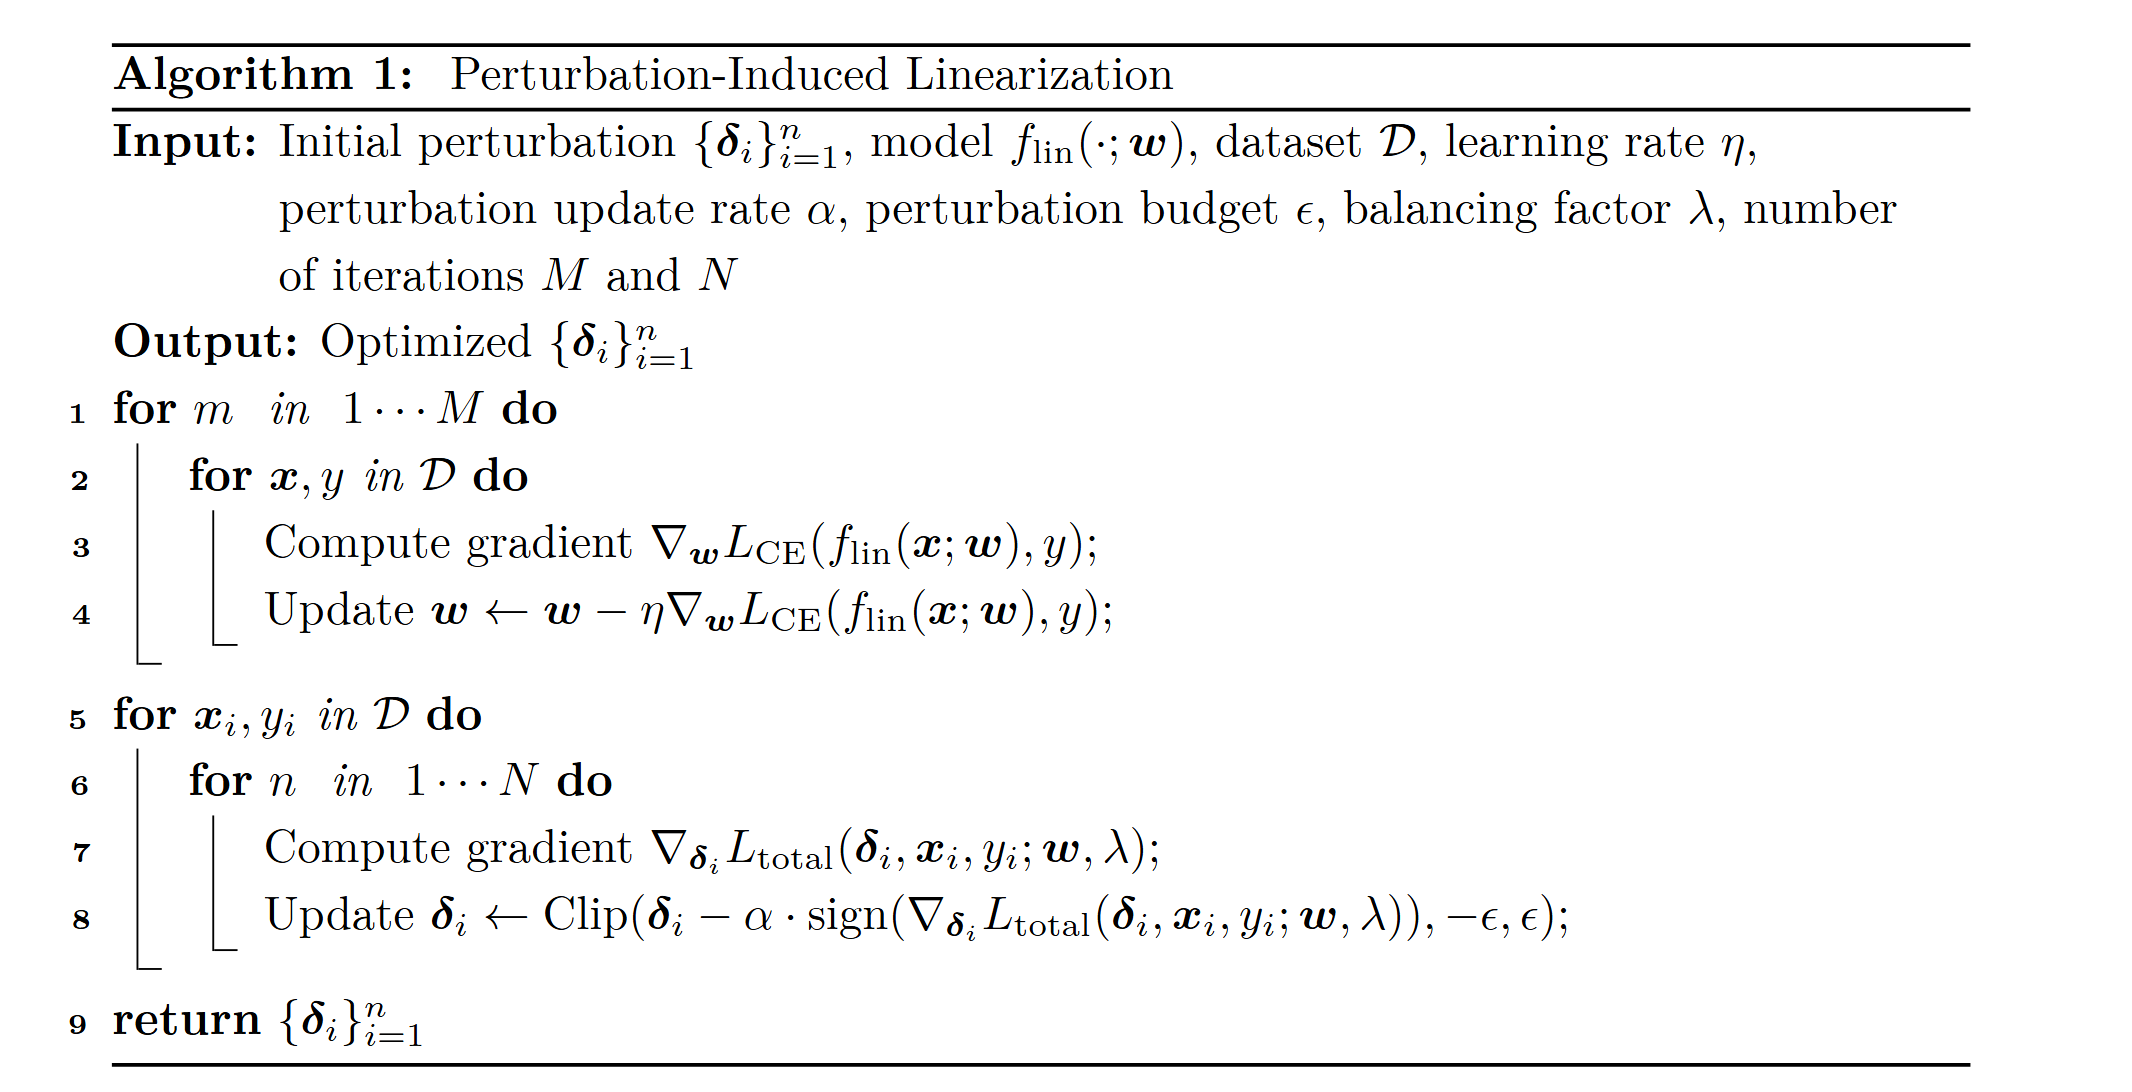
在实际操作中,PIL 并不会真的去分别计算两个扰动,而是将上述两个目标结合成一个统一的损失函数,使用平衡参数 $\lambda$ 来控制二者的权重(实验中通常取 $\lambda = 0.9$):
$$L _ {total}(\delta, x, y; w, \lambda) = \lambda L _ {CE}(f _ {lin}(\delta; w), y) + (1 - \lambda) L _ {KL}(f _ {lin}(x - \delta; w), \frac{1}{k}\mathbb{1} _ {1\times k})$$
。
防御者需要通过类似 PGD(投影梯度下降)的方法,不断迭代更新 $\delta_i$ 以最小化这个 $L _ {total}$ 损失,并确保扰动大小被限制在不可见的范围内($\le \epsilon$)。
4. 数据集的最终构建与巧妙设计
当得到最优扰动 $\delta_i^$ 后,不可学习数据集 $\mathcal{D}_u$ 的构建方式非常巧妙,是*原图减去扰动:
$$\mathcal{D}_u = {(x_i - \delta_i^*, y_i)} _ {i=1}^n$$
。
为什么要相减而不是相加?
因为当目标模型(即攻击者使用的深度网络)在被诱导表现出线性特征时,它对这张图像的输出可以被线性分解为:
$$f _ {lin}(x_i - \delta_i^; w) = f _ {lin}(x_i - \delta_i^{1}; w) + f _ {lin}(-\delta_i^{2*}; w)$$
。 根据前面的优化目标,等式右侧的第一项趋近于均匀分布(不含有效信息);而第二项则由于负号的存在,迫使目标网络去捕捉扰动 $\delta^$ 与标签 $y$ 之间的*负相关关系,而不是原图 $x$ 与标签之间的语义关系。
通过这一套流程,PIL 在极短的时间内(由于只需计算简单的线性模型梯度)就能生成让复杂深度神经网络陷入瘫痪的有效扰动。