Harnessing the Universal Geometry of Embeddings
(NIPS 2025)
引言
不依赖任何配对数据,纯粹通过学习两个嵌入空间(Embedding Spaces)之间的几何映射关系,来实现向量的无监督转换。
柏拉图表示假设 (Platonic Representation Hypothesis)
柏拉图表示假设最初是一个关于神经网络内部表征收敛性的猜想。
- 核心内容:该假设推测,现代神经网络的表示空间(representation spaces)正在趋于收敛。具体而言,它最初提出,所有达到足够规模的图像模型都拥有相同的潜在表示(latent representation)。
- 哲学隐喻:这个命名借用了古希腊哲学家柏拉图的“理念论”(Theory of Forms),暗示无论现实世界中有多少种不同的模型和架构,它们最终都在试图捕捉现实数据背后那个统一的、完美的“理念”或内在几何结构。
强文本表示柏拉图假设 (Strong Platonic Representation Hypothesis)
这篇论文的作者在原版假设的基础上,针对文本模型提出并验证了一个更强、更具建设性的版本,即强文本表示柏拉图假设。
- 核心内容:该假设认为,只要神经网络使用相同的目标和模态(例如都是处理文本)进行训练,即使它们的训练数据和模型架构各不相同,它们也会收敛到一个普遍的(universal)潜在空间。
- 可操作性(建设性):这是“强”假设最关键的一点。它不仅认为这种普遍的潜在结构是存在的,而且断言这种结构是可以被学习到的,并且能够被利用在没有任何配对数据或编码器介入的情况下,将表示从一个模型的空间翻译到另一个模型的空间。
方法
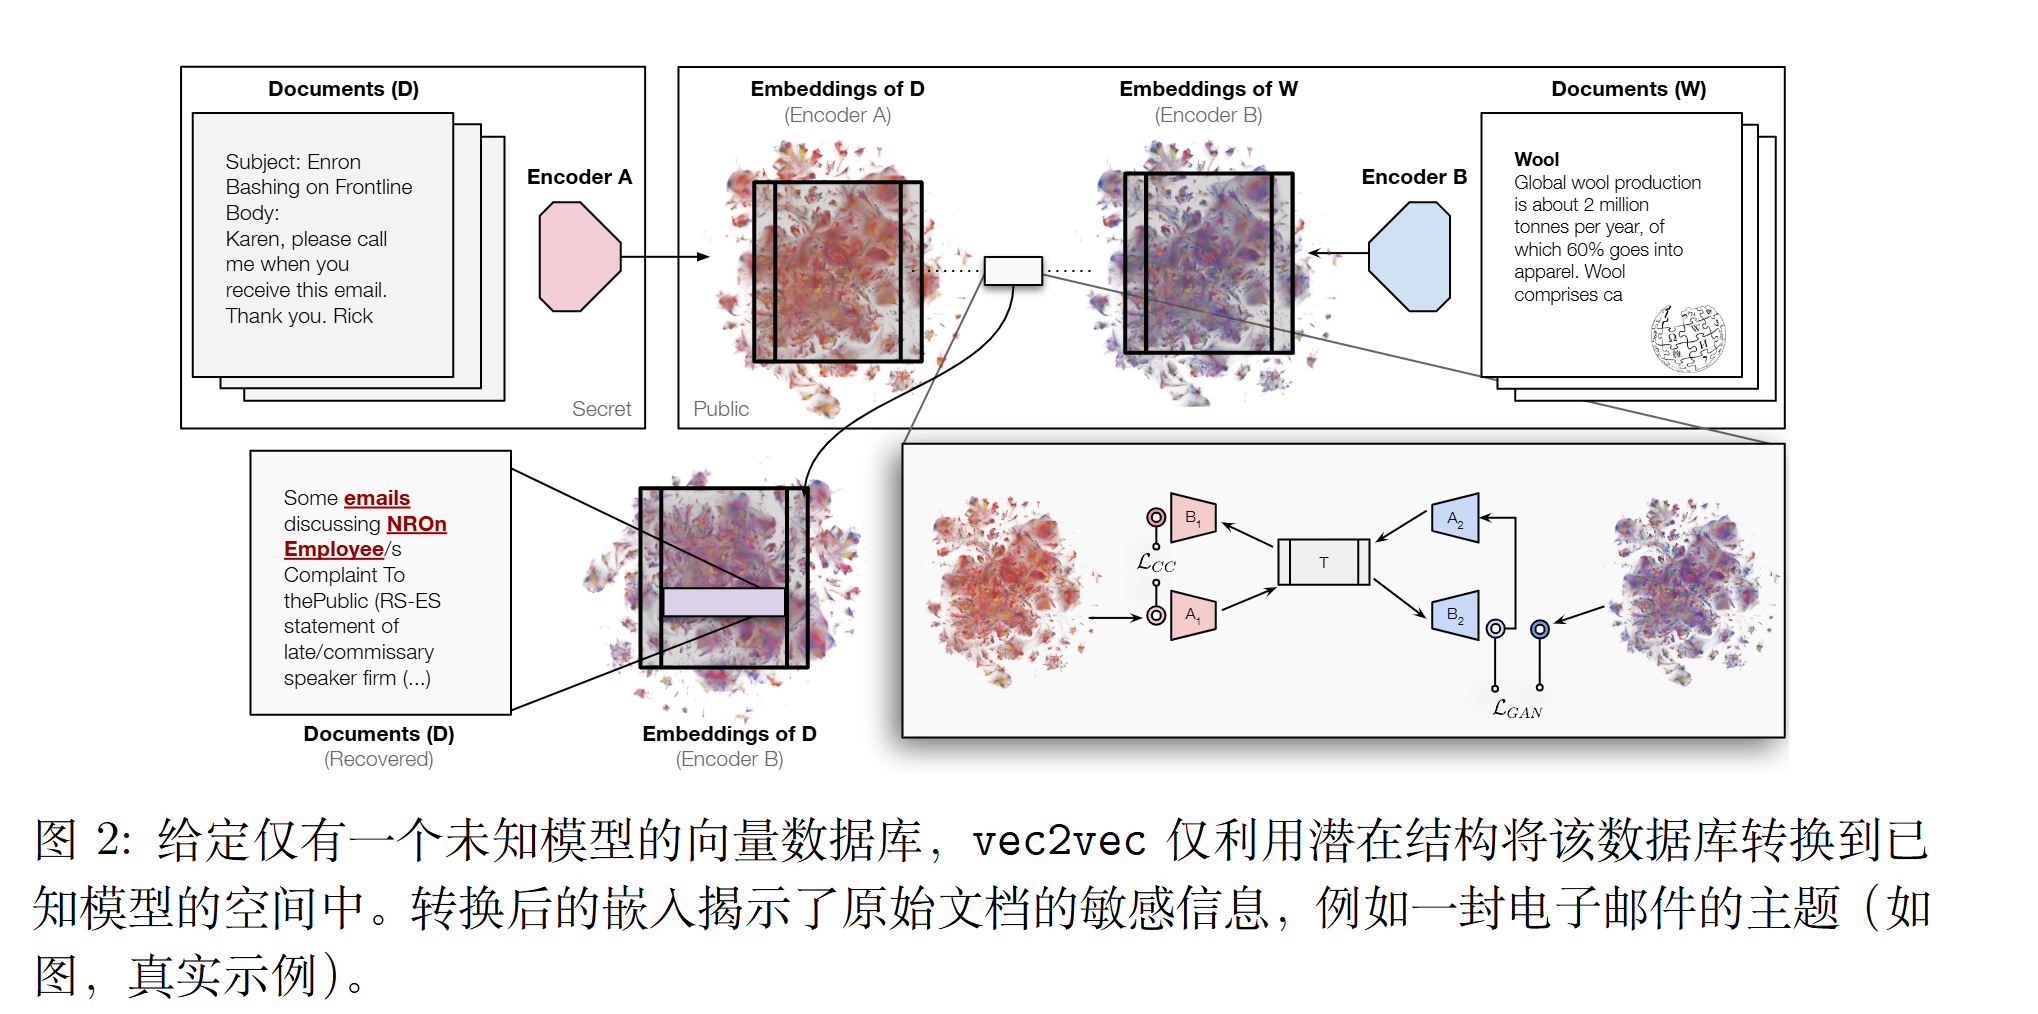
vec2vec 的架构由特定空间的适配器(Adapters)和共享的主干网络(Backbone)组成:
- 输入适配器:将来自不同模型($M_1$ 和 $M_2$)的原始维度为 $d$ 的嵌入向量,映射到一个维度为 $Z$ 的通用潜在空间中。 $A _ {1}:\mathbb{R}^{d}\rightarrow\mathbb{R}^{Z}$ 以及 $A _ {2}:\mathbb{R}^{d}\rightarrow\mathbb{R}^{Z}$
- 共享主干网络:在潜在空间中提取公共的潜在嵌入特征。 $T:\mathbb{R}^{Z}\rightarrow\mathbb{R}^{Z}$
- 输出适配器:将通用潜在表示解码回各自特定的向量空间中。 $B _ {1}:\mathbb{R}^{Z}\rightarrow\mathbb{R}^{d}$ 以及 $B _ {2}:\mathbb{R}^{Z}\rightarrow\mathbb{R}^{d}$
基于上述模块,模型的转换函数(跨空间映射,即 $F_1$ 和 $F_2$)和重构函数(同空间映射,即 $R_1$ 和 $R_2$)定义如下:
$$F _ {1}=B _ {2}\circ T\circ A _ {1}$$
$$F _ {2}=B _ {1}\circ T\circ A _ {2}$$
$$R _ {1}=B _ {1}\circ T\circ A _ {1}$$
$$R _ {2}=B _ {2}\circ T\circ A _ {2}$$
2. 整体优化目标
模型所有组件的参数集合记为 $\theta={A _ {1},A _ {2},T,B _ {1},B _ {2}}$。优化的总体目标是在对抗损失($\mathcal{L} _ {adv}$)和生成器约束损失($\mathcal{L} _ {gen}$)之间寻找平衡,通过极小极大博弈(Minimax)来求解最优参数 $\theta^{*}$:
$$\theta^{*}=arg~\min _ {\theta}\max _ {D _ {1},D _ {2},D _ {1}^{l},D _ {2}^{l}}\mathcal{L} _ {adv}(F _ {1},F _ {2},D _ {1},D _ {2},D _ {1}^{l},D _ {2}^{l})+\lambda _ {gen}\mathcal{L} _ {gen}(\theta)$$
3. 生成器的三大关键约束损失 ($\mathcal{L} _ {gen}$)
单纯的对抗损失无法保证转换后的向量保留原始文本的语义,因此研究团队为生成器引入了三个关键的约束条件,这也是无监督学习成功的关键:
重构损失 (Reconstruction Loss):强制要求一个向量在被映射到潜在空间后,再解码回其原始空间时,应与其初始状态高度一致。这里 $p$ 和 $q$ 分别代表两个不同模型空间的向量分布。
$$\mathcal{L} _ {rec}(R _ {1},R _ {2})=\mathbb{E} _ {x\sim p}\vert{}\vert{}R _ {1}(x)-x\vert{}\vert{} _ {2}^{2}+\mathbb{E} _ {y\sim q}\vert{}\vert{}R _ {2}(y)-y\vert{}\vert{} _ {2}^{2}$$
循环一致性损失 (Cycle-Consistency Loss):作为缺乏监督配对数据时的替代方案,它确保向量被转换到目标空间后再转换回来,能够恢复原样,使信息损坏降到最低。
$$\mathcal{L} _ {CC}(F _ {1},F _ {2})=\mathbb{E} _ {x\sim p}\vert{}\vert{}F _ {2}(F _ {1}(x))-x\vert{}\vert{} _ {2}^{2}+\mathbb{E} _ {y\sim q}\vert{}\vert{}F _ {1}(F _ {2}(y))-y\vert{}\vert{} _ {2}^{2}$$
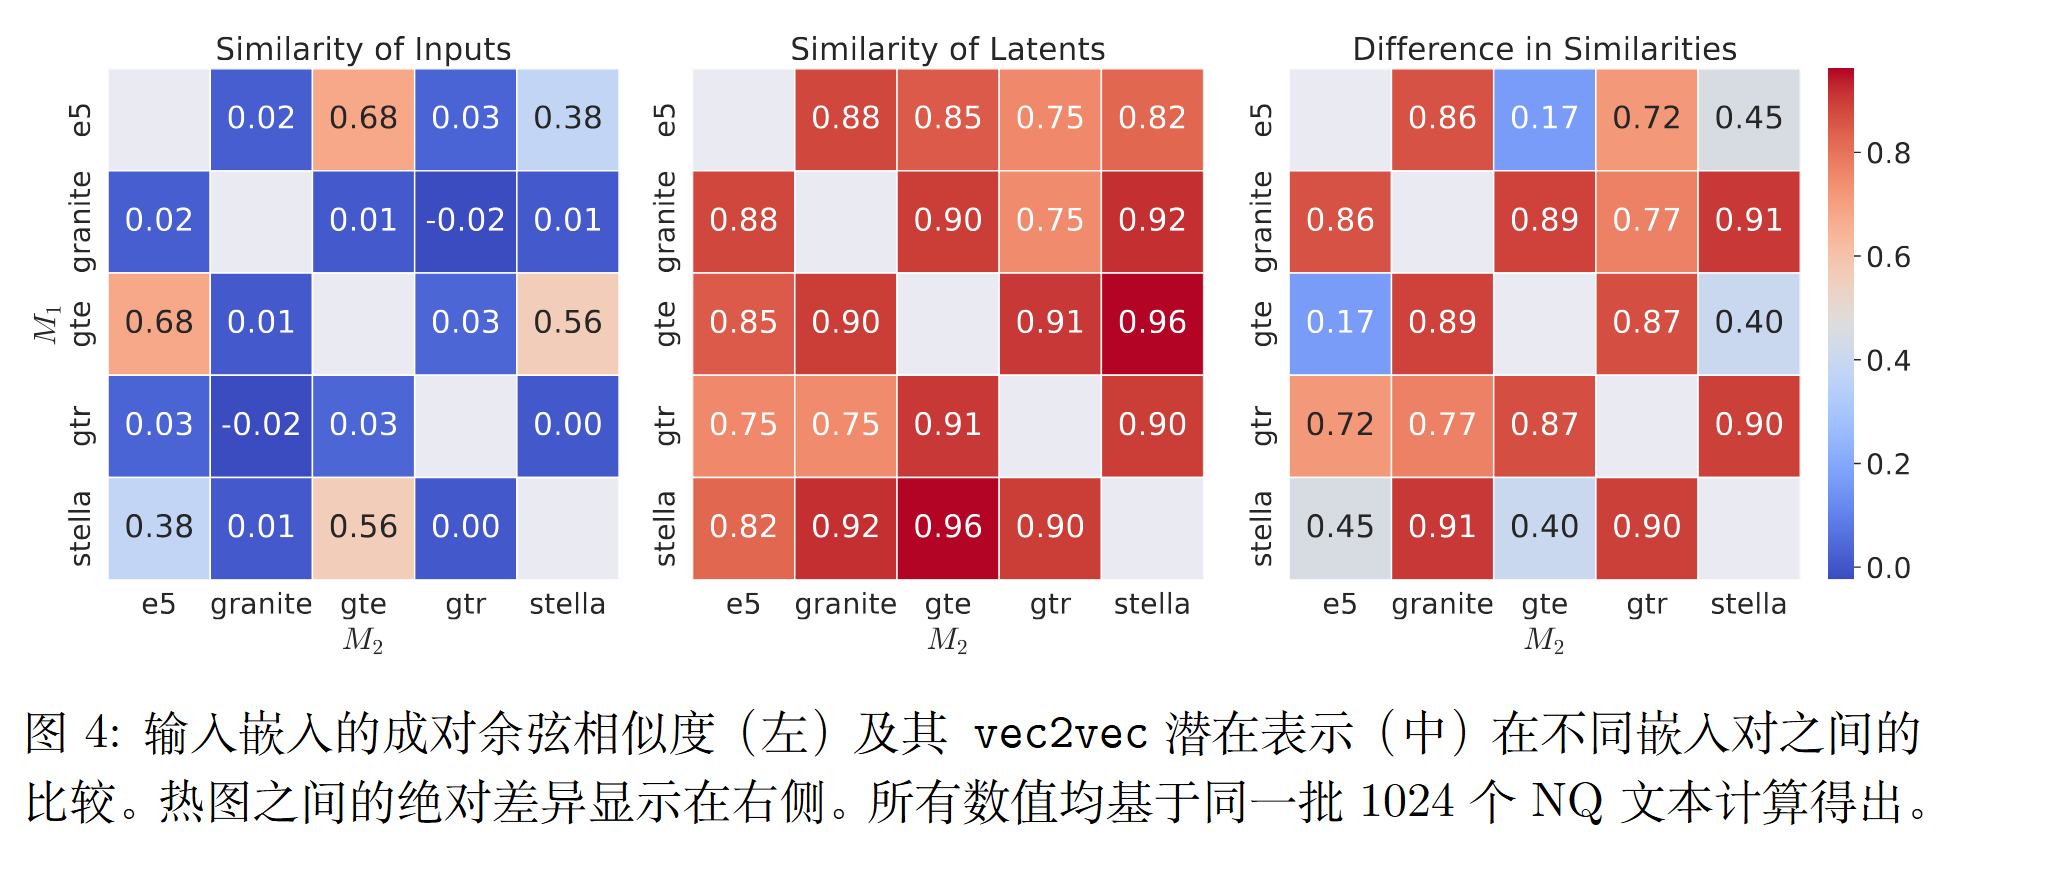
向量空间保持损失 (Vector Space Preservation - VSP):这是确保语义结构不被破坏的最重要几何约束。它要求在一批(Batch 大小为 $B$)向量中,任意两个向量转换前的点积(代表余弦相似度),必须等于它们转换后的点积。
$$\mathcal{L} _ {VSP}(F _ {1},F _ {2})=\frac{1}{B}\sum _ {i=1}^{B}\sum _ {j=1}^{B}[\vert{}\vert{}M _ {1}(x _ {i})\cdot M _ {1}(x _ {j})-F _ {1}(M _ {1}(x _ {i}))\cdot F _ {1}(M _ {1}(x _ {j}))\vert{}\vert{} _ {2}^{2}+\vert{}\vert{}M _ {2}(y _ {i})\cdot M _ {2}(y _ {j})-F _ {2}(M _ {2}(y _ {i}))\cdot F _ {2}(M _ {2}(y _ {j}))\vert{}\vert{} _ {2}^{2}]$$
生成器的总损失由这三项加权求和得出:
$$\mathcal{L} _ {gen}(\theta)=\lambda _ {rec}\mathcal{L} _ {rec}(R _ {1},R _ {2})+\lambda _ {CC}\mathcal{L} _ {CC}(F _ {1},F _ {2})+\lambda _ {VSP}\mathcal{L} _ {VSP}(F _ {1},F _ {2})$$
4. 双层对抗性损失 ($\mathcal{L} _ {adv}$)
为了让生成的转换向量尽可能逼真,vec2vec 使用了标准的 GAN 损失框架,但特别之处在于它在两个层级上同时应用了判别器:
- 嵌入层级判别器($D_1$ 和 $D_2$):区分真实的嵌入向量与生成的嵌入向量。
- 潜在层级判别器($D_1^l$ 和 $D_2^l$):在通用潜在空间内(即 $Z$ 维度空间),迫使来自两个不同模型的特征分布相互对齐、难以区分。
实验
依次在NVIDIA 2080Ti、L4、A40 和 A100 GPU 上执行,这些 GPU 按计算容量递增排列。
这总计约为180个GPU天(45个模型*4天/模型)。